
Trả lời nhanh: MLOps (Machine Learning Operations) là tập hợp thực hành kết hợp học máy với DevOps để đưa mô hình từ notebook vào chạy ổn định: quản lý phiên bản dữ liệu và mô hình, tự động hoá huấn luyện, triển khai, giám sát độ lệch dữ liệu (drift) và huấn luyện lại khi chất lượng giảm.
Điểm chính
- MLOps giải quyết khoảng cách giữa mô hình chạy được trên máy một người và mô hình phục vụ người dùng thật, có theo dõi và có thể tái lập.
- Khác biệt cốt lõi so với DevOps: phải quản lý thêm dữ liệu và mô hình, và hệ thống có thể xuống cấp mà không có lỗi code nào.
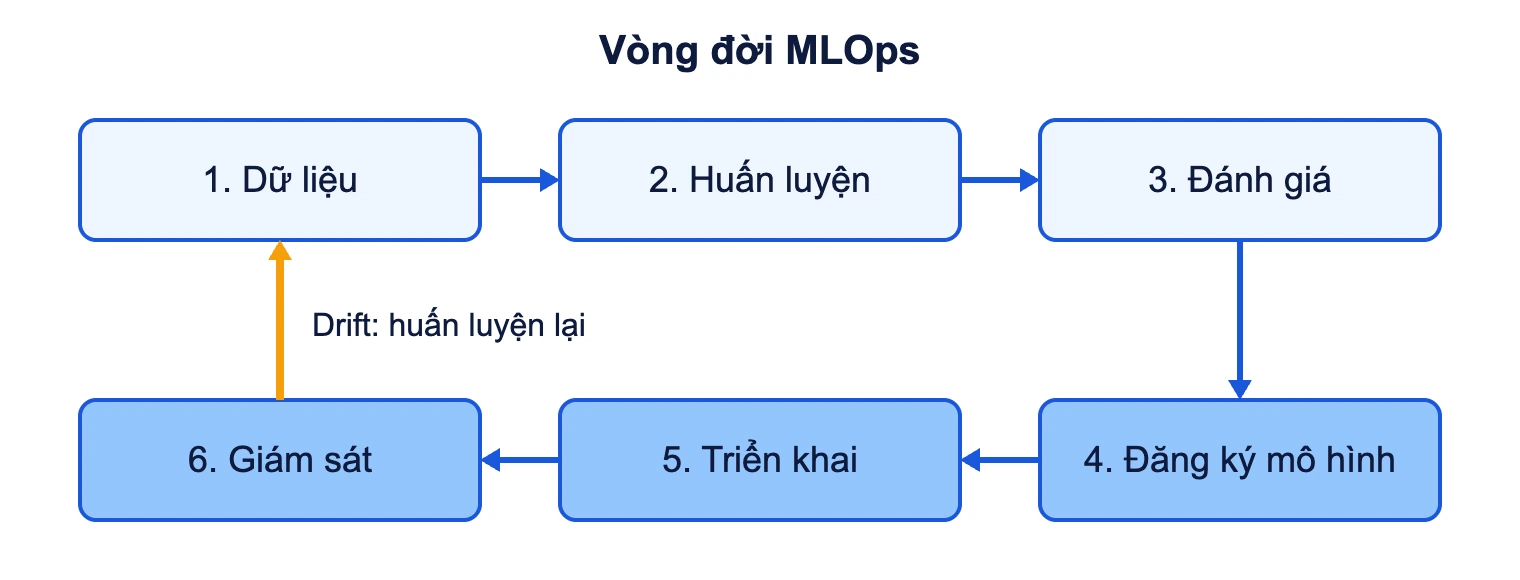
- Vòng đời gồm dữ liệu, huấn luyện, đánh giá, đăng ký, triển khai, giám sát, rồi quay lại huấn luyện.
- Với mô hình ngôn ngữ lớn, MLOps mở rộng thành LLMOps: quản lý prompt, bộ đánh giá, chi phí token và hàng rào an toàn.
- Không phải doanh nghiệp nào cũng cần nền tảng đầy đủ; mức đầu tư phụ thuộc số mô hình và tốc độ dữ liệu thay đổi.
Mục lục
- MLOps là gì và vì sao thuật ngữ này xuất hiện?
- Vì sao mô hình tốt lúc thử nghiệm lại xuống cấp khi chạy thật?
- Vòng đời MLOps gồm những bước nào?
- Các thành phần kỹ thuật của một nền tảng MLOps
- Các mức trưởng thành MLOps: bạn đang ở đâu?
- MLOps khác DevOps, DataOps và LLMOps thế nào?
- LLMOps: MLOps cho mô hình ngôn ngữ lớn khác ở đâu?
- MLOps ứng dụng thế nào ở doanh nghiệp Việt Nam?
- Khi nào cần đầu tư MLOps, khi nào chưa?
- Ưu điểm và hạn chế của MLOps
- Những lỗi thường gặp khi triển khai MLOps
- Câu hỏi thường gặp
MLOps là gì và vì sao thuật ngữ này xuất hiện?
MLOps là từ ghép của “machine learning” và “operations”. Nó mô tả cách một tổ chức biến mô hình học máy thành một dịch vụ có vòng đời rõ ràng: có người biết mô hình nào đang chạy, được huấn luyện từ dữ liệu nào, đạt chất lượng bao nhiêu và khi nào cần thay.
Thuật ngữ này sinh ra từ một thực tế mà nhóm kỹ sư Google mô tả trong bài báo “Hidden Technical Debt in Machine Learning Systems” (NeurIPS 2015): phần code của thuật toán chỉ là một ô nhỏ trong hệ thống học máy thực tế. Xung quanh nó là thu thập dữ liệu, kiểm tra dữ liệu, trích xuất đặc trưng, hạ tầng phục vụ và giám sát. Những phần này sinh ra “nợ kỹ thuật” nếu làm thủ công.
Nếu bạn mới làm quen với bước tạo mô hình, hãy đọc trước bài về học có giám sát. MLOps bắt đầu từ lúc mô hình đã có kết quả thử nghiệm tạm ổn và bạn phải trả lời câu hỏi: làm sao để nó chạy hằng ngày mà không cần người ngồi cạnh?
Vì sao mô hình tốt lúc thử nghiệm lại xuống cấp khi chạy thật?
Phần mềm thông thường chỉ hỏng khi code hoặc hạ tầng đổi. Mô hình học máy có thể hỏng khi không ai đổi gì, vì thế giới đổi. Ba hiện tượng thường gặp:
- Data drift (trôi dữ liệu đầu vào): phân phối đầu vào khác lúc huấn luyện. Ví dụ minh hoạ: mô hình dự báo nhu cầu được huấn luyện trên dữ liệu bán hàng trước đợt khuyến mãi lớn, sau đó cơ cấu khách hàng đổi hẳn.
- Concept drift (trôi khái niệm): mối quan hệ giữa đầu vào và kết quả đổi. Ví dụ minh hoạ: hành vi gian lận thẻ thay đổi sau khi kẻ gian đổi chiêu, nên dấu hiệu cũ không còn đúng.
- Training-serving skew (lệch giữa huấn luyện và phục vụ): đặc trưng được tính một cách khi huấn luyện (bằng SQL trên kho dữ liệu) và một cách khác khi chạy thật (bằng code ứng dụng). Mô hình nhận số liệu hơi khác mà không báo lỗi.
Điểm nguy hiểm là mô hình vẫn trả về kết quả, chỉ là kết quả kém dần. Không có cảnh báo lỗi 500 nào để đánh thức ai. Vì vậy giám sát chất lượng dự đoán là một phần bắt buộc của MLOps, không phải phần thêm.
Vòng đời MLOps gồm những bước nào?
Sơ đồ dưới đây là vòng đời phổ biến. Điểm khác với chuỗi phát hành phần mềm là mũi tên quay ngược: giám sát phát hiện drift sẽ kích hoạt huấn luyện lại.
Bước 1: Dữ liệu được đánh phiên bản và kiểm tra
Mỗi lần huấn luyện phải truy ra được đúng ảnh chụp dữ liệu đã dùng. Công cụ như DVC (Data Version Control) lưu băm của tệp dữ liệu cạnh code trong Git. Trước khi huấn luyện, pipeline chạy kiểm tra lược đồ và phân phối, ví dụ cột bắt buộc không được rỗng, giá trị tuổi không âm. Các thư viện như Great Expectations hay TensorFlow Data Validation làm việc này. Để biết dữ liệu đi từ nguồn nào đến bảng huấn luyện, bạn cần thêm truy vết dòng dữ liệu.
Bước 2 và 3: Huấn luyện và đánh giá có ghi lại
Mỗi lần chạy được ghi lại thành một “run” gồm siêu tham số, phiên bản code, phiên bản dữ liệu, chỉ số và tệp mô hình. MLflow Tracking và Weights & Biases là hai ví dụ phổ biến. Bước đánh giá cần một ngưỡng chấp nhận viết trước, đối chiếu với mô hình đang chạy (champion) và mô hình mới (challenger) trên cùng tập kiểm thử, cộng thêm kiểm tra theo nhóm con, chẳng hạn theo khu vực hoặc nhóm khách hàng, vì chỉ số trung bình có thể che lỗi cục bộ.
Bước 4: Đăng ký mô hình
Model registry là kho lưu mô hình đã được duyệt, mỗi bản có số phiên bản, người duyệt, trạng thái (ví dụ staging, production) và liên kết về run đã tạo ra nó. Nhờ đó khi có khiếu nại về một quyết định, bạn biết phiên bản nào đã đưa ra quyết định đó.
Bước 5: Triển khai
Có bốn kiểu phục vụ chính: suy luận hàng loạt (batch) ghi kết quả vào bảng mỗi đêm, API thời gian thực, suy luận luồng (streaming) và chạy trên thiết bị biên. Để giảm rủi ro khi thay phiên bản, đội vận hành dùng chế độ bóng (shadow: mô hình mới nhận cùng yêu cầu nhưng kết quả không dùng) hoặc canary (chuyển vài phần trăm lưu lượng). Các công cụ phục vụ phổ biến gồm KServe, Seldon Core, BentoML; với tải thất thường có thể xem thêm suy luận không máy chủ.
Bước 6: Giám sát
Có hai tầng. Tầng hạ tầng: độ trễ, tỷ lệ lỗi, mức dùng GPU, đo bằng Prometheus và Grafana như dịch vụ thường. Tầng mô hình: phân phối đặc trưng đầu vào, phân phối điểm dự đoán và chất lượng thật khi nhãn về muộn. Để so phân phối, người ta dùng chỉ số như PSI (Population Stability Index) hoặc kiểm định Kolmogorov-Smirnov; Evidently là thư viện mã nguồn mở thường gặp cho việc này. Với nhiều bài toán, nhãn thật chỉ có sau vài tuần (khoản vay có trả đúng hạn không), nên bạn phải theo dõi chỉ báo sớm trong lúc chờ.
Các thành phần kỹ thuật của một nền tảng MLOps
| Thành phần | Việc làm | Ví dụ công cụ |
|---|---|---|
| Quản lý phiên bản dữ liệu | Tái lập được tập huấn luyện | DVC, lakeFS, Delta Lake |
| Feature store | Dùng chung một định nghĩa đặc trưng cho huấn luyện và phục vụ | Feast, Tecton |
| Theo dõi thử nghiệm | Ghi tham số, chỉ số, tệp mô hình | MLflow, Weights & Biases |
| Điều phối pipeline | Chạy chuỗi bước theo lịch hoặc sự kiện | Airflow, Kubeflow Pipelines, Dagster |
| Model registry | Duyệt, gắn phiên bản, chuyển trạng thái | MLflow Model Registry, registry của nền tảng đám mây |
| Phục vụ mô hình | Cung cấp API hoặc chạy batch | KServe, Seldon Core, BentoML |
| Giám sát mô hình | Phát hiện drift, theo dõi chất lượng | Evidently, Prometheus, Grafana |
| CI/CD | Kiểm thử code, dữ liệu, mô hình trước khi phát hành | GitHub Actions, GitLab CI, Jenkins |
Danh sách này chỉ để minh hoạ loại công cụ, không phải khuyến nghị mua. Nhiều đội bắt đầu chỉ với Git, MLflow, một bộ lập lịch và một bảng theo dõi chỉ số, rồi bổ sung khi có nhu cầu thật.
Các mức trưởng thành MLOps: bạn đang ở đâu?
Tài liệu hướng dẫn MLOps của Google Cloud chia mức tự động hoá thành ba mức từ 0 đến 2. Cách chia này dễ dùng để tự đánh giá.
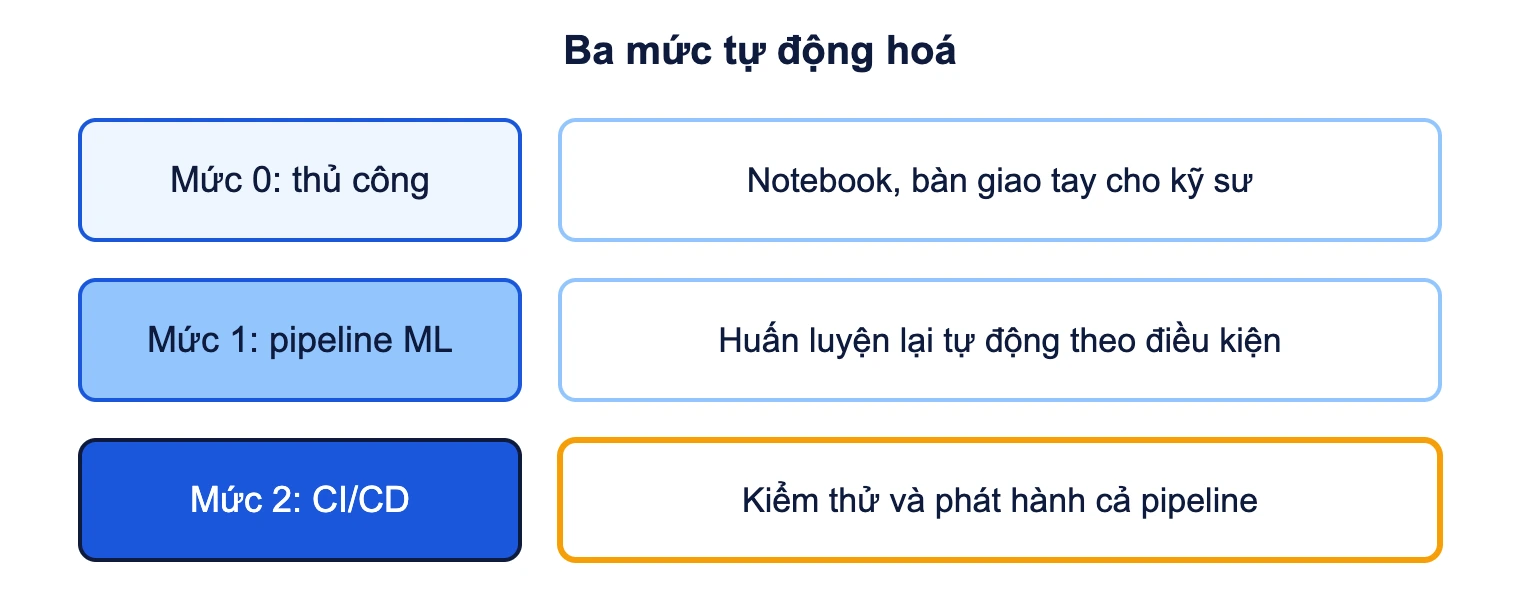
- Mức 0: data scientist huấn luyện trong notebook, xuất tệp mô hình, gửi cho kỹ sư triển khai. Ít lần phát hành, không có giám sát chất lượng. Phù hợp khi bạn chỉ có một hai mô hình cập nhật vài lần mỗi năm.
- Mức 1: bước huấn luyện thành pipeline tự động, kèm kiểm tra dữ liệu và đánh giá mô hình. Pipeline chạy lại theo lịch hoặc khi giám sát báo drift. Đây là bước nhảy giá trị nhất với đa số doanh nghiệp.
- Mức 2: chính code của pipeline cũng được kiểm thử và phát hành tự động qua CI/CD. Thường thấy ở đội có nhiều mô hình và nhiều người cùng sửa pipeline.
MLOps khác DevOps, DataOps và LLMOps thế nào?
| Tiêu chí | DevOps | DataOps | MLOps | LLMOps |
|---|---|---|---|---|
| Đối tượng quản lý | Code, hạ tầng | Pipeline và chất lượng dữ liệu | Code, dữ liệu, mô hình | Prompt, mô hình nền, ngữ cảnh truy xuất |
| Cách kiểm thử | Đúng hoặc sai theo test | Quy tắc chất lượng dữ liệu | Chỉ số thống kê trên tập kiểm thử | Bộ câu hỏi chuẩn, chấm tự động và chấm tay |
| Nguyên nhân xuống cấp | Đổi code hoặc hạ tầng | Nguồn dữ liệu đổi | Drift dữ liệu và khái niệm | Nhà cung cấp cập nhật mô hình, tài liệu nguồn lỗi thời |
| Chi phí chạy | CPU, bộ nhớ | Lưu trữ, tính toán | GPU khi huấn luyện, CPU hoặc GPU khi phục vụ | Token hoặc GPU suy luận theo từng yêu cầu |
DevOps là nền móng: MLOps dùng lại Git, CI/CD, container và Kubernetes. DataOps lo dòng dữ liệu sạch và đúng hạn, là đầu vào của MLOps. MLOps thêm hai thứ DevOps không có: tính tái lập theo dữ liệu và giám sát chất lượng thống kê.
LLMOps: MLOps cho mô hình ngôn ngữ lớn khác ở đâu?
Khi dùng mô hình ngôn ngữ lớn qua API hoặc tự lưu trữ, phần lớn bạn không huấn luyện mô hình từ đầu. Đối tượng vận hành chuyển sang những thứ khác:
- Prompt và cấu hình: prompt, tham số sinh văn bản, phiên bản mô hình được đánh phiên bản như code, có người duyệt trước khi đổi.
- Bộ đánh giá: vì không có một con số chính xác duy nhất, đội tạo tập câu hỏi kèm đáp án chuẩn từ nghiệp vụ của chính mình và chạy lại mỗi khi đổi prompt hoặc đổi mô hình. Các benchmark công khai chỉ cho biết năng lực chung, không thay được bộ này.
- Chỉ mục truy xuất: với hệ thống RAG, tài liệu nguồn cũ hoặc bị chia nhỏ sai sẽ làm câu trả lời sai. Lịch cập nhật chỉ mục và kiểm tra chất lượng truy xuất là việc vận hành thường xuyên.
- Tracing và chi phí: ghi lại từng bước gọi (truy xuất, gọi công cụ, sinh văn bản), số token và độ trễ. Các công cụ như Langfuse hay LangSmith phục vụ nhu cầu này.
- Hàng rào an toàn: lọc đầu vào và đầu ra, chặn rò rỉ dữ liệu cá nhân; xem thêm hàng rào bảo vệ AI.
- Tinh chỉnh khi cần: nếu đã chứng minh prompt và RAG chưa đủ, mới đến tinh chỉnh mô hình, lúc đó quy trình huấn luyện lại giống MLOps cổ điển.
Rủi ro riêng của LLM nằm ở chỗ nhà cung cấp có thể ngừng hỗ trợ hoặc cập nhật một phiên bản mô hình. Cùng một prompt có thể cho kết quả khác sau cập nhật, nên bộ đánh giá cần chạy lại khi đổi phiên bản.
MLOps ứng dụng thế nào ở doanh nghiệp Việt Nam?
Các ví dụ dưới đây là ví dụ minh hoạ, không phải số liệu của doanh nghiệp cụ thể.
- Ngân hàng, tài chính tiêu dùng: mô hình chấm điểm tín dụng cần lưu phiên bản và dữ liệu huấn luyện để giải trình khi khách khiếu nại. Giám sát PSI theo từng kỳ giúp phát hiện cơ cấu khách thay đổi sau chiến dịch mở thẻ mới.
- Bán lẻ, thương mại điện tử: mô hình dự báo nhu cầu theo SKU chạy batch hằng đêm. Dịp khuyến mãi lớn, drift xảy ra nhanh nên cần huấn luyện lại theo điều kiện thay vì theo lịch cố định.
- Trung tâm chăm sóc khách hàng: trợ lý trả lời dùng LLM và RAG cần bộ câu hỏi chuẩn lấy từ lịch sử ticket, chạy lại sau mỗi lần cập nhật chính sách.
Về pháp lý, huấn luyện trên dữ liệu khách hàng chịu Luật Bảo vệ dữ liệu cá nhân. Điểm áp dụng với MLOps là lưu được nguồn và mục đích của từng tập dữ liệu huấn luyện; khung quản trị rộng hơn nằm ở bài quản trị dữ liệu. Nếu hệ thống dùng dữ liệu nhạy cảm, hãy rà soát với bộ phận pháp chế.
Khi nào cần đầu tư MLOps, khi nào chưa?
Ma trận dưới đây giúp bạn ước lượng mức đầu tư theo hai yếu tố: số mô hình đang phục vụ thật và tốc độ dữ liệu thay đổi.
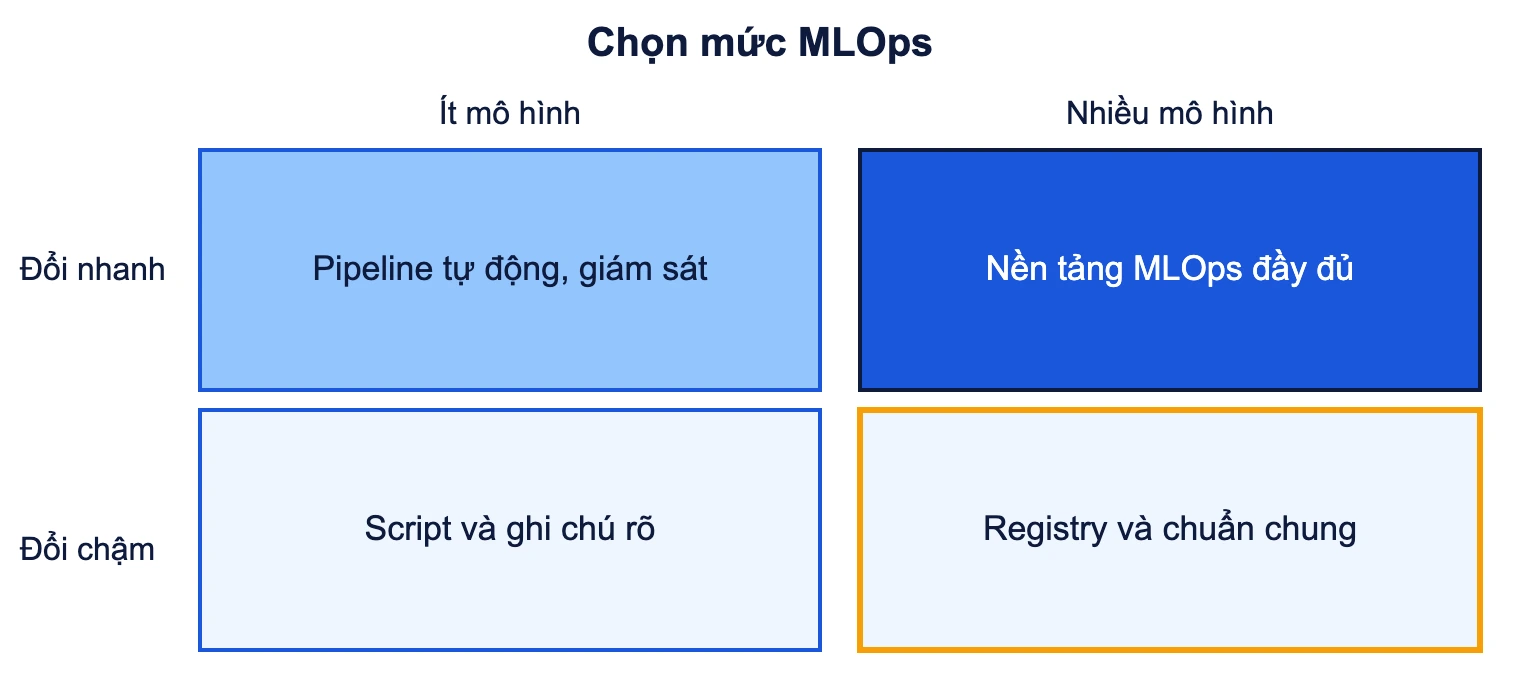
Nên đầu tư sớm khi mô hình ảnh hưởng trực tiếp đến tiền hoặc quyền lợi khách hàng, khi dữ liệu thay đổi theo mùa hoặc theo chiến dịch, hoặc khi hơn một nhóm cùng sửa mô hình và hay giẫm chân nhau.
Chưa cần nền tảng đầy đủ khi mô hình chỉ phục vụ báo cáo nội bộ chạy theo quý, khi kết quả luôn được người xem lại trước khi dùng, hoặc khi bạn mới đang kiểm chứng xem bài toán có giải được bằng học máy hay không. Lúc đó, một kho Git, tệp ghi chú về dữ liệu và một lịch kiểm tra thủ công hằng tháng là đủ.
Ưu điểm và hạn chế của MLOps
| Ưu điểm | Hạn chế |
|---|---|
| Tái lập được kết quả và truy vết được quyết định của mô hình | Cần kỹ năng kết hợp dữ liệu, phần mềm và hạ tầng, nhân lực khan hiếm |
| Phát hiện sớm mô hình xuống cấp | Chi phí xây và bảo trì pipeline, kể cả khi mô hình đơn giản |
| Rút ngắn thời gian từ thử nghiệm đến phát hành | Dễ quá phức tạp nếu dùng bộ công cụ lớn cho bài toán nhỏ |
| Hỗ trợ kiểm toán và giải trình | Giám sát chất lượng vẫn cần nhãn thật, mà nhãn thường đến muộn |
Những lỗi thường gặp khi triển khai MLOps
- Tính đặc trưng hai nơi hai cách. Dấu hiệu: chỉ số kiểm thử cao nhưng chạy thật kém ngay tuần đầu. Cách xử lý: dùng chung một định nghĩa đặc trưng (feature store hoặc thư viện dùng chung) và so sánh phân phối đặc trưng giữa hai môi trường.
- Chỉ giám sát độ trễ và lỗi. Dịch vụ xanh nhưng dự đoán lệch. Cách xử lý: thêm giám sát phân phối điểm dự đoán và, khi nhãn về, chỉ số chất lượng.
- Huấn luyện lại tự động nhưng không có cổng duyệt. Mô hình mới tệ hơn vẫn lên production. Cách xử lý: đặt ngưỡng so với mô hình đang chạy và cho phép quay về phiên bản trước bằng một thao tác trong registry.
- Không lưu phiên bản dữ liệu. Không tái lập được mô hình cũ khi có khiếu nại. Cách xử lý: lưu băm hoặc ảnh chụp dữ liệu cho mỗi lần huấn luyện.
- Dùng dữ liệu cá nhân trong môi trường thử nghiệm không kiểm soát. Cách xử lý: ẩn danh hoặc giả danh hoá trước khi đưa vào notebook, phân quyền theo vai trò.
Câu hỏi thường gặp
MLOps là gì, nói ngắn gọn?
Là cách tổ chức công việc và công cụ để mô hình học máy được huấn luyện, phát hành, theo dõi và cập nhật như một sản phẩm vận hành thật, thay vì một tệp chạy được trên máy của người làm ra nó.
MLOps có giống DevOps không?
MLOps kế thừa DevOps (Git, CI/CD, container) nhưng thêm quản lý dữ liệu, mô hình và giám sát thống kê. Hệ thống học máy có thể xuống cấp khi dữ liệu đổi dù code giữ nguyên, điều mà DevOps thuần không theo dõi.
Ai làm MLOps trong doanh nghiệp?
Thường là kỹ sư học máy (ML engineer) hoặc kỹ sư MLOps phối hợp với data scientist, kỹ sư dữ liệu và đội hạ tầng. Ở đội nhỏ, một người có thể kiêm nhiều vai, miễn phần việc phát hành và giám sát có người nhận rõ.
LLMOps có phải là MLOps không?
LLMOps là nhánh của MLOps cho ứng dụng dùng mô hình ngôn ngữ lớn. Trọng tâm chuyển sang quản lý prompt, bộ đánh giá, chỉ mục truy xuất, chi phí token và hàng rào an toàn, vì phần lớn doanh nghiệp không tự huấn luyện mô hình nền.
Có cần Kubernetes mới làm được MLOps không?
Không bắt buộc. Kubernetes phổ biến vì khả năng mở rộng, nhưng bạn có thể chạy pipeline bằng bộ lập lịch như Airflow trên máy chủ thường, hoặc dùng dịch vụ quản lý của nhà cung cấp đám mây. Chọn theo quy mô và năng lực vận hành của đội.
Bắt đầu học MLOps từ đâu?
Nắm vững Git và Docker, làm quen một công cụ theo dõi thử nghiệm như MLflow, rồi tự dựng một pipeline nhỏ gồm kiểm tra dữ liệu, huấn luyện, đánh giá và một API phục vụ. Sau đó thêm giám sát drift cho chính mô hình đó.
Bài viết thuộc chuyên mục AI tạo sinh & LLM trên VBPO Tech Blog, trang tin tức và kiến thức công nghệ cho doanh nghiệp Việt Nam về AI, dữ liệu, blockchain, chuyển đổi số và tự động hoá.