
Trả lời nhanh: Không có mô hình AI tốt nhất cho mọi việc. GPT mạnh ở hệ sinh thái, Claude thường được chọn cho lập trình và tài liệu dài, Gemini gắn với Google, Llama và DeepSeek cho phép tự triển khai. Hãy so sánh theo chi phí mỗi tác vụ, dữ liệu và chất lượng tiếng Việt trên dữ liệu của bạn.
Điểm chính
- Tên phiên bản và giá đổi theo tuần, nên bài so sánh theo dòng sản phẩm và tiêu chí bền hơn so sánh theo số hiệu.
- Giá mỗi triệu token chưa phải chi phí thật: mô hình suy luận có thể dùng nhiều token hơn nhiều lần cho cùng một việc.
- Điểm benchmark và xếp hạng công khai chỉ để lọc ứng viên, không thay cho việc chấm thử trên dữ liệu của bạn.
- Dữ liệu nhạy cảm quyết định bạn dùng API, đám mây riêng hay mô hình trọng số mở chạy nội bộ.
Mục lục
- Những nhóm mô hình AI nào đang được so sánh nhiều nhất?
- Tháng 10/2026, vì sao bảng xếp hạng nào cũng khác nhau?
- So sánh theo tiêu chí doanh nghiệp cần
- Giá mỗi triệu token có phản ánh chi phí thật không?
- Điểm benchmark và xếp hạng nên đọc thế nào?
- Chọn theo ma trận: độ khó của việc và độ nhạy cảm của dữ liệu
- Mỗi nhóm mô hình hợp với tình huống nào?
- Tiếng Việt: kiểm tra những điểm nào?
- Dữ liệu gửi cho mô hình và điểm pháp lý cần nhớ
- Chấm thử ba ứng viên trên dữ liệu của bạn
- Những sai lầm thường gặp khi chọn mô hình
- Khi nào nên đổi mô hình đang dùng?
- Câu hỏi thường gặp
Những nhóm mô hình AI nào đang được so sánh nhiều nhất?
Người tìm “so sánh các mô hình AI phổ biến” thường muốn biết một câu: dùng cái nào cho việc của mình. Trước hết cần phân biệt nhà cung cấp, dòng mô hình và sản phẩm. Ví dụ, ChatGPT là ứng dụng, còn dòng mô hình GPT là thứ chạy bên dưới. Tương tự với Claude và Gemini. Nền tảng chung của cả nhóm được giải thích trong bài mô hình ngôn ngữ lớn.
Bảng dưới tóm tắt các nhóm phổ biến ở thời điểm 12/10/2026. Nhận xét về thế mạnh là mức khái quát từ đánh giá chung của giới phát triển, bạn cần kiểm lại bằng bài thử riêng ở phần sau.
| Dòng mô hình | Nhà phát triển | Cách truy cập | Thế mạnh thường được nhắc | Điểm cần cân nhắc |
|---|---|---|---|---|
| GPT | OpenAI | API, ChatGPT, Azure | Hệ sinh thái công cụ rộng, gọi hàm và tích hợp trưởng thành | Đóng hoàn toàn, phụ thuộc chính sách nhà cung cấp |
| Claude | Anthropic | API, ứng dụng Claude, các nền tảng đám mây lớn | Lập trình, tài liệu dài, văn phong, làm theo chỉ dẫn | Không phải trọng tâm ở sinh ảnh, video |
| Gemini | API, ứng dụng Gemini, Google Workspace | Đa phương thức, tốc độ, tích hợp hệ sinh thái Google | Gói và tên sản phẩm thay đổi thường xuyên | |
| Llama | Meta | Tải trọng số, tự host hoặc qua nhà cung cấp | Tự triển khai, tinh chỉnh, kiểm soát dữ liệu | Giấy phép riêng của Meta, không phải mã nguồn mở theo nghĩa chặt |
| DeepSeek | DeepSeek | API, ứng dụng, tải trọng số | Giá thấp, lập luận, toán và mã | Cân nhắc nơi xử lý dữ liệu khi dùng dịch vụ gốc |
| Grok | xAI | API, nền tảng X | Gắn với dữ liệu thời gian thực từ X | Hệ sinh thái doanh nghiệp còn hẹp hơn |
| Mistral, Qwen và các hãng khác | Mistral AI, Alibaba… | API hoặc trọng số mở tuỳ bản | Lựa chọn thay thế, nhiều cỡ mô hình | Cần kiểm tra giấy phép từng phiên bản |
Nếu bạn quan tâm sâu hơn một dòng, hãy đọc riêng bài Claude AI và bài Gemini AI. Bài này tập trung vào cách đặt chúng cạnh nhau.
Tháng 10/2026, vì sao bảng xếp hạng nào cũng khác nhau?
Thị trường đổi nhanh đến mức các trang theo dõi cũng không thống nhất đâu là phiên bản mới nhất. Một trang xếp hạng tháng 10/2026 liệt kê GPT-5.5, Claude Opus 4.7, Gemini 3.5 Flash và Grok 4.3 là các bản mới. Một trang khác cùng tháng lại đặt Claude Opus 5.5, GPT-6 Astra và GPT-6.1 Sol ở nhóm đầu. Vì vậy bài này không chốt “số một” theo số hiệu. Bạn nên mở trang giá và tài liệu của chính nhà cung cấp trước khi quyết định.
Có ba xu hướng ổn định hơn tên gọi:
- Chia bậc trong mỗi dòng. Hãng thường có bản cao cấp, bản cân bằng và bản nhỏ rẻ. Chẳng hạn Anthropic phát hành Claude Haiku 5.5 ngày 7/10/2026, là bản nhỏ nhất của dòng 5.5.
- Cửa sổ ngữ cảnh lớn đã phổ biến. Nhiều mô hình hàng đầu công bố mức khoảng 1 triệu token. Khác biệt thực tế nằm ở độ chính xác khi tài liệu dài, xem thêm bài context window.
- Chênh lệch giá rất lớn. Theo một trang tổng hợp giá tháng 10/2026, giá đầu ra của mô hình đắt nhất là 180 USD mỗi triệu token, còn bản rẻ nhất chỉ 0,40 USD, chênh 450 lần. Con số này cho thấy chọn sai bậc có thể làm hoá đơn đội lên hàng chục lần.
Giá và tên phiên bản trong các trang tổng hợp bên thứ ba có thể lệch so với trang chính thức. Mọi con số giá nên được đối chiếu với trang giá của nhà cung cấp vào ngày bạn ký ngân sách.
So sánh theo tiêu chí doanh nghiệp cần
Bảng điểm trên mạng thường chỉ đo trí thông minh chung. Doanh nghiệp còn cần những tiêu chí khác, và mỗi tiêu chí có cách kiểm tra riêng.
| Tiêu chí | API đóng (GPT, Claude, Gemini, Grok) | Trọng số mở (Llama, DeepSeek, Qwen, Mistral một số bản) |
|---|---|---|
| Chất lượng ở mức cao nhất | Thường dẫn đầu ở các bài khó | Gần với nhóm đầu ở nhiều tác vụ, kém hơn ở bài rất khó hoặc agent dài |
| Chi phí khi dùng ít | Trả theo token, không cần hạ tầng | Cần GPU hoặc nhà cung cấp lưu trữ, tốn công vận hành |
| Chi phí khi dùng rất nhiều | Tăng tuyến tính theo lượng token | Có thể rẻ hơn khi GPU được dùng đủ tải |
| Kiểm soát dữ liệu | Dữ liệu đi qua bên thứ ba, phụ thuộc hợp đồng | Chạy trong hạ tầng của bạn, dữ liệu không rời ra ngoài |
| Tinh chỉnh | Hạn chế hoặc theo gói của hãng | Linh hoạt, xem mô hình nguồn mở |
| Cập nhật và ngừng hỗ trợ | Hãng có thể ngừng phiên bản cũ | Bạn giữ nguyên bản đang chạy |
| Tiếng Việt | Thường tốt ở bản cao cấp | Biến động theo từng bản và cỡ mô hình |
Cột bên phải không có nghĩa là “rẻ hơn” mặc định. Tự host nghĩa là bạn trả thêm cho nhân sự vận hành, giám sát và cập nhật, những khoản không có trong hoá đơn token.
Giá mỗi triệu token có phản ánh chi phí thật không?
Không hoàn toàn. Chi phí thật là chi phí cho một tác vụ hoàn thành đúng. Nó phụ thuộc số token đầu vào, số token đầu ra, số lần gọi lại và cả chế độ suy luận. Một bài tổng hợp tháng 10/2026 ghi rằng cùng một mô hình tốn 7,60 USD mỗi tác vụ ở mức nỗ lực tối đa so với 1,08 USD ở mức cao, tức gấp khoảng 7 lần. Mô hình có giá niêm yết thấp nhưng suy luận dài hoặc phải thử lại nhiều lần vẫn có thể đắt hơn mô hình giá cao nhưng làm đúng ngay lần đầu.
Ví dụ minh hoạ (số giả định): bộ phận kế toán cần trích 5.000 hoá đơn mỗi tháng. Mô hình A rẻ nhưng sai 12% phải duyệt lại thủ công. Mô hình B đắt gấp 3 lần nhưng chỉ sai 3%. Nếu mỗi hoá đơn duyệt tay mất vài phút công, tiền token thường chỉ là phần nhỏ so với công sửa lỗi. Hãy tính tổng, gồm cả giờ công người kiểm tra.
Ba khoản dễ bị bỏ sót khi dự toán:
- Token của system prompt và tài liệu đính kèm lặp lại ở mỗi lượt gọi. Tính năng lưu đệm (cache) của nhiều hãng giảm khoản này, xem bài system prompt để hiểu vì sao nó lặp.
- Giá đầu ra thường cao hơn nhiều so với giá đầu vào, nên tác vụ viết dài tốn hơn tác vụ phân loại.
- Giá ở vùng ngữ cảnh dài có thể có bậc riêng. Chẳng hạn bản Haiku 5.5 được niêm yết ở mức 0,10/0,50 USD dưới 100K token và 0,50/2,50 USD khi vượt mức đó.
Điểm benchmark và xếp hạng nên đọc thế nào?
Bảng xếp hạng công khai hữu ích để lọc từ vài chục xuống 3 ứng viên, không để chốt. Có hai loại cần phân biệt. Loại thứ nhất là bài kiểm tra có đáp án, ví dụ giải bài lập trình hay làm thao tác trên terminal. Loại thứ hai là xếp hạng theo bình chọn của người dùng, như LMArena (trước đây là Chatbot Arena), nơi người dùng so hai câu trả lời ẩn danh. Loại sau đo sở thích, nên phản ánh văn phong và độ dễ chịu hơn là độ đúng với nghiệp vụ của bạn.
Khi đọc điểm, hãy kiểm tra bốn điều: bài thử có gần việc của bạn không, kết quả do hãng tự công bố hay bên độc lập đo, mức nỗ lực suy luận được dùng là gì, và chi phí mỗi tác vụ có được nêu không. Một bảng độc lập tháng 8/2026 còn cho thấy cùng một bảng có thể có năm cột và năm mô hình thắng khác nhau. Phương pháp và giới hạn của các bài thử được giải thích trong bài về benchmark LLM.
Chọn theo ma trận: độ khó của việc và độ nhạy cảm của dữ liệu
Hai câu hỏi lọc nhanh nhất là việc này khó đến đâu và dữ liệu có được rời khỏi hạ tầng công ty không. Ma trận dưới đây là khung tham khảo, không phải kết luận cứng.
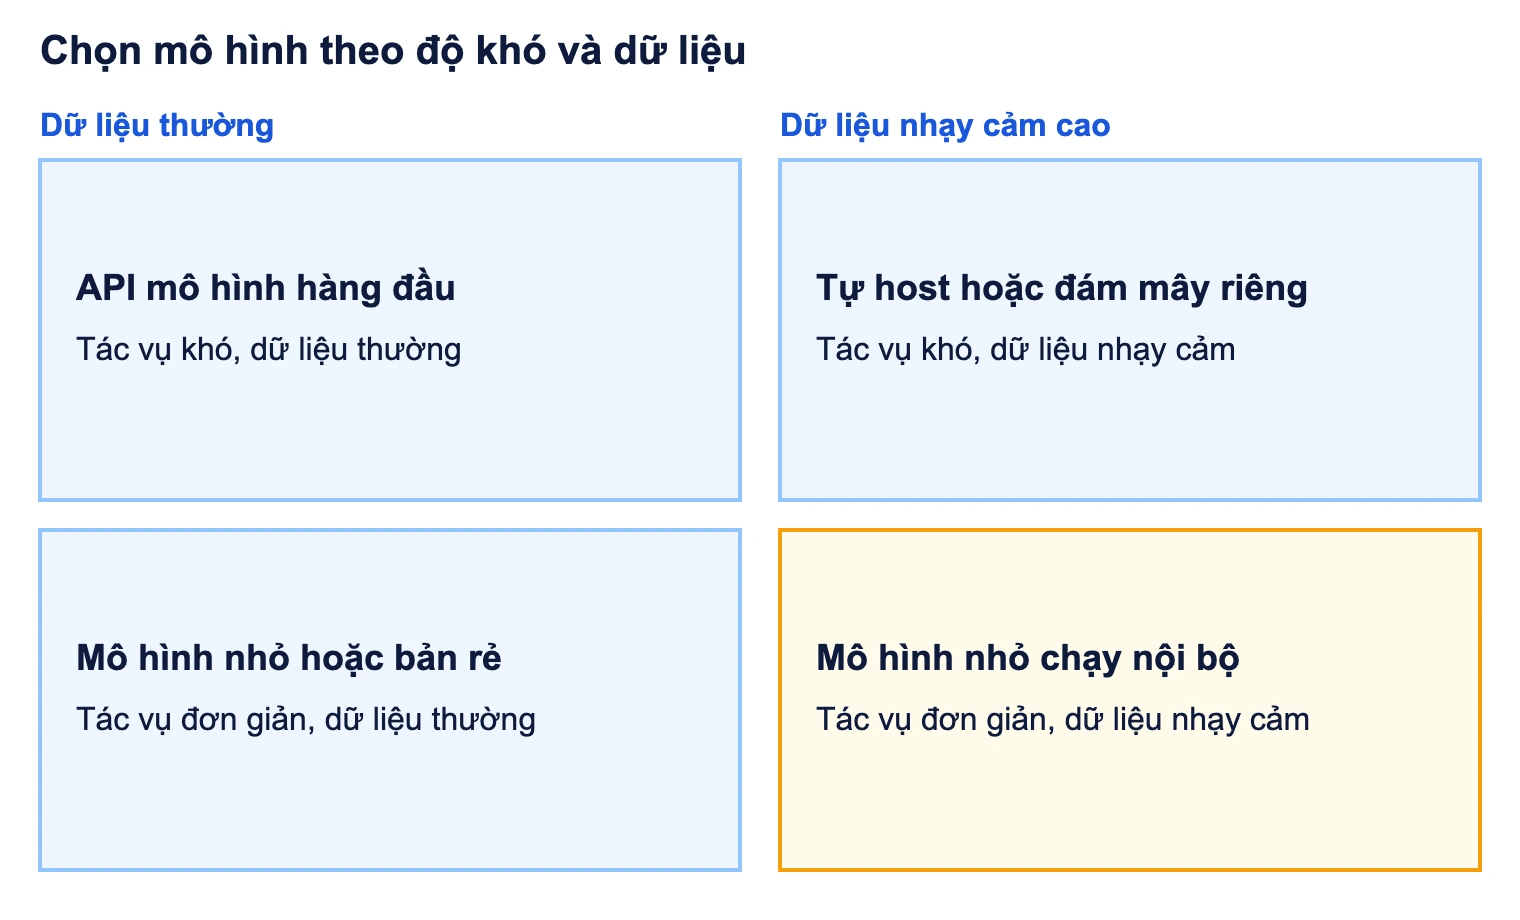
Ô dưới phải thường bị đánh giá thấp. Phân loại email, gắn nhãn phiếu hỗ trợ hay che thông tin cá nhân trước khi gửi đi là những việc mà mô hình ngôn ngữ nhỏ chạy nội bộ làm được mà không cần mô hình đắt nhất.
Mỗi nhóm mô hình hợp với tình huống nào?
Các ví dụ dưới đây là ví dụ minh hoạ để thấy cách lập luận, không phải kết quả đo.
- Chăm sóc khách hàng đa kênh, lượng lớn, câu hỏi lặp. Ưu tiên bản nhỏ hoặc bản rẻ của một hãng lớn, kết hợp RAG để trả lời theo tài liệu công ty. Độ chính xác đến từ tài liệu được truy xuất nhiều hơn từ kích cỡ mô hình.
- Rà soát hợp đồng dài vài trăm trang. Cần ngữ cảnh lớn và khả năng bám chỉ dẫn. Ứng viên là bản cao cấp của các dòng có ngữ cảnh khoảng 1 triệu token. Thử trên hợp đồng thật vì lỗi thường nằm ở điều khoản bị bỏ sót, không ở văn phong.
- Hỗ trợ lập trình và tác tử viết mã. Bài thử nên là các lỗi có thật trong kho mã của bạn. Chênh lệch giữa các dòng hàng đầu thường nhỏ hơn chênh lệch về chi phí mỗi tác vụ và số bước tác tử phải chạy.
- Phân tích tài liệu có hình, bảng, biểu đồ. Chọn mô hình đa phương thức, xem thêm mô hình ngôn ngữ thị giác. Thử với bản scan chất lượng xấu, vì đó là đầu vào thực tế ở nhiều văn phòng.
- Dữ liệu y tế, tài chính, hồ sơ nhân sự. Xét mô hình trọng số mở như Llama hay DeepSeek chạy trong hạ tầng riêng, hoặc dịch vụ đám mây có cam kết hợp đồng rõ ràng về dữ liệu.
Tiếng Việt: kiểm tra những điểm nào?
Hầu hết bảng so sánh quốc tế đo bằng tiếng Anh, nên chất lượng tiếng Việt cần kiểm riêng. Bộ câu hỏi thử nên có các nhóm sau:
- Văn bản có dấu và không dấu lẫn lộn, như tin nhắn khách hàng gõ vội.
- Thuật ngữ chuyên ngành: kế toán, thuế, xây dựng, y khoa, logistics.
- Tên riêng, địa danh, tên công ty có dấu và viết tắt.
- Định dạng ngày, số tiền và đơn vị theo kiểu Việt Nam, ví dụ dấu chấm phân cách hàng nghìn.
- Xưng hô, sắc thái lịch sự trong thư gửi khách hàng và đối tác.
Một điểm kỹ thuật: tiếng Việt thường bị tách thành nhiều token hơn tiếng Anh ở nhiều bộ tách từ, nên cùng nội dung có thể tốn nhiều token hơn. Mức chênh khác nhau theo từng mô hình, vì vậy hãy đo bằng chính văn bản của bạn thay vì tin một con số chung.
Dữ liệu gửi cho mô hình và điểm pháp lý cần nhớ
Khi gửi dữ liệu khách hàng hay nhân viên tới API của bên khác, bạn đang xử lý dữ liệu cá nhân. Với chủ đề so sánh mô hình, hai điểm thực tế nhất là: xem nhà cung cấp lưu hoặc dùng dữ liệu của bạn để huấn luyện trong điều kiện nào, và dữ liệu có được xử lý ở nước ngoài hay không. Nếu có chuyển dữ liệu ra nước ngoài, Luật Bảo vệ dữ liệu cá nhân yêu cầu bạn rà thủ tục theo luật và văn bản hướng dẫn hiện hành.
Với mô hình trọng số mở, bạn có thể chạy trong hạ tầng của mình để dữ liệu không rời công ty. Dịch vụ do chính hãng cung cấp (ví dụ ứng dụng hay API của DeepSeek) lại là chuyện khác, vì khi đó dữ liệu đi qua máy chủ của hãng. Xem thêm DeepSeek để hiểu sự khác biệt giữa trọng số tải về và dịch vụ trực tuyến.
Chấm thử ba ứng viên trên dữ liệu của bạn
Đây là cách nhỏ gọn để thay thế việc tin vào bảng xếp hạng. Mục tiêu là có bảng điểm riêng cho công ty và chi phí mỗi tác vụ thật.
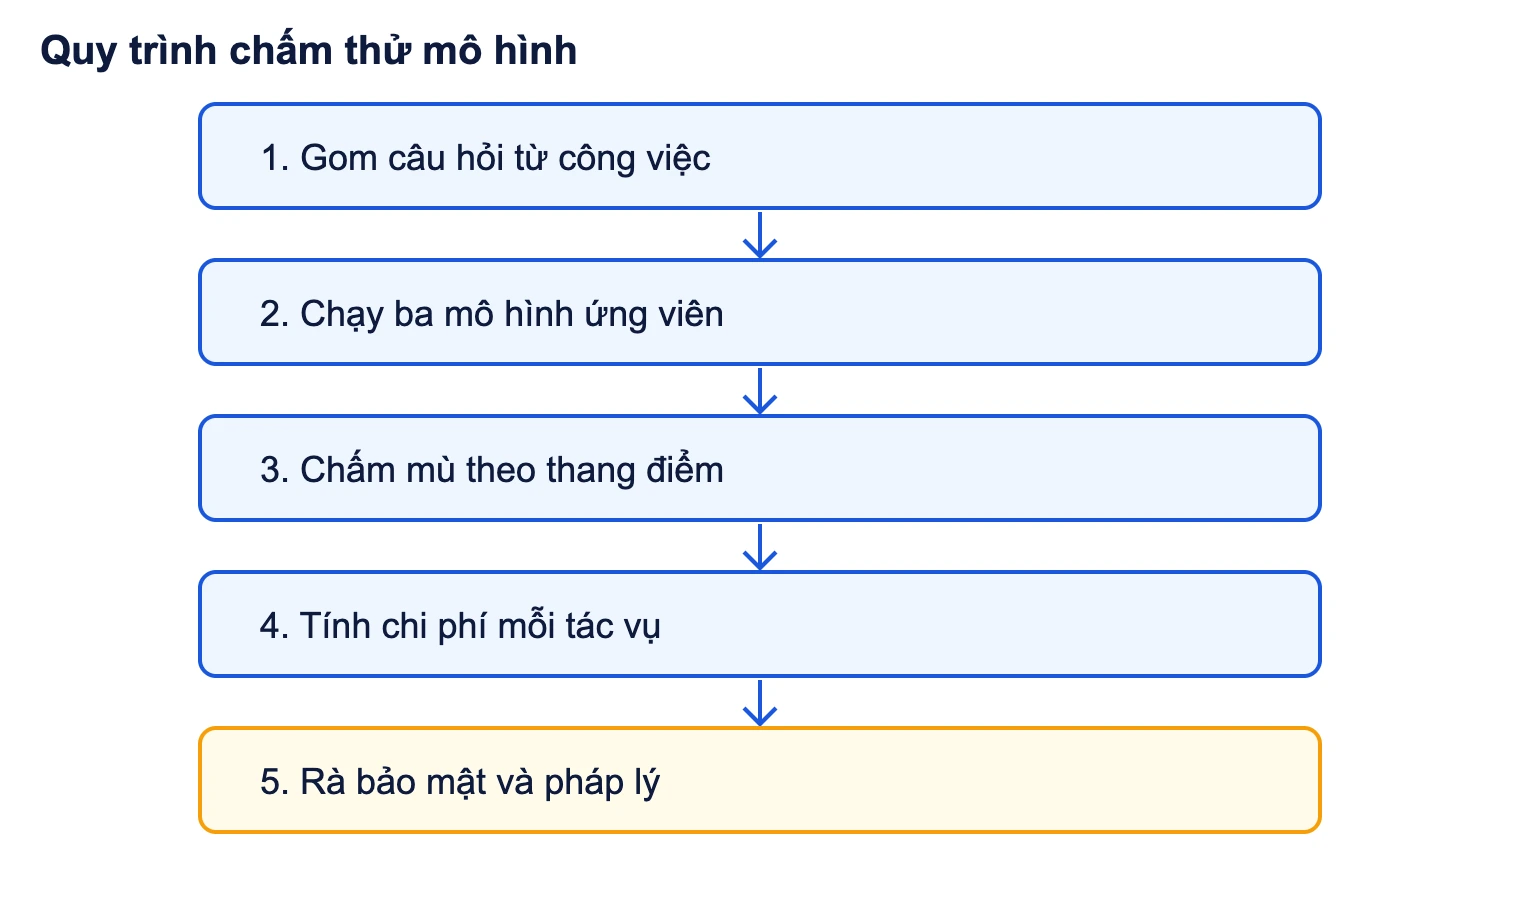
- Gom bộ câu hỏi. Lấy khoảng 30 đến 50 yêu cầu có thật từ email, phiếu hỗ trợ, hợp đồng hay báo cáo. Đây là con số gợi ý để đủ thấy chênh lệch, không phải ngưỡng thống kê. Gắn kèm đáp án chuẩn do người am hiểu soạn.
- Giữ nguyên điều kiện. Cùng một prompt, cùng tài liệu, cùng tham số temperature. Ghi lại tên phiên bản chính xác, vì cùng tên dòng có thể trỏ tới phiên bản khác nhau theo thời gian.
- Chấm mù. Người chấm không biết câu trả lời của mô hình nào. Thang gợi ý: đúng, đúng nhưng thiếu, sai nhưng nghe hợp lý, sai rõ ràng. Nhóm “sai nhưng nghe hợp lý” là nơi ảo giác AI nằm, và là nhóm nguy hiểm nhất.
- Tính chi phí thật. Cộng token vào, token ra, số lần gọi lại, rồi chia cho số tác vụ đạt yêu cầu. Thêm giờ công người sửa lỗi.
- Rà bảo mật. Thử đưa văn bản có chỉ dẫn ẩn để xem mô hình có bị dẫn dắt không (xem prompt injection), và kiểm tra điều khoản dữ liệu của nhà cung cấp.
Những sai lầm thường gặp khi chọn mô hình
| Sai lầm | Hậu quả | Cách xử lý |
|---|---|---|
| Chọn theo hạng chung trên mạng | Mô hình giỏi bài thi nhưng yếu ở nghiệp vụ riêng | Dùng bộ câu hỏi nội bộ làm thước đo chính |
| So sánh với prompt viết cho một mô hình | Mô hình khác bị thiệt, kết quả lệch | Điều chỉnh prompt riêng cho từng ứng viên rồi mới chấm |
| Gắn cứng vào một hãng | Khó chuyển khi giá đổi hoặc phiên bản bị ngừng | Viết lớp gọi mô hình tách khỏi logic nghiệp vụ, có thể đổi nhà cung cấp |
| Dùng bản cao cấp cho mọi việc | Hoá đơn cao không cần thiết | Phân luồng: việc dễ cho bản nhỏ, việc khó cho bản lớn |
| Tưởng tinh chỉnh luôn tốt hơn | Tốn công mà lỗi thiếu kiến thức vẫn còn | Thử prompt và RAG trước, rồi xem tinh chỉnh mô hình nếu cần phong cách hoặc định dạng ổn định |
Khi nào nên đổi mô hình đang dùng?
Vì thị trường đổi nhanh, câu hỏi thực tế không phải “chọn một lần” mà là khi nào xem xét lại. Có ba tín hiệu đáng chú ý. Một là nhà cung cấp thông báo ngừng phiên bản bạn đang dùng. Hai là có bản mới rẻ hơn rõ rệt ở cùng bậc, ví dụ khi hãng hạ giá dòng cũ hoặc ra bản nhỏ mới. Ba là bộ câu hỏi nội bộ cho thấy tỉ lệ lỗi tăng sau khi hãng cập nhật ngầm.
Nếu hệ thống của bạn gồm nhiều bước, như tác tử gọi công cụ, mỗi bước có thể dùng một bậc khác nhau: bước lập kế hoạch dùng bản mạnh, bước trích xuất dùng bản nhỏ. Cách này được bàn thêm trong bài về AI agent. Việc giữ bộ câu hỏi nội bộ ổn định cho phép bạn chạy lại bài thử trong vài giờ mỗi khi có bản mới, thay vì đọc lại hàng chục bài đánh giá.
Câu hỏi thường gặp
Mô hình AI nào tốt nhất hiện nay?
Không có đáp án chung. Các trang xếp hạng tháng 10/2026 không thống nhất về thứ hạng và thậm chí về phiên bản mới nhất. Mô hình tốt nhất cho bạn là mô hình đạt điểm cao nhất trên bộ câu hỏi nghiệp vụ của bạn với chi phí mỗi tác vụ chấp nhận được.
ChatGPT, Claude và Gemini khác nhau cơ bản ở đâu?
Chúng là sản phẩm của ba hãng với ba hướng ưu tiên khác nhau: hệ sinh thái công cụ rộng, thế mạnh về mã và tài liệu dài, và tích hợp sâu với dịch vụ Google. Khoảng cách chất lượng giữa các bản hàng đầu thường nhỏ, nên tích hợp, giá và điều khoản dữ liệu thường quyết định nhiều hơn.
Llama và DeepSeek có thật sự miễn phí không?
Trọng số có thể tải về, nhưng chạy chúng cần máy chủ GPU, nhân sự vận hành và giám sát. Giấy phép cũng khác nhau: Llama dùng giấy phép riêng của Meta, còn mỗi bản của DeepSeek có điều khoản riêng cần đọc. Khi lượng dùng thấp, trả theo token qua API thường kinh tế hơn.
Có nên dùng nhiều mô hình cùng lúc không?
Có thể, nếu bạn có lý do đo được, chẳng hạn bản nhỏ xử lý việc dễ để giảm chi phí và bản lớn xử lý việc khó. Đổi lại, bạn phải duy trì nhiều bộ prompt và nhiều hợp đồng. Hãy dùng khi chênh lệch chi phí đủ lớn để bù công vận hành.
Mô hình AI có hiểu tiếng Việt đủ tốt cho doanh nghiệp không?
Các bản cao cấp thường xử lý tiếng Việt khá tốt trong giao tiếp và soạn thảo. Rủi ro nằm ở thuật ngữ chuyên ngành, tên riêng và văn bản có dấu sai. Hãy kiểm tra bằng văn bản thật của công ty trước khi đưa vào quy trình.
Cần xem gì trước khi gửi dữ liệu khách hàng cho nhà cung cấp mô hình?
Xem điều khoản về lưu trữ và huấn luyện bằng dữ liệu của bạn, nơi xử lý dữ liệu, và các cam kết hợp đồng cho doanh nghiệp. Bộ phận pháp chế nên rà các điều khoản này trước khi triển khai.
blog công nghệ VBPO cập nhật tin tức và kiến thức công nghệ cho doanh nghiệp Việt Nam. Xem thêm các bài cùng chuyên mục AI tạo sinh & LLM.