
Trả lời nhanh: Text to speech (TTS) là công nghệ chuyển văn bản thành giọng nói: máy nhận đoạn chữ rồi phát ra âm thanh giống người nói. TTS hiện đại chuẩn hoá văn bản, dự đoán phát âm, ngữ điệu và tạo sóng âm bằng học sâu (neural TTS). Ví dụ: tổng đài tự động đọc số dư cho từng khách.
Điểm chính
- TTS làm chiều “chữ thành tiếng”, ngược với speech to text (STT) làm chiều “tiếng thành chữ”.
- Một hệ thống TTS gồm 3 khâu: xử lý văn bản, mô hình âm học và vocoder. Với tiếng Việt, lỗi hay gặp nằm ở khâu đầu: đọc sai số, ngày, viết tắt.
- Neural TTS (từ WaveNet năm 2016) dùng mạng nơ-ron học phát âm, ngữ điệu và sóng âm, nên giọng máy tự nhiên hơn hẳn thế hệ ghép nối và tham số.
- Công cụ TTS gồm bốn nhóm: dịch vụ đám mây quốc tế, nhà cung cấp tiếng Việt trong nước, mã nguồn mở tự vận hành và trình đọc có sẵn trong thiết bị.
- Trong call center, TTS là “cái miệng” của IVR, callbot, cuộc gọi nhắc nợ và xác nhận đơn. Từ 01/03/2026, hệ thống AI tương tác trực tiếp phải cho người dùng biết họ đang nói chuyện với máy.
Mục lục
- Text to speech là gì?
- Lịch sử text to speech qua các mốc chính
- TTS hoạt động như thế nào?
- Các thế hệ công nghệ TTS khác nhau ra sao?
- Neural TTS là gì và khác TTS truyền thống chỗ nào?
- Vì sao chuyển văn bản thành giọng nói tiếng Việt khó hơn?
- TTS khác speech to text, voicebot và voice clone thế nào?
- Text to speech được ứng dụng ở đâu?
- TTS trong call center: lợi ích, giới hạn và cách viết kịch bản
- Các công cụ text to speech phổ biến hiện nay
- Tiêu chí chọn giải pháp TTS tiếng Việt cho doanh nghiệp
- Pháp lý và đạo đức khi dùng giọng nói AI
- Hiểu lầm phổ biến về text to speech
- Câu hỏi thường gặp
Text to speech là gì?
Text to speech (TTS), dịch là chuyển văn bản thành giọng nói hay tổng hợp tiếng nói (speech synthesis), là công nghệ nhận đầu vào là chữ và trả đầu ra là âm thanh tiếng người. Máy không phát lại câu ghi âm sẵn mà tự tạo lời đọc cho bất kỳ đoạn văn bản nào.
Ví dụ đời thường: ứng dụng bản đồ đọc “còn 200 mét, rẽ phải”; tổng đài ngân hàng đọc “số dư tài khoản của quý khách là…” với con số riêng cho từng người. Không ai thu âm sẵn hàng triệu con số đó: máy tạo tiếng ngay lúc gọi.
TTS là viết tắt của text to speech, còn được gọi là giọng đọc AI (AI voice) hay giọng nói nhân tạo. Đây là một nhánh của trí tuệ nhân tạo (AI), cụ thể là xử lý tiếng nói. Nếu bạn cần hướng dẫn thực hành riêng cho tiếng Việt, bài về chuyển văn bản thành giọng nói tiếng Việt đi sâu hơn vào cách đọc và công cụ.
Lịch sử text to speech qua các mốc chính
Bảng dưới chỉ giữ những mốc có tài liệu gốc kiểm chứng được.
| Năm | Sự kiện | Ý nghĩa |
|---|---|---|
| 1939 | Homer Dudley (Bell Labs) trình diễn máy Voder tại Hội chợ Thế giới New York | Máy tạo tiếng nói điện tử, người vận hành điều khiển bằng bàn phím |
| 1961 | John L. Kelly Jr. và Louis Gerstman dùng máy tính IBM tổng hợp tiếng hát bài “Daisy Bell” | Một trong những lần đầu máy tính tự “hát” và “nói” |
| 1968 | Noriko Umeda và cộng sự tại Phòng thí nghiệm Điện kỹ thuật (Nhật Bản) xây hệ thống TTS tiếng Anh tổng quát đầu tiên | Đọc được văn bản bất kỳ, không giới hạn câu mẫu |
| 1976 | Ra mắt máy đọc Kurzweil Reading Machine | Kết hợp nhận dạng chữ in và TTS để đọc sách cho người khiếm thị |
| 2010 | W3C ban hành SSML 1.1 (ngày 07/09/2010) | Ngôn ngữ đánh dấu chuẩn để điều khiển cách máy đọc: ngắt nghỉ, tốc độ, cách đọc số |
| 9/2016 | DeepMind công bố WaveNet | Mạng nơ-ron tạo trực tiếp sóng âm, mở ra thời kỳ neural TTS |
| 12/2017 | Google công bố Tacotron 2 | Kiến trúc “văn bản → phổ mel → vocoder” được đánh giá gần ngang giọng thu âm chuyên nghiệp |
Máy đọc Kurzweil năm 1976 là ví dụ sớm cho việc ghép hai công nghệ: OCR (nhận dạng ký tự quang học) đọc chữ trên giấy, TTS đọc chữ đó thành tiếng.
TTS hoạt động như thế nào?
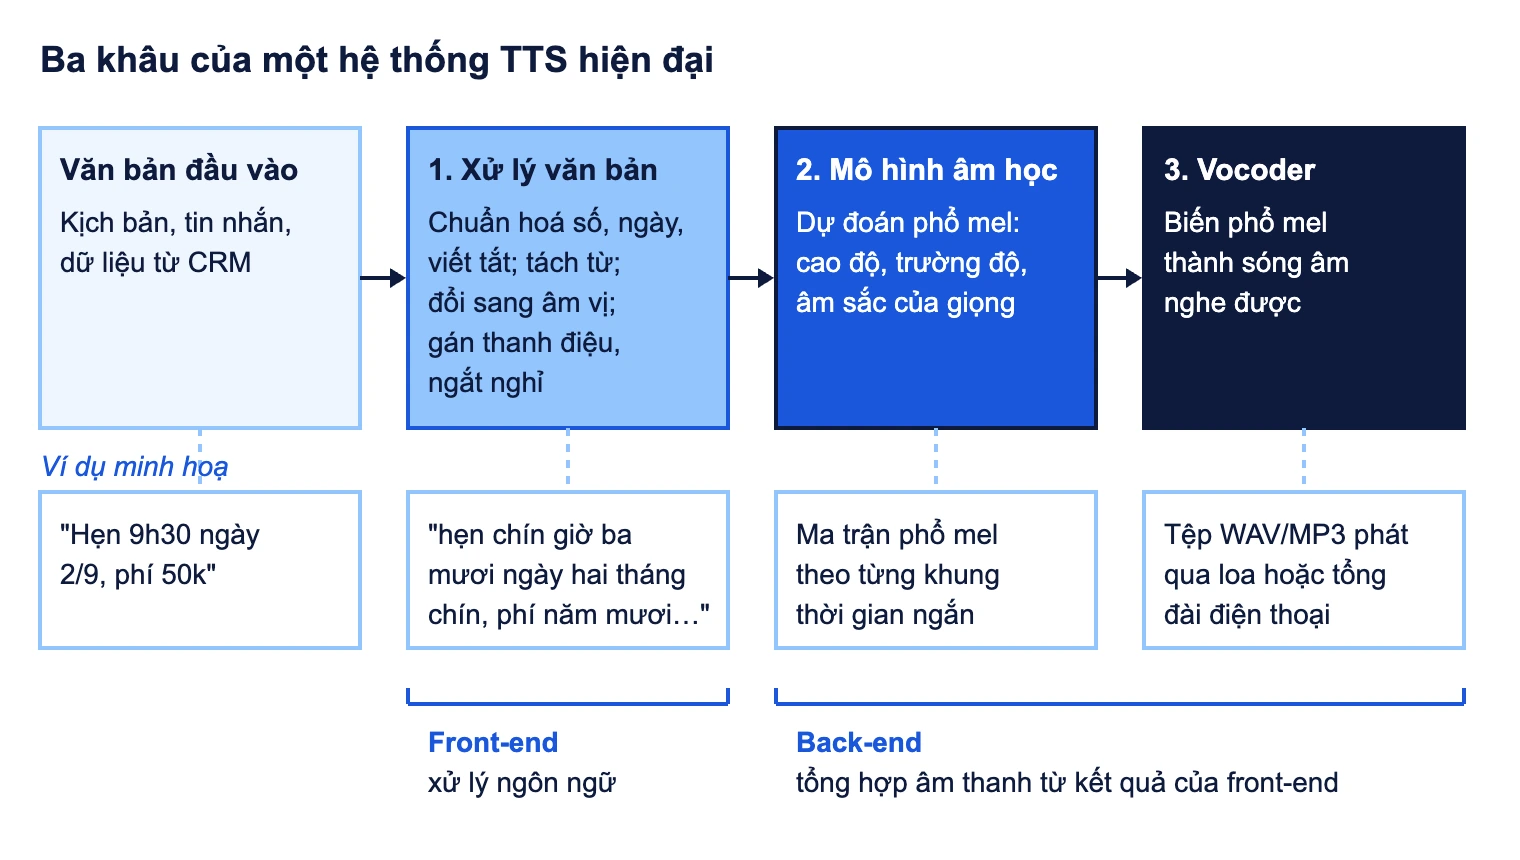
Hệ thống TTS có hai phần: front-end xử lý ngôn ngữ (đọc thế nào), back-end tạo âm thanh. Với neural TTS, back-end gồm mô hình âm học và vocoder.
Khâu 1: Xử lý và chuẩn hoá văn bản
Máy không hiểu “9h30”, “2/9” hay “50k” nếu không có quy tắc. Khâu chuẩn hoá văn bản (text normalization) đổi mọi ký hiệu thành chữ đọc được: số, ngày, giờ, tiền, đơn vị, viết tắt, ký hiệu. Sau đó hệ thống tách từ, chuyển sang âm vị (phoneme), gán thanh điệu và đoán chỗ ngắt nghỉ.
Khâu 2: Mô hình âm học
Mô hình âm học (acoustic model) nhận chuỗi âm vị và dự đoán “bản vẽ” của âm thanh, thường là phổ mel (mel spectrogram). Bản vẽ này mô tả cao độ, độ dài và âm sắc theo từng khung thời gian ngắn, quyết định giọng trầm hay bổng, nhanh hay chậm.
Khâu 3: Vocoder
Vocoder biến phổ mel thành sóng âm (waveform) mà loa phát được. Vocoder kém làm giọng rè, “kim loại”. Một số mô hình mới gộp khâu 2 và 3 thành một mạng (end-to-end).
Các thế hệ công nghệ TTS khác nhau ra sao?
Các tên gọi “giọng chuẩn”, “giọng neural”, “giọng HD” của nhà cung cấp gắn với những thế hệ kỹ thuật sau.
- Tổng hợp formant (theo quy tắc): mô phỏng thanh quản và khoang miệng bằng công thức, không dùng giọng thật. Nhẹ, rõ nhưng nghe rõ “giọng robot”.
- Tổng hợp ghép nối (concatenative): cắt bản thu âm của một người thành đơn vị nhỏ rồi ghép lại. Âm sắc thật nhưng chỗ nối hay vấp, ngữ điệu cứng.
- Tổng hợp tham số thống kê (statistical parametric): học phổ, cao độ, trường độ bằng mô hình thống kê, phổ biến là mô hình Markov ẩn (HMM). Mượt hơn nhưng đều đều, hơi đục.
- Neural TTS: mạng nơ-ron sâu học cả phát âm, ngữ điệu và sóng âm. Theo bài báo Tacotron 2, giọng tổng hợp đạt điểm đánh giá chủ quan trung bình (MOS) 4,53, gần mức 4,58 của giọng thu âm chuyên nghiệp trong thử nghiệm tiếng Anh của nhóm tác giả.
| Tiêu chí | Formant | Ghép nối | Tham số thống kê | Neural TTS |
|---|---|---|---|---|
| Độ tự nhiên | Thấp, rõ giọng máy | Âm sắc thật, chỗ nối vấp | Mượt nhưng đều, hơi đục | Cao, ngữ điệu linh hoạt |
| Dữ liệu cần | Gần như không | Rất nhiều giờ thu âm một giọng | Ít hơn ghép nối | Nhiều, nhưng có thể chuyển giao giữa các giọng |
| Tài nguyên tính toán | Rất nhẹ | Nhẹ, cần bộ nhớ lưu kho âm | Nhẹ | Nặng hơn, thường chạy trên đám mây hoặc GPU |
| Thêm giọng mới | Chỉnh tham số | Thu âm lại từ đầu | Huấn luyện lại | Tinh chỉnh từ mô hình sẵn có |
| Rủi ro điển hình | Khó nghe lâu | Ngữ điệu sai giữa câu | Nghe buồn ngủ | “Ảo giác” như đọc lặp, bỏ chữ với câu lạ |
Neural TTS là gì và khác TTS truyền thống chỗ nào?
Neural TTS là cách tổng hợp tiếng nói dùng mạng nơ-ron sâu (deep neural network) để học trực tiếp từ hàng giờ thu âm kèm văn bản. Thay vì kỹ sư viết quy tắc ngữ điệu hay cắt ghép âm, mô hình tự rút ra mối quan hệ giữa chuỗi chữ và đường cao độ, độ dài, âm sắc. Khi nhà cung cấp ghi “giọng neural” thì thường là loại này; giọng “standard” thường thuộc thế hệ cũ hơn.
Vì sao neural TTS nghe tự nhiên hơn?
- Ngữ điệu học từ dữ liệu: mô hình nhìn cả câu để quyết định nhấn ở đâu, lên giọng ở đâu, thay vì đọc từng âm tách rời.
- Không có điểm nối: sóng âm được tạo liền mạch, không còn chỗ vấp như khi ghép đoạn thu âm.
- Chuyển giao giữa các giọng: mô hình đã học từ nhiều người nói có thể tinh chỉnh sang giọng mới bằng ít dữ liệu hơn nhiều so với thời ghép nối. Đây cũng là nền của voice clone.
Các kiến trúc neural TTS đáng biết
| Mô hình | Vai trò | Điểm đáng chú ý |
|---|---|---|
| WaveNet (DeepMind, 2016) | Vocoder, tạo sóng âm | Sinh từng mẫu âm một nên bản gốc chậm; sau đó có bản song song hoá để chạy thực tế |
| Tacotron 2 (Google, 2017) | Văn bản → phổ mel, ghép với vocoder | Mô hình tự hồi quy, đọc lần lượt nên đôi khi bỏ hoặc lặp chữ |
| FastSpeech (2019) | Văn bản → phổ mel | Sinh song song, nhanh hơn và ổn định hơn, giảm lỗi lặp, bỏ chữ |
| HiFi-GAN (2020) | Vocoder | Dùng mạng đối kháng (GAN), tạo âm nhanh, nhẹ hơn các vocoder tự hồi quy |
| VITS (2021) | End-to-end | Gộp mô hình âm học và vocoder trong một mạng, nền của nhiều dự án mã nguồn mở |
Các hệ thống thương mại mới hơn (giọng “HD”, giọng sinh tạo) thường dùng mô hình lớn hơn nữa và không công bố đầy đủ kiến trúc, nên bạn chỉ nên so sánh bằng cách nghe thử với kịch bản của mình.
Đánh đổi của neural TTS
- Tốn tính toán hơn: thường chạy trên đám mây hoặc GPU, nên cần tính độ trễ và chi phí theo lượng ký tự.
- Độ trễ khi hội thoại: callbot cần giọng trả về dạng luồng (streaming) để bắt đầu phát khi mới có vài từ đầu, thay vì chờ tạo xong cả câu.
- Lỗi khó đoán: câu có mã đơn, tên lạ hoặc chuỗi số dài có thể bị đọc sai theo cách không lặp lại, nên phải nghe kiểm trước khi đưa vào cuộc gọi thật.
- Dễ lạm dụng: chính khả năng tinh chỉnh theo giọng người thật làm tăng rủi ro giả mạo, xem phần pháp lý bên dưới.
Nếu hệ thống của bạn cần nghe khách trước khi nói, hãy xem thêm bài về speech to text, chiều ngược lại của TTS.
Vì sao chuyển văn bản thành giọng nói tiếng Việt khó hơn?
Công cụ đọc tiếng Anh rất hay vẫn có thể đọc tiếng Việt “lơ lớ”, vì chất lượng phụ thuộc dữ liệu và quy tắc riêng của từng ngôn ngữ.
Thanh điệu mang nghĩa
Tiếng Việt miền Bắc có 6 thanh: ngang, huyền, sắc, hỏi, ngã, nặng. Đọc sai thanh là sai nghĩa: “bán” và “bàn”, “mua” và “múa”. Mô hình phải tạo đúng đường cao độ của từng thanh, kể cả khi nói nhanh.
Phương ngữ Bắc, Trung, Nam
Ở phương ngữ Nam, thanh hỏi và thanh ngã nhập làm một. Nhiều phụ âm và vần cũng đọc khác nhau giữa các vùng (“v” và “d”, “-n” và “-ng” cuối từ). Gọi cho khách miền Nam bằng giọng miền Bắc có thể gây cảm giác xa lạ, và ngược lại. Vì vậy có nhà cung cấp làm giọng theo vùng; ví dụ Viettel AI giới thiệu giọng nữ miền Bắc, miền Trung và miền Nam.
Chuẩn hoá số, ngày, viết tắt
Đây là nguồn lỗi rất hay gặp. Cùng một chuỗi ký tự, cách đọc phụ thuộc ngữ cảnh:
| Viết | Cần đọc là | Lỗi thường gặp |
|---|---|---|
| 2/9 | “ngày hai tháng chín” hoặc “hai phần chín” | Đọc thành phân số trong câu về ngày lễ |
| 1.500.000đ | “một triệu năm trăm nghìn đồng” | Đọc từng nhóm “một chấm năm trăm…” |
| 0912 345 678 | Đọc từng chữ số theo nhóm | Đọc thành “chín trăm mười hai…” |
| TP.HCM, BHXH | “thành phố Hồ Chí Minh”, “bảo hiểm xã hội” | Đánh vần từng chữ cái |
| 50k, 2tr | “năm mươi nghìn”, “hai triệu” | Đọc “năm mươi ca” |
| Thứ 2, quý II | “thứ hai”, “quý hai” | Đọc “quý i i” |
Từ mượn, tên riêng và văn bản thiếu dấu
Văn bản doanh nghiệp đầy tên tiếng Anh, mã đơn, email; dữ liệu khách nhập lại hay không dấu, sai chính tả. Máy phải đoán “Zalo”, “iPhone”, “KPI” đọc thế nào, và “chuyen khoan” là “chuyển khoản”. Giải pháp tốt cho phép bạn khai báo từ điển phát âm riêng thay vì chờ nhà cung cấp sửa.
TTS khác speech to text, voicebot và voice clone thế nào?
Bốn khái niệm này hay bị dùng lẫn, dù chúng là các mảnh ghép khác nhau.
| Khái niệm | Đầu vào → đầu ra | Vai trò | Ví dụ |
|---|---|---|---|
| Text to speech (TTS) | Chữ → giọng nói | “Cái miệng” của hệ thống | Đọc thông báo số dư, đọc báo, sách nói |
| Speech to text (STT, ASR) | Giọng nói → chữ | “Cái tai” của hệ thống | Phụ đề tự động, gỡ băng cuộc gọi |
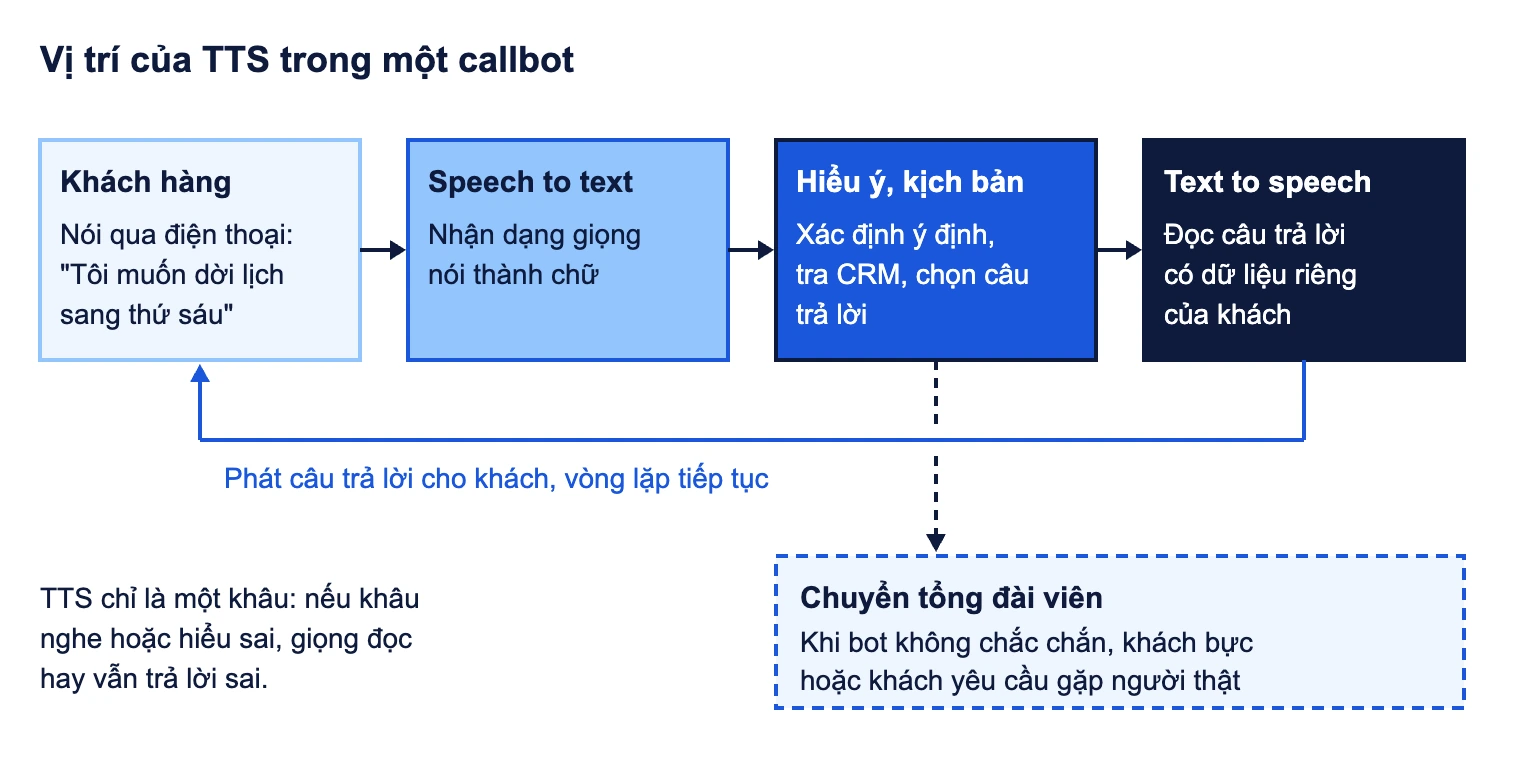
| Voicebot, callbot | Giọng nói → hiểu ý → giọng nói | Hệ thống hội thoại gồm STT, xử lý ngôn ngữ và TTS | Tổng đài tự động trả lời khách, gọi xác nhận lịch hẹn |
| Voice clone (nhân bản giọng nói) | Mẫu giọng một người + chữ → giọng của người đó | Một dạng TTS được tinh chỉnh theo giọng cụ thể | Giọng thương hiệu riêng, lồng tiếng; cũng là công cụ bị lợi dụng để giả mạo |
Nói gọn: TTS chỉ đọc, không hiểu. Callbot mới là thứ “nói chuyện” được, và TTS chỉ là một khâu trong đó. Cách các khâu ghép lại được mô tả kỹ hơn trong bài về voicebot và cách hoạt động.
Text to speech được ứng dụng ở đâu?
Call center, IVR và callbot
Tổng đài trả lời tự động (IVR, Interactive Voice Response) dùng TTS để đọc menu và thông tin động như số dư, trạng thái đơn, lịch hẹn. Callbot nghe khách, hiểu ý và trả lời bằng giọng tổng hợp. Ở Việt Nam, Cyber Callbot của Viettel được giới thiệu năm 2020 là tổng đài dùng AI trả lời khách bằng tiếng Việt, gồm mô-đun nhận dạng giọng nói và TTS.
Nhắc nợ, xác nhận đơn, nhắc lịch tự động
Cuộc gọi ra (outbound) nội dung lặp lại, dữ liệu riêng từng khách là đất của TTS: nhắc kỳ thanh toán, xác nhận đơn thu tiền khi giao, nhắc lịch khám. Viettel AI liệt kê chăm sóc khách hàng qua tổng đài và nhắc nợ trong các ứng dụng chính của TTS.
Đọc báo, sách nói, nội dung số
Trang tin thêm nút “nghe bài viết”, nhà sáng tạo nội dung dùng giọng đọc AI cho video, podcast, sách nói. Bài sửa thì bản nghe cập nhật ngay, không cần thu âm lại.
E-learning và đào tạo nội bộ
Bài giảng điện tử, video hướng dẫn quy trình có lời đọc nhất quán. Quy trình đổi thì sửa kịch bản và tạo lại âm thanh.
Hỗ trợ người khiếm thị và người khó đọc
Trình đọc màn hình trên máy tính và điện thoại dựa vào TTS. Theo bài giới thiệu của Đại học Bách khoa Hà Nội về startup Vbee, các ứng dụng hướng tới gồm sách nói cho người khiếm thị, đọc tin tức và thông báo trên phương tiện giao thông công cộng.
Thông báo công cộng
Nhà ga, bệnh viện, loa phát thanh cơ sở có thể dùng TTS để gọi số thứ tự, báo đổi giờ, cảnh báo thời tiết: nội dung mới phát được ngay, giọng đồng nhất.
TTS trong call center: lợi ích, giới hạn và cách viết kịch bản
Call center là nơi TTS tạo giá trị rõ nhất, cũng là nơi lỗi của TTS lộ rõ nhất. Sơ đồ dưới cho thấy vị trí của TTS trong callbot.
Bức tranh rộng hơn về tổng đài dùng AI nằm trong bài AI call center và callbot.
Lợi ích
- Thông tin động không cần thu âm: tên, số tiền, ngày hẹn riêng từng cuộc gọi.
- Đổi kịch bản nhanh: sửa câu chữ, tạo lại âm thanh, không cần hẹn lịch phòng thu.
- Chạy ngoài giờ, lúc cao điểm với giọng và cách xưng hô nhất quán.
- Giải phóng tổng đài viên khỏi việc lặp lại, giống logic của tự động hoá quy trình bằng robot (RPA), chỉ khác là áp dụng cho kênh thoại.
Giới hạn cần biết
- Không thay được sự đồng cảm: khiếu nại, tình huống nhạy cảm vẫn cần người thật.
- Âm thanh qua điện thoại bị nén: giọng hay trên loa máy tính có thể kém rõ khi qua đường thoại.
- Độ trễ: vài giây im lặng là đủ để khách nghĩ cuộc gọi bị rớt.
- Lỗi đọc dữ liệu: một số tiền đọc sai trong cuộc gọi nhắc nợ có thể gây khiếu nại thật.
Nếu thuê ngoài tổng đài, TTS và callbot thường nằm trong gói thuê ngoài quy trình kinh doanh (BPO); hãy đưa các tiêu chí dưới đây vào hợp đồng.
Cách viết kịch bản cho TTS
Viết cho tai nghe khác viết cho mắt đọc:
- Câu ngắn, một ý một câu, vì người nghe không “đọc lại” được.
- Thông tin quan trọng đặt cuối câu. “Khoản thanh toán kỳ này của anh là một triệu hai trăm nghìn đồng” dễ nhớ hơn đặt số tiền ở đầu.
- Định dạng sẵn số tiền, mã đơn, ngày hạn hoặc dùng thẻ SSML thay vì để máy đoán.
- Tránh viết tắt, ký hiệu như “TP.HCM”, “%”, “đ” nếu không chắc máy đọc đúng.
- Dùng dấu phẩy, dấu chấm để tạo nhịp cho máy ngắt nghỉ tự nhiên.
- Luôn có lối ra sang người thật ở mỗi nhánh kịch bản.
- Nghe thử qua điện thoại với đồng nghiệp ở các vùng miền trước khi chạy thật.
SSML là gì? SSML (Speech Synthesis Markup Language) là ngôn ngữ đánh dấu do W3C chuẩn hoá để chỉ dẫn máy đọc. Thẻ <break> tạo khoảng nghỉ, <prosody> chỉnh tốc độ và cao độ, <say-as> cho biết chuỗi là ngày, số hay chữ cái, <sub> thay cách đọc (viết “BHXH”, đọc “bảo hiểm xã hội”). Mức hỗ trợ từng thẻ khác nhau giữa các nhà cung cấp.
Các công cụ text to speech phổ biến hiện nay
Công cụ TTS chia thành bốn nhóm theo cách bạn dùng. Thông tin dưới đây mô tả theo tài liệu công khai của nhà cung cấp tại thời điểm viết (tháng 10/2026), không phải xếp hạng. Danh mục giọng, ngôn ngữ và giá thay đổi thường xuyên, nên hãy đối chiếu trang chính thức và thử với kịch bản của bạn.
| Nhóm | Ví dụ | Phù hợp khi | Lưu ý |
|---|---|---|---|
| Đám mây quốc tế | Google Cloud Text-to-Speech, Azure AI Speech, Amazon Polly | Cần API ổn định, nhiều ngôn ngữ, tích hợp vào ứng dụng hoặc tổng đài | Tiếng Việt phải kiểm tra từng nhà cung cấp; dữ liệu văn bản đi ra máy chủ nước ngoài |
| Dịch vụ tiếng Việt trong nước | FPT.AI, Viettel AI, Vbee | Cần giọng Bắc, Trung, Nam, hỗ trợ tiếng Việt và gói tổng đài đi kèm | So sánh bằng bộ câu có số tiền, ngày, tên riêng |
| Nền tảng giọng AI cho nội dung | ElevenLabs và các công cụ tương tự | Làm video, podcast, sách nói, cần giọng giàu biểu cảm hoặc voice clone | Kiểm tra điều khoản bản quyền giọng và dữ liệu mẫu giọng |
| Mã nguồn mở tự vận hành | Piper, các dự án dựa trên VITS | Cần chạy nội bộ, không gửi dữ liệu ra ngoài, có kỹ thuật viên | Tự lo hạ tầng, chuẩn hoá văn bản tiếng Việt và giám sát lỗi |
| Có sẵn trong thiết bị | Narrator trên Windows, VoiceOver trên iPhone và Mac, TalkBack trên Android | Cá nhân nghe văn bản, hỗ trợ người khiếm thị | Không có API cho tổng đài, ít tuỳ biến |
Một số chi tiết đã kiểm chứng
- Google Cloud Text-to-Speech: danh sách giọng vi-VN gồm các loại Standard, WaveNet, Neural2 và Chirp 3 HD, tức có cả thế hệ cũ lẫn neural.
- Azure AI Speech (Microsoft): có giọng neural tiếng Việt HoaiMy (nữ) và NamMinh (nam).
- Nhà cung cấp trong nước: FPT.AI, Viettel AI, Vbee và một số đơn vị khác có dịch vụ TTS tiếng Việt; một số có giọng theo vùng miền và giải pháp tổng đài đi kèm.
Với Amazon Polly, ElevenLabs hay các công cụ nói chung, hãy mở danh sách ngôn ngữ trên trang chính thức để xem có tiếng Việt và loại giọng nào (neural hay thế hệ cũ) trước khi đưa vào dự toán.
Cách thử công bằng: chuẩn bị khoảng 20 câu thật của doanh nghiệp (có số tiền, ngày hẹn, số điện thoại, tên sản phẩm và một câu không dấu), chạy trên mọi công cụ, rồi cho vài người nghe qua điện thoại. Giọng nghe hay ở trang demo chưa chắc đọc đúng dữ liệu của bạn.
Tiêu chí chọn giải pháp TTS tiếng Việt cho doanh nghiệp
Không có giải pháp “tốt nhất” cho mọi doanh nghiệp. Hãy chấm theo nhu cầu thực tế.
| Tiêu chí | Câu hỏi nên đặt | Cách kiểm tra |
|---|---|---|
| Chất lượng tiếng Việt | Có đọc đúng thanh, ngắt nghỉ tự nhiên không? | Chạy cùng bộ câu mẫu của doanh nghiệp trên mọi giải pháp |
| Chuẩn hoá văn bản | Đọc đúng số tiền, ngày, số điện thoại, viết tắt ngành không? | Đưa vào câu có dữ liệu thật đã ẩn danh |
| Giọng vùng miền | Có giọng Bắc, Trung, Nam; nam và nữ không? | Đối chiếu với tệp khách hàng chính |
| Tuỳ biến | Có SSML, từ điển phát âm riêng, chỉnh tốc độ không? | Thử sửa cách đọc một tên sản phẩm |
| Độ trễ, tích hợp | Có API, streaming, định dạng âm thanh cho tổng đài không? | Đo thời gian từ lúc gửi văn bản tới khi có tiếng |
| Bảo mật, dữ liệu | Văn bản và âm thanh lưu ở đâu, bao lâu, có dùng để huấn luyện không? | Đọc điều khoản xử lý dữ liệu, hỏi vị trí máy chủ |
| Giọng riêng, voice clone | Có quy trình xác minh sự đồng ý của người cho giọng không? | Yêu cầu xem quy trình và hợp đồng mẫu |
Pháp lý và đạo đức khi dùng giọng nói AI
Phải cho khách biết họ đang nói chuyện với AI
Luật Trí tuệ nhân tạo số 134/2025/QH15 thông qua ngày 10/12/2025, hiệu lực từ 01/03/2026. Điều 11 về trách nhiệm minh bạch quy định:
- Khoản 1: hệ thống AI tương tác trực tiếp với con người phải cho người dùng nhận biết họ đang tương tác với hệ thống. Với callbot, cách đơn giản là tự giới thiệu ngay câu đầu.
- Khoản 2: nhà cung cấp bảo đảm âm thanh, hình ảnh, video do AI tạo ra được đánh dấu ở định dạng máy đọc.
- Khoản 3: bên triển khai phải thông báo rõ khi công bố nội dung do AI tạo hoặc chỉnh sửa có khả năng gây nhầm lẫn.
- Khoản 4: nội dung mô phỏng ngoại hình, giọng nói của người thật hoặc tái hiện sự kiện thực tế phải được gắn nhãn dễ nhận biết.
Giọng nói là dữ liệu cá nhân
Luật Bảo vệ dữ liệu cá nhân số 91/2025/QH15, thông qua ngày 26/06/2025, có hiệu lực từ 01/01/2026, định nghĩa dữ liệu cá nhân là dữ liệu số hoặc thông tin dạng khác xác định hoặc giúp xác định một con người cụ thể. Bản ghi giọng nói gắn với tên hay số điện thoại thuộc phạm vi này. Điều 31 của Luật mô tả dữ liệu sinh trắc học là dữ liệu về thuộc tính vật lý, đặc điểm sinh học cá biệt và ổn định của một người để xác định người đó; Nghị định 356/2025/NĐ-CP ngày 31/12/2025 xếp dữ liệu sinh trắc học vào nhóm dữ liệu cá nhân nhạy cảm.
Hệ quả: muốn nhân bản giọng nhân viên hay người nổi tiếng, cần sự đồng ý rõ ràng, nêu mục đích và thời hạn. Bản ghi cuộc gọi dùng để cải thiện callbot cũng phải tuân thủ quy định xử lý dữ liệu cá nhân. Nguyên tắc chung được giải thích trong bài về bảo vệ dữ liệu cá nhân.
Rủi ro giả mạo giọng nói
Công nghệ nhân bản giọng nói đang bị lợi dụng để lừa đảo. Ngày 31/03/2025, Công an TP Hà Nội cảnh báo thủ đoạn dùng deepfake tạo video có hình ảnh và giọng nói giả danh người thân, bạn bè để vay tiền. Doanh nghiệp không nên xác thực khách chỉ bằng giọng nói, và nên công bố rõ kênh gọi lại chính thức.
Lưu ý: phần này tóm tắt các quy định chung để bạn nhận diện rủi ro, không phải tư vấn pháp lý. Trước khi triển khai callbot hay giọng nhân bản, hãy rà soát cùng bộ phận pháp chế.
Hiểu lầm phổ biến về text to speech
- “TTS là AI hiểu và trả lời được”: sai. TTS chỉ đọc văn bản nó nhận được. Hiểu câu hỏi là việc của STT và mô hình ngôn ngữ trong callbot.
- “Giọng càng tự nhiên càng tốt cho tổng đài”: chưa chắc. Đọc đúng số liệu, rõ qua điện thoại và trễ thấp thường quan trọng hơn.
- “Dùng TTS là cắt được hết tổng đài viên”: không thực tế. TTS và callbot gánh việc lặp lại; ca phức tạp vẫn cần người.
- “Neural TTS thì không bao giờ đọc sai”: sai. Giọng neural tự nhiên hơn nhưng vẫn có thể đọc nhầm số, bỏ hoặc lặp chữ với câu lạ.
- “Giọng AI thì không cần xin phép ai”: sai khi giọng mô phỏng người thật. Giọng là dữ liệu cá nhân và nội dung mô phỏng giọng người thật phải gắn nhãn.
Câu hỏi thường gặp
TTS là gì?
TTS là viết tắt của text to speech, công nghệ chuyển văn bản thành giọng nói. Máy nhận đoạn chữ, phân tích cách đọc rồi tạo ra âm thanh giống người nói.
Neural TTS là gì?
Neural TTS là kiểu TTS dùng mạng nơ-ron sâu học từ dữ liệu thu âm để tạo ngữ điệu và sóng âm, thay vì quy tắc viết tay hay cắt ghép đoạn thu. Mốc mở đầu thường được nhắc là WaveNet năm 2016. Nhờ vậy giọng mượt và tự nhiên hơn, nhưng tốn tính toán hơn và vẫn có thể đọc sai câu lạ.
Công cụ text to speech nào phổ biến?
Có bốn nhóm chính: dịch vụ đám mây như Google Cloud Text-to-Speech và Azure AI Speech, nhà cung cấp tiếng Việt như FPT.AI, Viettel AI, Vbee, mã nguồn mở như Piper, và trình đọc có sẵn trong Windows, iOS, Android. Hãy thử bằng kịch bản thật của bạn thay vì chọn theo tên.
Text to speech có miễn phí không?
Có công cụ miễn phí cho cá nhân, như trình đọc màn hình tích hợp trong hệ điều hành. Dịch vụ cho doanh nghiệp thường tính phí theo ký tự, theo phút hoặc gói tháng.
Chuyển văn bản thành giọng nói tiếng Việt có đọc được giọng miền Nam không?
Có. Một số nhà cung cấp có giọng Bắc, Trung và Nam riêng. Hãy nghe thử với câu có thanh hỏi, ngã và tên địa phương.
TTS và speech to text khác nhau thế nào?
TTS biến chữ thành tiếng; speech to text (STT) biến tiếng thành chữ. Callbot dùng cả hai: STT để nghe khách, TTS để trả lời.
Có dùng giọng của nhân viên làm giọng tổng đài được không?
Được, bằng công nghệ voice clone, nhưng cần sự đồng ý rõ ràng của người đó vì giọng nói là dữ liệu cá nhân. Hợp đồng nên ghi mục đích, thời hạn và việc xoá mô hình giọng khi người đó rút lại đồng ý.
Callbot có bắt buộc phải nói mình là máy không?
Theo khoản 1 Điều 11 Luật Trí tuệ nhân tạo 2025, người dùng phải nhận biết được họ đang tương tác với hệ thống AI. Cách an toàn là callbot tự giới thiệu là trợ lý tự động ngay đầu cuộc gọi.
Vì sao TTS đọc sai số tiền và ngày tháng?
Vì khâu chuẩn hoá văn bản không đoán được ngữ cảnh, ví dụ “2/9” là ngày hay phân số. Cách khắc phục: định dạng dữ liệu trước khi đưa vào, dùng thẻ SSML như say-as, hoặc khai báo quy tắc đọc riêng.
Bài viết thuộc chuyên mục Giọng nói & tổng đài AI trên VBPO Tech Blog, trang tin tức và kiến thức công nghệ cho doanh nghiệp Việt Nam về AI, dữ liệu, blockchain, chuyển đổi số và tự động hoá.