
Trả lời nhanh: AI OCR là nhóm công nghệ nhận dạng ký tự quang học dùng mạng nơ-ron học sâu. Nó không chỉ chuyển ảnh thành chữ mà còn xác định bố cục, bảng biểu và gán nhãn trường dữ liệu (số hoá đơn, ngày, tổng tiền). Kết quả là dữ liệu có cấu trúc, kèm điểm tin cậy để người kiểm tra những chỗ nghi ngờ.
Điểm chính
- OCR truyền thống trả về văn bản thô. AI OCR trả về trường dữ liệu có nhãn và vị trí trên trang.
- Có hai lớp công việc: đọc chữ (nhận dạng) và hiểu tài liệu (bố cục, ngữ nghĩa). AI cải thiện cả hai lớp.
- Đo chất lượng bằng CER, WER và độ chính xác theo trường. Độ chính xác từng ký tự không phản ánh việc dữ liệu vào sổ đúng hay sai.
- AI OCR có điểm tin cậy cho từng trường. Giá trị của nó nằm ở chỗ phân luồng: trường chắc chắn đi thẳng, trường nghi ngờ chuyển cho người xem.
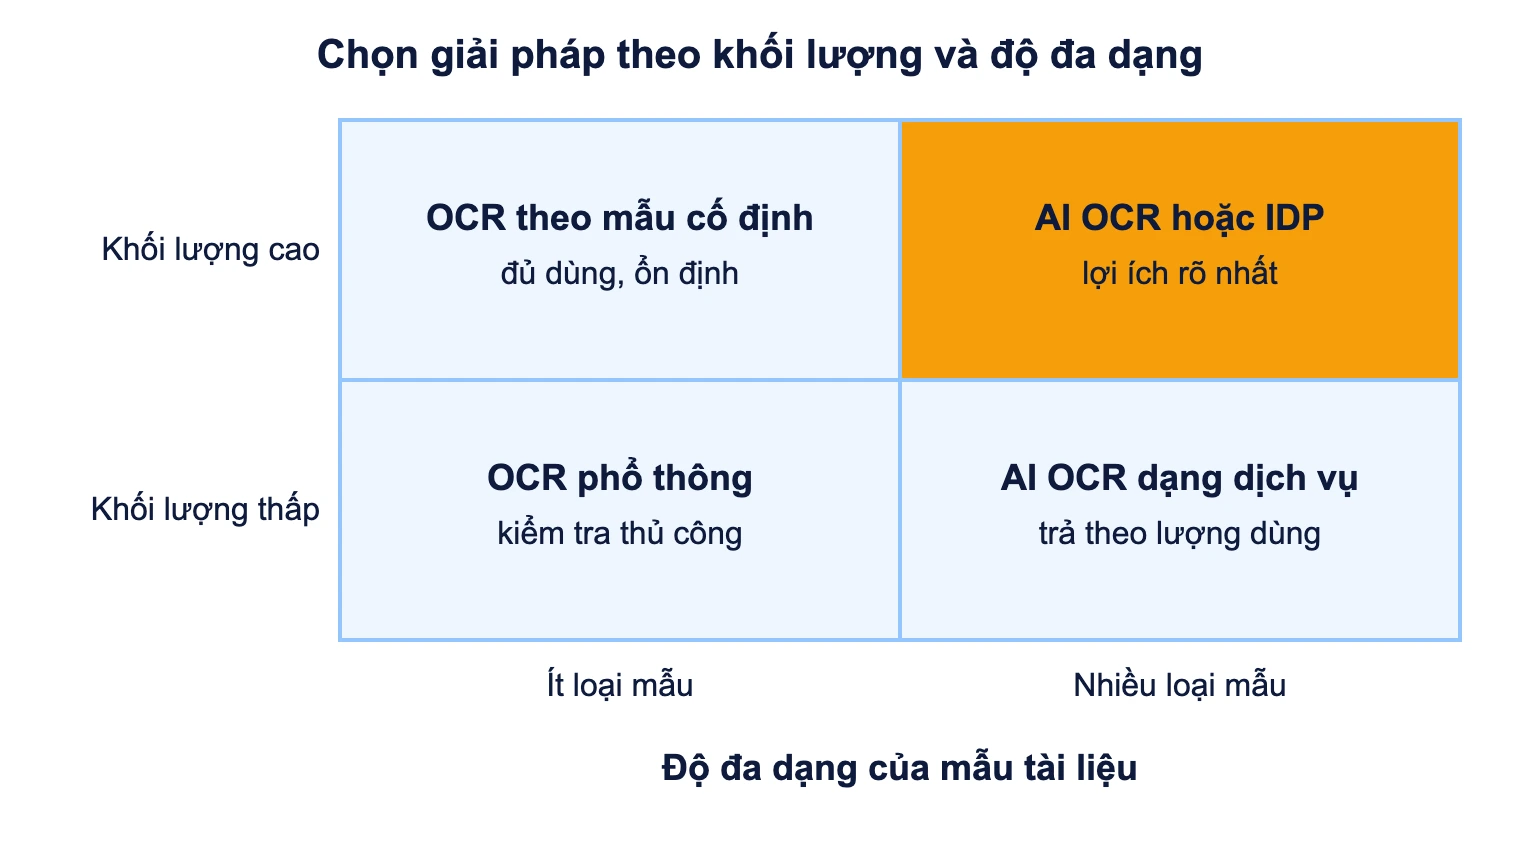
- Tài liệu ít loại mẫu, khối lượng thấp thì OCR phổ thông thường là đủ.
Mục lục
- AI OCR là gì và khác chữ “OCR” ở đâu?
- AI OCR hoạt động như thế nào qua từng tầng?
- Điểm tin cậy và vì sao nó là phần dễ bị bỏ qua?
- Đo chất lượng AI OCR bằng chỉ số nào?
- AI OCR phân loại thế nào và khác ICR, IDP ra sao?
- Ví dụ thực tế: AI OCR xử lý tài liệu nào tại doanh nghiệp Việt Nam?
- Triển khai AI OCR: dùng dịch vụ đám mây, tự chạy mô hình hay mua phần mềm trọn gói?
- AI OCR có ưu và nhược điểm gì?
- Khi nào nên và không nên dùng AI OCR?
- Câu hỏi thường gặp
AI OCR là gì và khác chữ “OCR” ở đâu?
OCR (Optical Character Recognition, nhận dạng ký tự quang học) biến ảnh chụp hoặc bản scan thành văn bản máy đọc được. Phần nền tảng này đã có bài riêng về nguyên lý OCR cơ bản, nên ở đây chỉ nói phần AI bổ sung.
AI OCR là cách gọi thị trường dùng cho các hệ thống OCR thay phần lớn quy tắc viết tay bằng mô hình học sâu (deep learning). Mô hình học từ hàng triệu ảnh chữ mẫu thay vì so khớp từng ký tự với một bộ khuôn. Nhiều tài liệu của nhà cung cấp mô tả AI OCR còn có thêm thị giác máy tính (computer vision) và xử lý ngôn ngữ tự nhiên (NLP) để hiểu ngữ cảnh. Đây là cách gọi thương mại, không phải một chuẩn kỹ thuật. Hai sản phẩm cùng ghi “AI OCR” có thể rất khác nhau về năng lực.
Cách phân biệt thực tế là nhìn vào đầu ra:
- OCR truyền thống: trả về một khối văn bản, đôi khi kèm toạ độ từng từ. Muốn lấy “tổng tiền” bạn phải tự viết quy tắc tìm vị trí.
- AI OCR: trả về cấu trúc, ví dụ nhà cung cấp, mã số thuế, ngày lập, bảng hàng hoá, mỗi trường có toạ độ và điểm tin cậy.
Lưu ý quan trọng: ngay cả bộ máy OCR mã nguồn mở quen thuộc như Tesseract, từ phiên bản 4 đã dùng mạng LSTM để nhận dạng dòng chữ. Vì vậy “có học sâu hay không” chưa đủ để phân biệt. Điều quyết định là hệ thống có hiểu bố cục và trích trường hay không.
AI OCR hoạt động như thế nào qua từng tầng?
Một quy trình OCR kinh điển gồm tiền xử lý (khử nhiễu, nhị phân hoá, chỉnh nghiêng), phát hiện vùng chữ, tách ký tự hoặc từ, trích đặc trưng rồi đối chiếu với bộ ký tự hoặc mô hình ngôn ngữ. AI OCR giữ khung này nhưng thay từng khâu bằng mô hình học được, rồi thêm tầng hiểu tài liệu ở cuối.
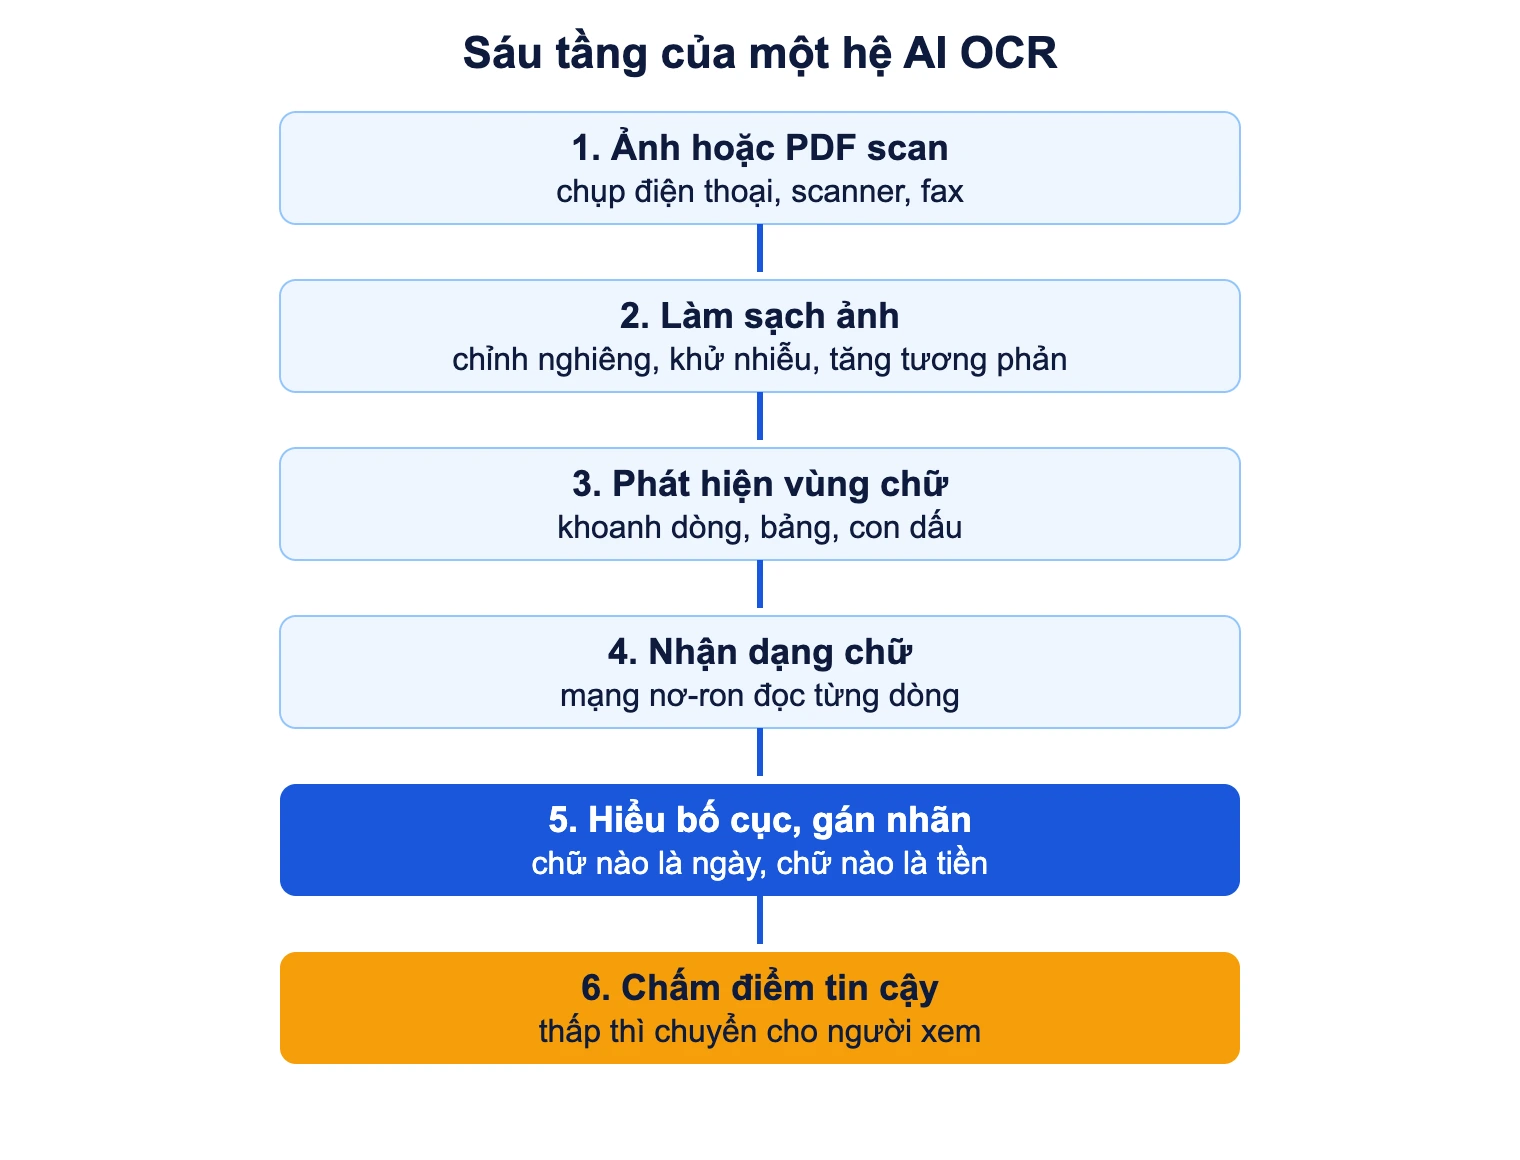
Tầng nhận dạng: đọc cả dòng thay vì từng ký tự
Các hệ cũ cắt từng ký tự rồi nhận dạng, nên lỗi cắt sai (ví dụ hai chữ dính nhau) kéo theo lỗi đọc. Mô hình học sâu hiện đại thường đọc cả dòng ảnh và sinh ra chuỗi ký tự, nên chịu được chữ dính, nét mờ và font lạ tốt hơn. Với tiếng Việt, dấu thanh và dấu mũ làm tăng khó khăn. Phần này có bài riêng về OCR cho tiếng Việt.
Tầng hiểu tài liệu: kết hợp chữ, vị trí và hình ảnh
Đây là phần tạo ra khác biệt khi xử lý hoá đơn, hợp đồng, phiếu. Các mô hình họ LayoutLM, Donut nhận cả ba nguồn tín hiệu: nội dung chữ, toạ độ trên trang và hình ảnh. Nhờ vậy mô hình biết số nằm cạnh nhãn “Tổng cộng” ở cuối bảng là tổng tiền, còn dãy số ở góc trên là số hoá đơn. Một mô hình chỉ đọc văn bản không có thông tin vị trí này.
Hugging Face từng so sánh trên bộ dữ liệu phân loại ảnh tài liệu RVL-CDIP. Kết quả cho thấy việc thêm thông tin bố cục có ích thực sự:
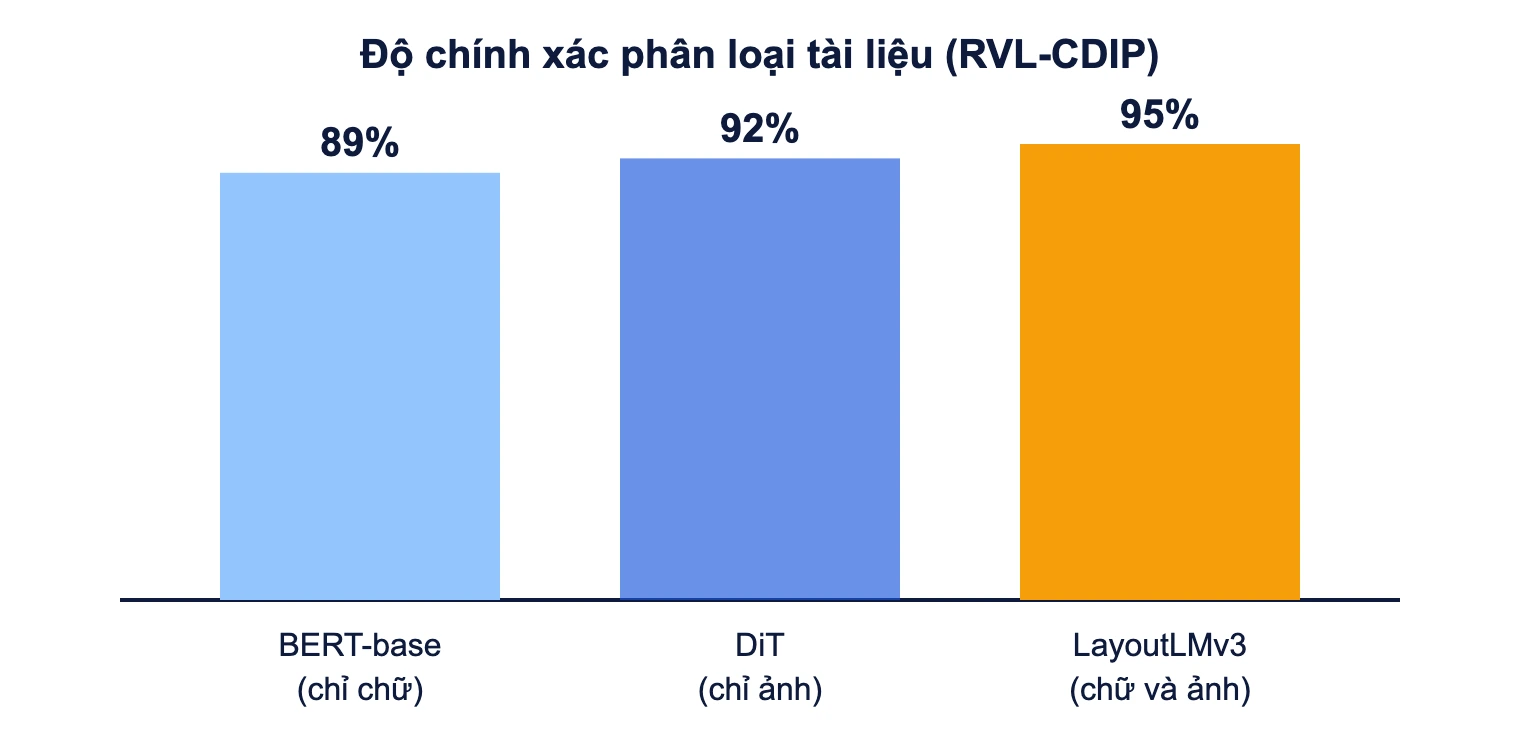
Đừng đọc biểu đồ này như tỷ lệ đúng của OCR trên hoá đơn Việt Nam. Nó chỉ cho thấy xu hướng: thông tin bố cục và hình ảnh giúp mô hình hiểu tài liệu tốt hơn khi chỉ dùng chữ.
Điểm tin cậy và vì sao nó là phần dễ bị bỏ qua?
Hầu hết dịch vụ AI OCR trả về một con số tin cậy (confidence score) cho từng từ hoặc từng trường, thường từ 0 đến 1. Con số này không phải xác suất đúng tuyệt đối. Mỗi nhà cung cấp hiệu chỉnh khác nhau, nên ngưỡng 0,9 ở hệ này không tương đương hệ kia.
Cách dùng đúng là đặt ngưỡng riêng cho từng loại trường, dựa trên dữ liệu thật của bạn. Trường tiền, số tài khoản, mã số thuế cần ngưỡng nghiêm hơn trường tên người bán. Trường nào dưới ngưỡng thì hiển thị cạnh ảnh gốc cho người xem. Cách này giữ chi phí kiểm tra ở mức thấp mà vẫn chặn được lỗi nặng.
Một lỗi nguy hiểm của mô hình sinh văn bản là “đọc ra chữ nghe hợp lý”. Mô hình có thể tự sửa một chữ mờ thành từ thông dụng mà ảnh không hề có. Với số tiền, mã số, ngày tháng, hãy kiểm bằng quy tắc độc lập (tổng các dòng bằng tổng cuối, mã số thuế đúng số chữ số) thay vì chỉ tin điểm tin cậy.
Đo chất lượng AI OCR bằng chỉ số nào?
Quảng cáo thường ghi “chính xác 98%” mà không nói đo trên cái gì. Có ba chỉ số khác nhau, và con số đẹp ở chỉ số này không bảo đảm chỉ số kia:
| Chỉ số | Đo cái gì | Dùng khi | Hạn chế |
|---|---|---|---|
| CER (Character Error Rate) | Tỷ lệ ký tự sai (thêm, mất, thay) so với bản chuẩn | So sánh lõi nhận dạng, đặc biệt với chữ có dấu | Một ký tự sai trong số tiền có hậu quả hơn cả trăm ký tự sai trong địa chỉ |
| WER (Word Error Rate) | Tỷ lệ từ sai | Văn bản dài như công văn, sách | Từ ghép tiếng Việt cho ra kết quả khó so sánh nếu cách tách từ khác nhau |
| Độ chính xác theo trường (field-level accuracy) | Tỷ lệ trường trích ra khớp hoàn toàn với giá trị đúng | Hoá đơn, phiếu, biểu mẫu nhập vào phần mềm | Phải tự dựng bộ dữ liệu chuẩn từ tài liệu của mình |
| Tỷ lệ đi thẳng (straight-through rate) | Phần tài liệu không cần người sửa | Quyết định có cắt giảm nhân công kiểm tra không | Phụ thuộc ngưỡng tin cậy bạn đặt |
Ví dụ minh hoạ: một hoá đơn có 12 trường và hệ thống đọc đúng 11 trường. Nếu trường sai là tổng tiền thì hoá đơn đó vẫn không dùng được, dù CER rất thấp. Vì vậy khi thử nghiệm, hãy chọn vài chục tài liệu thật, nhập tay một bản chuẩn rồi tính độ chính xác theo trường, tách riêng nhóm trường quan trọng về tiền.
AI OCR phân loại thế nào và khác ICR, IDP ra sao?
Các thuật ngữ này hay bị dùng lẫn. Cách nhìn gọn nhất là theo phạm vi công việc:
- OCR phổ thông: chữ in, trả về văn bản.
- ICR (Intelligent Character Recognition): đọc chữ viết tay hoặc chữ in biến thể bằng mô hình học. Chi tiết nằm ở bài nhận dạng chữ viết tay ICR, gồm cả so sánh với OCR và OMR.
- AI OCR: OCR dùng học sâu, có thêm trích trường và điểm tin cậy.
- IDP (Intelligent Document Processing): cả chuỗi từ phân loại tài liệu, trích dữ liệu, kiểm tra, đến chuyển vào hệ thống đích. AI OCR là một thành phần bên trong. Phần so sánh đầy đủ có ở bài xử lý tài liệu thông minh.
Sự khác nhau có hệ quả khi mua. Nếu bạn cần quy trình nhận hoá đơn, đối chiếu đơn hàng rồi chuyển vào phần mềm kế toán, thứ bạn cần là cả chuỗi IDP. Một API AI OCR đơn lẻ sẽ chỉ làm xong bước đầu.
Ví dụ thực tế: AI OCR xử lý tài liệu nào tại doanh nghiệp Việt Nam?
Các tài liệu có cấu trúc lặp lại là nơi AI OCR phát huy rõ nhất:
- Hoá đơn đầu vào: nhà cung cấp mỗi nơi một mẫu, bảng hàng hoá dài ngắn khác nhau. Nếu dùng OCR theo vùng cố định, bạn phải dựng khuôn cho từng nhà cung cấp. AI OCR đọc theo ý nghĩa nên không cần khuôn từng mẫu. Xem thêm cách đọc hoá đơn vào phần mềm.
- Giấy tờ định danh: căn cước công dân có bố cục cố định nhưng ảnh chụp dễ bị chói, nghiêng, che một phần. Mỗi trường như số định danh hay ngày sinh được trích riêng. Do ảnh giấy tờ chứa dữ liệu cá nhân, bạn cần xác định rõ nơi lưu và thời hạn giữ ảnh gốc. Chi tiết ở bài OCR căn cước công dân.
- Phiếu giao nhận, vận đơn: ảnh chụp bằng điện thoại ngoài kho, có dấu mộc đè lên chữ và chữ ký tay. Những lỗi này làm giảm điểm tin cậy nên cần luồng kiểm tra.
- Hồ sơ bồi thường, biểu mẫu giấy: trộn chữ in với chữ viết tay, lúc này cần mô hình xử lý được cả hai.
Để biết các nhóm tài liệu này khác nhau thế nào về cách lấy dữ liệu, hãy xem phần phân tích về các cách trích xuất dữ liệu.
Triển khai AI OCR: dùng dịch vụ đám mây, tự chạy mô hình hay mua phần mềm trọn gói?
Có ba hướng chính. Mỗi hướng phù hợp một hoàn cảnh:
| Hướng | Ví dụ | Điểm mạnh | Điểm cần cân nhắc |
|---|---|---|---|
| API đám mây | Các dịch vụ document AI của nhà cung cấp cloud lớn | Chạy ngay, không cần đội máy học | Ảnh tài liệu rời khỏi hệ thống của bạn. Cần xem tiếng Việt và loại giấy tờ nội địa được hỗ trợ đến đâu |
| Mô hình mã nguồn mở tự chạy | PaddleOCR, Tesseract, họ LayoutLM | Dữ liệu ở trong hệ thống, tuỳ chỉnh được | Cần kỹ sư, cần tập dữ liệu gán nhãn và hạ tầng GPU nếu dùng mô hình lớn |
| Phần mềm trọn gói | Giải pháp trích xuất hoá đơn, định danh của nhà cung cấp trong nước và quốc tế | Đã có giao diện kiểm tra, tích hợp kế toán | Phụ thuộc nhà cung cấp, cần hỏi rõ cách tính phí theo trang, theo tài liệu hay theo trường |
Điểm hay bị bỏ sót: yêu cầu nhà cung cấp chạy thử trên chính tài liệu của bạn, gồm cả các ảnh xấu nhất, thay vì mẫu demo. Hãy hỏi thêm khả năng xuất toạ độ và điểm tin cậy theo trường, vì thiếu hai thứ này bạn khó dựng luồng kiểm tra.
AI OCR có ưu và nhược điểm gì?
Ưu điểm
- Xử lý được tài liệu mới mà không dựng khuôn thủ công cho từng mẫu.
- Chịu được ảnh chụp điện thoại nghiêng, mờ nhẹ, nền nhiễu tốt hơn quy tắc cố định.
- Trả về dữ liệu có cấu trúc, nên nối thẳng vào phần mềm kế toán hay ERP được.
- Có điểm tin cậy để phân luồng kiểm tra, không phải kiểm tra tất cả.
Nhược điểm và rủi ro
- Chất lượng phụ thuộc đầu vào: tầng hiểu bố cục dựa trên kết quả đọc chữ. Chữ đọc sai thì trường gán nhãn cũng sai theo.
- Khó giải thích lỗi: mô hình học sâu không cho biết vì sao nó đọc “8” thành “3”. Bạn chỉ sửa được bằng dữ liệu bổ sung hoặc quy tắc kiểm tra bên ngoài.
- Trôi hiệu năng: khi nhà cung cấp đổi mẫu hoá đơn, chất lượng có thể giảm mà không có cảnh báo.
- Dữ liệu nhạy cảm: gửi ảnh chứa thông tin cá nhân hay tài chính lên dịch vụ ngoài cần kiểm tra nơi xử lý và điều khoản lưu giữ.
- Chi phí ẩn: giá theo trang chỉ là một phần. Còn công kiểm tra, tích hợp và dựng bộ dữ liệu chuẩn.
Khi nào nên và không nên dùng AI OCR?
Nên cân nhắc khi bạn nhận nhiều tài liệu cùng loại nhưng khác mẫu (hoá đơn từ hàng trăm nhà cung cấp, phiếu từ nhiều kho), và dữ liệu cần vào phần mềm có cấu trúc. Khi đó chi phí dựng khuôn cho từng mẫu thường lớn hơn chi phí dùng mô hình đọc theo ý nghĩa.
Chưa cần khi tài liệu chỉ có vài mẫu cố định, hoặc khối lượng thấp đến mức nhập tay vẫn rẻ hơn tích hợp. Đừng mua AI OCR khi bạn chưa có tài liệu số hoá ổn định. Nếu ảnh vẫn chụp tuỳ tiện, hãy sửa khâu thu nhận ảnh trước, vì độ phân giải, ánh sáng và góc chụp ảnh hưởng đến kết quả nhiều hơn việc đổi mô hình. Quy trình quét chuẩn có trong bài số hoá tài liệu.
Nếu hiện công việc đang do bộ phận nhập liệu làm, hãy so khối lượng thực với nhịp làm việc của họ. Bài nhập liệu và quy trình data entry giúp bạn hình dung phần việc nào có thể chuyển sang máy.
Câu hỏi thường gặp
AI OCR có đọc được chữ viết tay không?
Một số mô hình đọc được, nhưng chất lượng thường thấp hơn chữ in và dao động mạnh theo từng người viết. Với trường quan trọng như số tiền hay số định danh viết tay, nên bắt buộc có người xác nhận. Nếu chữ viết tay là phần chính, hãy xem hệ thống chuyên về ICR.
AI OCR và OCR thường khác nhau lớn nhất ở điểm nào?
Ở đầu ra và khả năng thích nghi. OCR thường trả văn bản thô và cần quy tắc vị trí do bạn viết. AI OCR trả về trường có nhãn, kèm điểm tin cậy, và xử lý được mẫu tài liệu chưa gặp. Về lõi đọc chữ, hai loại có thể dùng chung kỹ thuật học sâu, nên đừng chỉ dựa vào nhãn “AI”.
Con số độ chính xác 98 đến 99 phần trăm trong quảng cáo có đáng tin không?
Chỉ đáng tin khi bạn biết nó đo trên tập dữ liệu nào, theo ký tự hay theo trường. Con số trên ảnh scan sạch không áp dụng cho ảnh chụp điện thoại ngoài kho. Cách chắc chắn nhất là thử trên mẫu tài liệu thật của bạn và tính độ chính xác theo trường.
AI OCR có cần dữ liệu để huấn luyện riêng không?
Nhiều dịch vụ dùng được ngay mô hình có sẵn. Huấn luyện bổ sung cần thiết khi tài liệu của bạn có bố cục đặc thù, ví dụ biểu mẫu nội bộ hoặc chứng từ ngành. Lúc đó bạn cần vài trăm đến vài nghìn trang gán nhãn tuỳ độ phức tạp. Hãy hỏi nhà cung cấp cụ thể con số họ yêu cầu.
AI OCR có thay thế hoàn toàn người kiểm tra không?
Thường không. Hệ thống tốt giảm số tài liệu phải xem, chứ không đưa lỗi về không. Trường liên quan tiền, thuế và định danh vẫn nên có bước đối chiếu bằng quy tắc hoặc bằng người.
Dùng AI OCR trên ảnh giấy tờ cá nhân cần lưu ý gì?
Hãy xác định rõ trường nào thực sự cần lưu (thường chỉ vài trường, không phải toàn bộ ảnh), nơi xử lý ảnh ở trong nước hay nước ngoài, và thời hạn xoá ảnh gốc sau khi trích xong. Nếu thuê dịch vụ ngoài, hợp đồng cần ghi vai trò xử lý dữ liệu của bên cung cấp.
Bài viết thuộc chuyên mục OCR & xử lý tài liệu trên blog công nghệ VBPO, trang tin tức và kiến thức công nghệ cho doanh nghiệp Việt Nam về AI, dữ liệu, blockchain, chuyển đổi số và tự động hoá.