
Trả lời nhanh: Nhập liệu tiếng Nhật là gõ hoặc đối chiếu dữ liệu có kanji, hiragana, katakana vào hệ thống. Bạn cần bộ gõ IME, quy ước chiều rộng ký tự, chuẩn họ tên, địa chỉ, ngày theo niên hiệu, xuất file đúng bảng mã và kiểm tra chéo. Chữ in có thể dùng OCR, chữ viết tay cần người duyệt.
Điểm chính
- Gõ được tiếng Nhật chưa đủ. Phần lớn lỗi nằm ở chiều rộng ký tự, chữ kanji đồng dạng, ngày Reiwa và bảng mã khi xuất file.
- Mỗi loại trường (họ tên, furigana, địa chỉ, điện thoại, ngày) cần một quy ước viết ra giấy trước khi nhập.
- OCR hợp với chữ in, scan từ 300 dpi. Chữ viết tay và chữ dọc cần ICR kèm người duyệt.
- Đo chất lượng theo tỷ lệ trường sai, không theo số dòng đã nhập.
Mục lục
- Nhập liệu tiếng Nhật gồm những việc gì?
- Cài bộ gõ và phím tắt nào để nhập nhanh?
- Những quy ước nào khiến dữ liệu tiếng Nhật hay sai nhất?
- Quy trình nhập một lô phiếu tiếng Nhật gồm những bước nào?
- Vì sao file tiếng Nhật xuất ra bị hiện ký tự lạ?
- Khi nào dùng OCR thay vì gõ tay?
- Làm sao kiểm soát chất lượng dữ liệu tiếng Nhật?
- Tự tuyển nhân viên hay thuê ngoài nhập liệu tiếng Nhật?
- Câu hỏi thường gặp
Nhập liệu tiếng Nhật gồm những việc gì?
Cụm từ này có hai nhóm người tìm. Nhóm thứ nhất là ứng viên muốn làm việc nhập liệu cho khách hàng Nhật. Nhóm thứ hai là doanh nghiệp đang nhận phiếu, hoá đơn, đơn hàng, hồ sơ bằng tiếng Nhật và cần đưa vào phần mềm. Bài này viết cho cả hai nhóm, vì cả hai đều gặp chung một bộ lỗi.
Các tin tuyển dụng hiện nay cho thấy phạm vi công việc khá cụ thể. Một tin mô tả việc nhập dữ liệu bằng tiếng Nhật như số liệu và thông tin khách hàng, kèm trao đổi email với người Nhật. Một tin khác yêu cầu nhập và kiểm tra dữ liệu liên quan đến thiết bị điện tử, sản phẩm công nghệ của Nhật Bản. Về trình độ, nhiều tin yêu cầu tiếng Nhật từ N3, có tin nâng lên N2 khi cần giao tiếp với khách hàng, ví dụ tin tuyển dụng quản lý khách sạn và ryokan.
Tức là nhập liệu tiếng Nhật không đơn thuần là đánh máy. Bạn phải đọc được kanji đủ để biết mình đang nhập trường nào, và phải biết hệ thống đích chấp nhận ký tự dạng nào. Nếu chưa rõ nghề nhập liệu nói chung gồm những gì, bạn có thể đọc các loại data entry và quy trình trước, rồi quay lại phần đặc thù tiếng Nhật ở đây.
Cài bộ gõ và phím tắt nào để nhập nhanh?
Trên Windows, bạn thêm ngôn ngữ Japanese trong phần Language & region của Settings, bảo đảm gói bộ gõ Microsoft IME được cài. Dùng phím Windows + Space để chuyển giữa tiếng Việt, tiếng Anh và tiếng Nhật. Khi đã ở bộ gõ Nhật, bạn gõ romaji, bộ gõ đổi thành kana, rồi bạn chọn chữ kanji phù hợp.
Thao tác cơ bản với Microsoft IME:
- Gõ nihongo, nhấn Space để đổi thành 日本語, nhấn Space thêm lần nữa để xem danh sách ứng viên, nhấn Enter để xác nhận.
- Âm ん gõ nn. Âm ngắt っ gõ bằng cách lặp phụ âm sau nó (gõ kitte ra きって). Trường hợp bộ gõ không tự nhận, dùng ltu hoặc xtu.
- Âm kéo dài ー gõ bằng phím gạch ngang.
- Bàn phím không có phím 半角/全角 thì dùng Alt + ~ để bật tắt giữa gõ tiếng Nhật và gõ trực tiếp.
| Phím (khi đang gõ chưa xác nhận) | Kết quả | Dùng khi nào |
|---|---|---|
| F6 | Hiragana | Ô họ tên viết bằng hiragana |
| F7 | Katakana toàn rộng | Ô フリガナ, tên công ty nước ngoài |
| F8 | Katakana nửa rộng | Hệ thống cũ chỉ nhận nửa rộng |
| F9 | Chữ Latin toàn rộng | Ô yêu cầu ABC toàn rộng |
| F10 | Chữ Latin nửa rộng | Mã sản phẩm, email, số |
Nên tập F6 đến F10 ngay từ đầu. Nhân viên mới thường gõ lại cả từ khi gõ nhầm kiểu chữ, trong khi một lần nhấn F7 là đủ. Ngoài ra hãy thêm vào từ điển người dùng của IME các tên riêng khách hàng hay gặp, để lần sau chỉ cần gõ âm đọc.
Những quy ước nào khiến dữ liệu tiếng Nhật hay sai nhất?
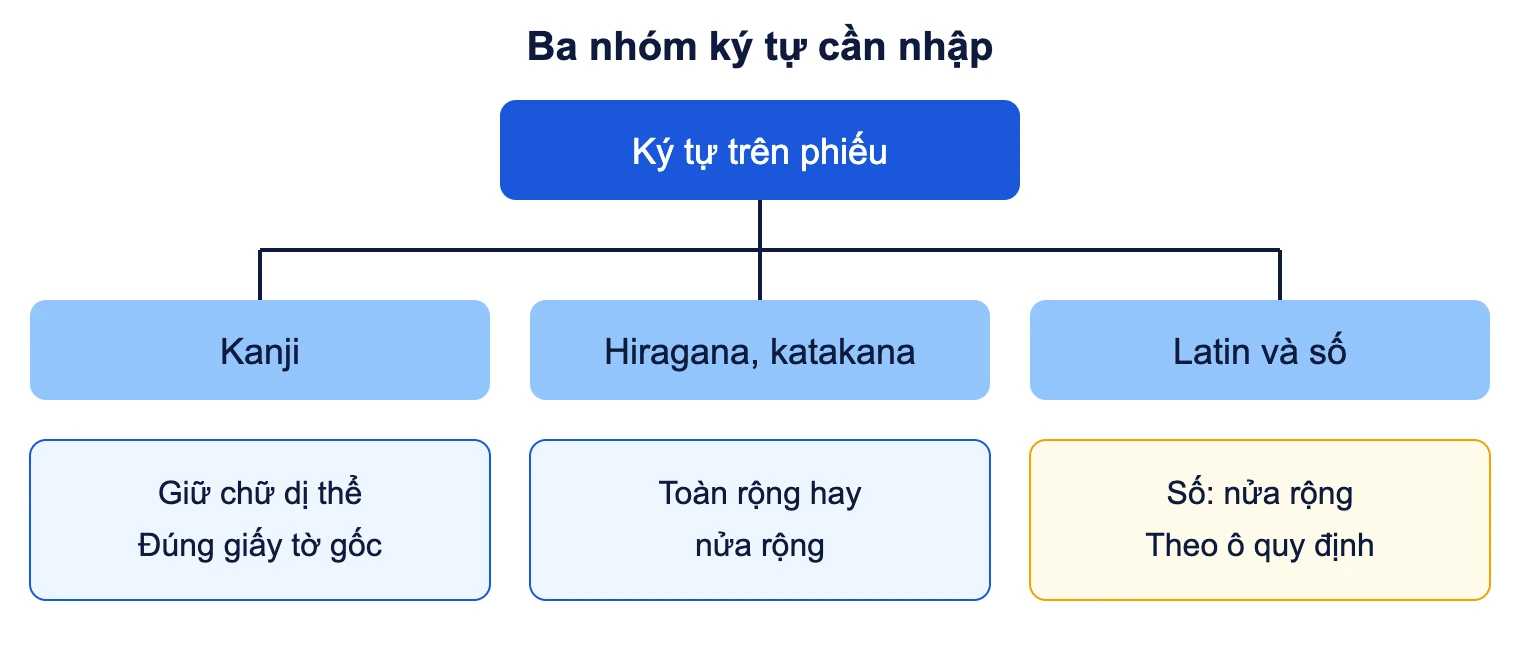
Lỗi thường không đến từ gõ sai chữ. Chúng đến từ việc nhập đúng chữ nhưng sai dạng. Bảng dưới liệt kê các trường hay gặp và điểm cần thống nhất với khách trước khi nhập.
| Trường | Điểm cần thống nhất | Lỗi thường gặp |
|---|---|---|
| Họ tên | Họ và tên cách nhau bằng khoảng trắng toàn rộng, nửa rộng hay không cách; giữ nguyên chữ trên giấy tờ | Đổi 髙 thành 高, 﨑 thành 崎, 齋 thành 斎 vì “trông giống” |
| フリガナ (cách đọc) | Katakana toàn rộng hay hiragana; ghi theo phiếu, không tự đoán cách đọc kanji | Tên có nhiều cách đọc, nhân viên điền theo cách phổ biến |
| Địa chỉ | Thứ tự từ lớn đến nhỏ: tỉnh, thành phố, quận, số khu phố; mã bưu chính 7 chữ số | Gộp tên toà nhà vào dòng số nhà, mất dấu gạch nối |
| Ngày tháng | Giữ niên hiệu như trên phiếu hay đổi sang dương lịch; quy ước ghi cột riêng | Nhầm năm Reiwa với dương lịch |
| Điện thoại | Có gạch nối hay không; số quốc tế bỏ số 0 đầu sau +81 | Nhập số 0 thừa, dán khoảng trắng toàn rộng |
| Số tiền, số lượng | Nửa rộng, có dấu phẩy ngăn cách hay không; ký hiệu ¥ hoặc 円 | Nhập 123 toàn rộng, hệ thống không nhận ra là số |
Niên hiệu: đổi sang dương lịch thế nào
Phiếu Nhật hay ghi ngày theo niên hiệu như 令和8年10月12日. Niên hiệu Reiwa bắt đầu từ 1/5/2019, nên năm Reiwa 1 là 2019 và Reiwa 8 là 2026. Cách đổi: lấy số năm Reiwa cộng 2018. Năm Heisei 31 (2019) trùng với Reiwa 1 nên tháng 1 đến 4/2019 vẫn là Heisei. Khi gặp ngày sinh cũ thuộc Showa hoặc Heisei, hãy đối chiếu bảng niên hiệu chứ không cộng nhẩm theo công thức Reiwa.
Kanji đồng dạng và chữ dị thể
Tên người Nhật có chữ dị thể, ví dụ 髙 (hashigo-daka) so với 高. Hệ thống đích có thể không có ký tự này, hoặc có nhưng khoá chính của khách hàng lại phân biệt hai chữ. Quy tắc an toàn là nhập đúng chữ trên giấy tờ gốc nếu hệ thống hỗ trợ, nếu không thì ghi cờ “chữ dị thể” ở cột ghi chú và không thay chữ im lặng.
Quy trình nhập một lô phiếu tiếng Nhật gồm những bước nào?
Quy trình dưới đây áp dụng cho lô phiếu giấy hoặc PDF scan, nhập vào phần mềm đích của khách hoặc vào file Excel.
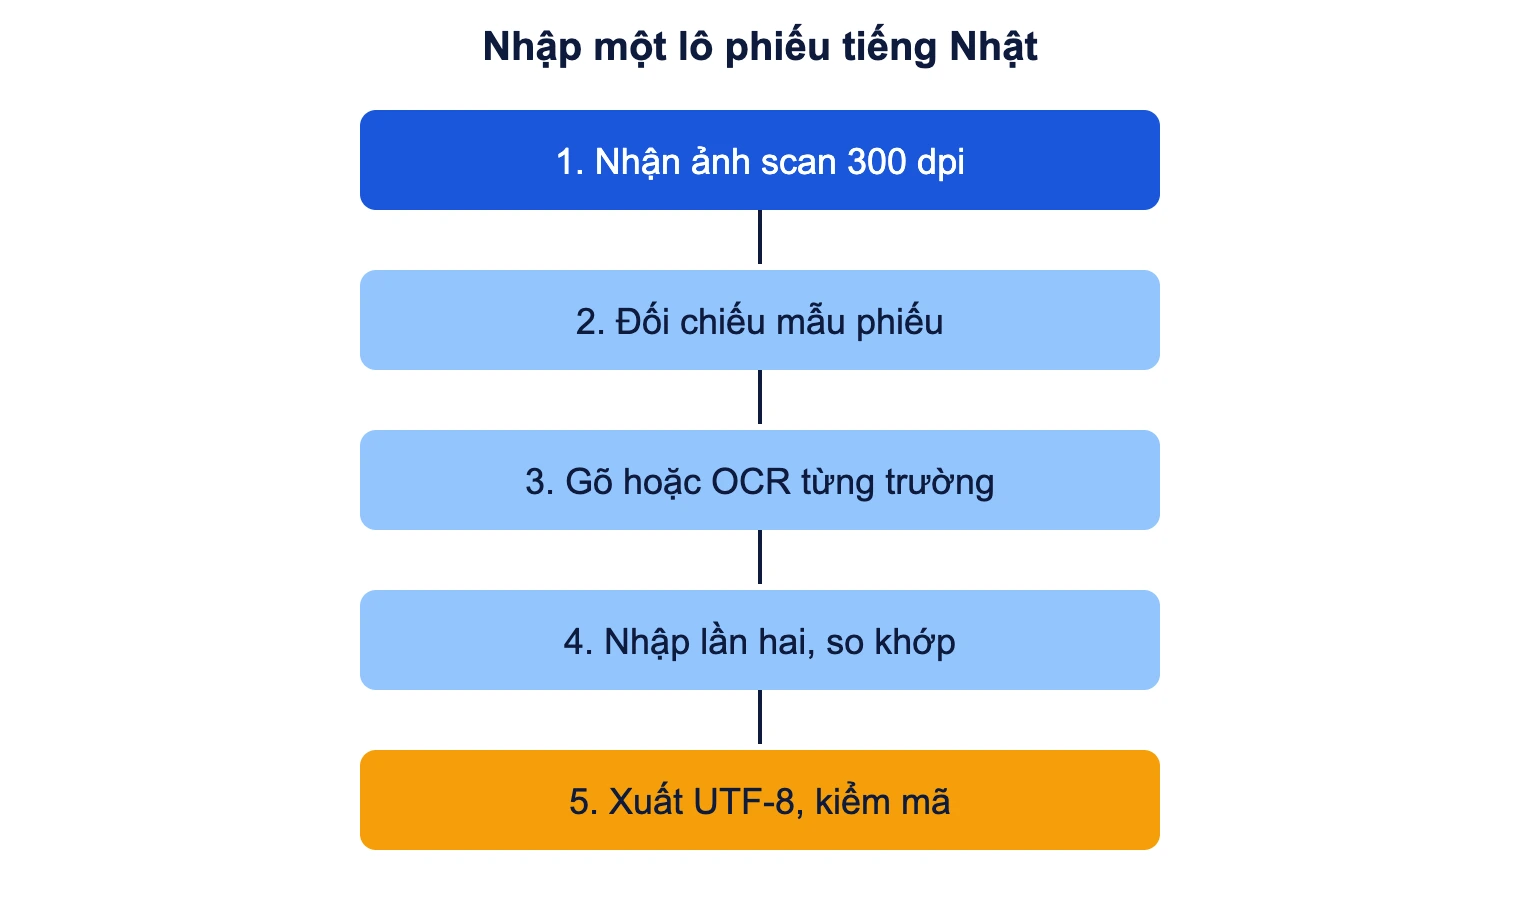
- Nhận ảnh. Kiểm tra độ phân giải trước khi nhập. Hướng dẫn OCR tiếng Nhật thường khuyến nghị ít nhất 300 DPI cho tài liệu in. Ảnh chụp điện thoại bị nghiêng hoặc lóa nên trả lại để quét lại, đừng cố đọc.
- Đối chiếu mẫu phiếu. Với mỗi loại phiếu, ghi một bảng gồm tên trường, chiều rộng ký tự, độ dài tối đa, trường bắt buộc. Một người đọc tiếng Nhật tốt lập bảng này một lần, người nhập sau đó dùng lại.
- Nhập từng trường. Nhập theo thứ tự trên phiếu để mắt không phải nhảy. Ô không đọc được thì đánh dấu cờ, không đoán.
- Nhập lần hai hoặc đối chiếu. Người thứ hai nhập độc lập các trường quan trọng (họ tên, số tiền, số hợp đồng, ngày). Hệ thống hoặc công thức Excel so hai cột, chỉ trường lệch mới được xem lại.
- Xuất file và kiểm mã. Mở lại file đã xuất bằng chính công cụ phía nhận. Mục sau giải thích vì sao bước này tránh được nhiều lỗi nhất.
Với phiếu có vùng chọn ô tròn hoặc ô vuông (khảo sát, phiếu đăng ký), phần đó không cần gõ tay. Công nghệ nhận dạng dấu tích OMR đọc các ô đánh dấu nhanh hơn người.
Vì sao file tiếng Nhật xuất ra bị hiện ký tự lạ?
Hiện tượng chữ biến thành ký tự vô nghĩa gọi là mojibake. Nguyên nhân thường là file được lưu bằng một bảng mã và mở bằng bảng mã khác. Hai bảng mã bạn gặp nhiều nhất là UTF-8 và Shift_JIS (hoặc biến thể CP932 của Windows, vốn còn thấy ở phần mềm kế toán và nghiệp vụ Nhật đời cũ).
- CSV mở bằng Excel. Excel bản Windows có thể hiểu file CSV UTF-8 không có BOM theo bảng mã cục bộ và hiển thị sai chữ. Cách xử lý thường dùng là lưu bằng định dạng CSV UTF-8, hoặc nhập qua chức năng Data của Excel và chọn đúng bảng mã.
- Ký tự đặc biệt. Dấu ngã dạng sóng 〜 và ~ trông gần giống nhưng là hai mã khác nhau, và chuyển đổi giữa Shift_JIS với Unicode có thể làm đổi ký tự. Ký hiệu một ký tự như ㈱ hay số khoanh tròn cũng có thể mất khi hệ thống đích không hỗ trợ. Với tên công ty, hãy thống nhất viết 株式会社 đủ chữ.
- Độ dài trường. Nhiều hệ thống đếm theo byte chứ không theo ký tự. Chữ kanji chiếm nhiều byte hơn chữ Latin, nên một tên dài vẫn có thể bị cắt cụt.
Phía nhận cần cho biết bảng mã và quy ước ngắt dòng mong muốn bằng văn bản. Nếu họ không nêu, hãy gửi một file mẫu hai ba dòng có kanji, katakana và ký tự đặc biệt để họ mở thử trước khi gửi cả lô.
Khi nào dùng OCR thay vì gõ tay?
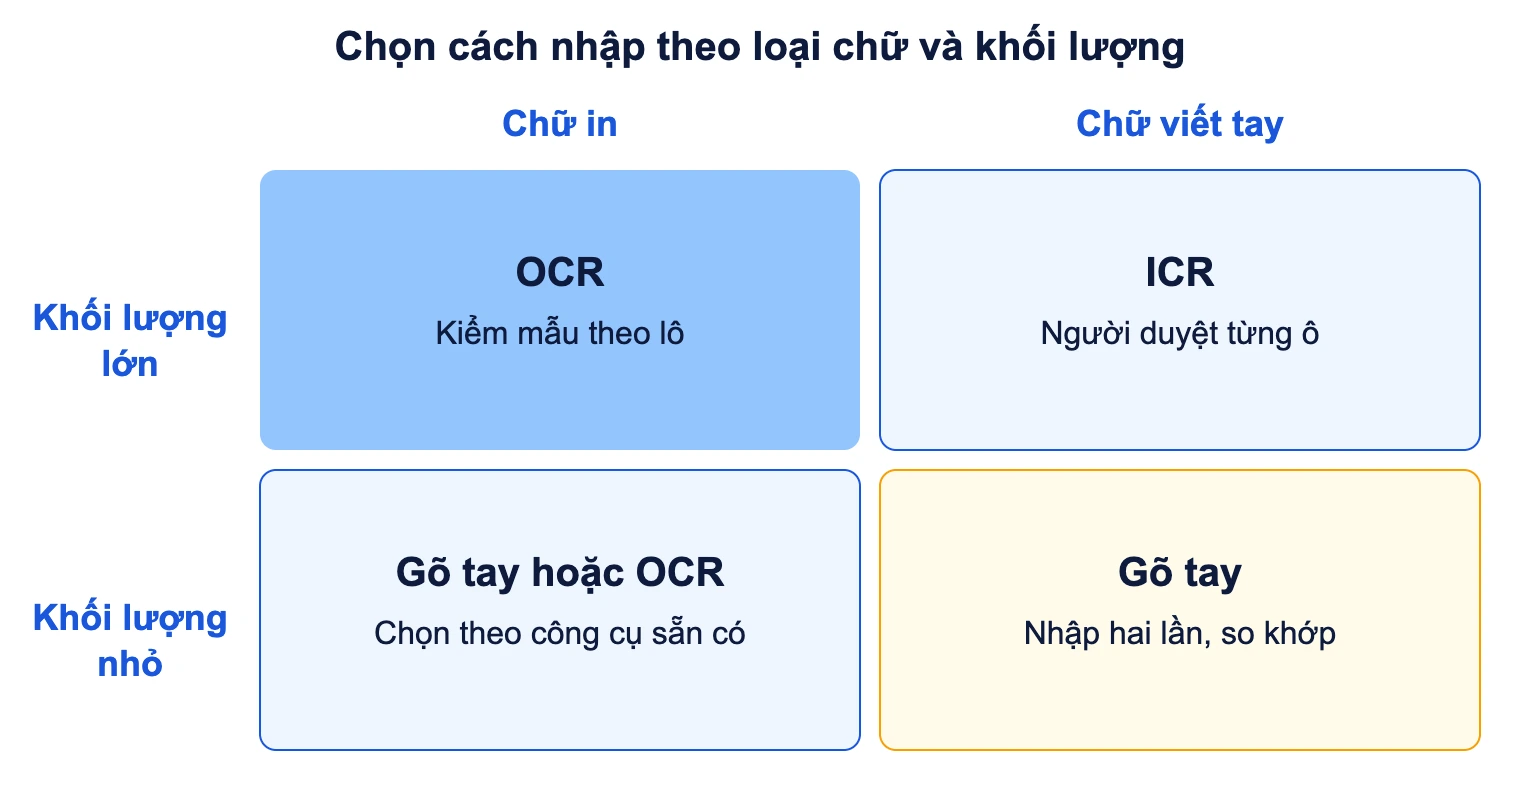
Tiếng Nhật là ngôn ngữ khó với OCR vì ba hệ chữ cùng xuất hiện trong một câu. Một hướng dẫn kỹ thuật nhận xét hiragana dạng nét nối nên khó tách ký tự hơn chữ khối, còn katakana có nhiều chữ dễ nhầm với nhau. Phần lớn công cụ cũng gặp khó với chữ viết tay, chữ nghệ thuật hoặc thư pháp. Vì thế quyết định dựa trên hai điều: phiếu in hay viết tay, và khối lượng lớn hay nhỏ.
Mẹo cấu hình để OCR tiếng Nhật đọc tốt hơn
- Chọn ngôn ngữ Japanese cụ thể, không để tự nhận diện. Nguồn kỹ thuật cũng khuyên chọn tiếng Nhật rõ ràng thay vì auto-detect.
- Chữ dọc (tategaki) cần công cụ hỗ trợ đọc từ trên xuống. Phiếu kiểu cũ, hợp đồng, phong bì còn dùng chữ dọc.
- Cắt vùng theo trường trước khi OCR. Một khung nhỏ chứa riêng ô họ tên cho kết quả sạch hơn so với đọc cả trang rồi tách.
- Tách hai đường xử lý cho các ô số, ngày và mã, vì lỗi nhầm chữ số với kana, hoặc 0 với O, thường nằm ở nhóm này.
OCR tiếng Nhật còn khác OCR tiếng Việt ở chỗ không có dấu thanh, nhưng lại có hàng nghìn ký tự đồng dạng; chi tiết phía tiếng Việt xem ở bài OCR tiếng Việt. Với chữ viết tay, nguyên lý và giới hạn nằm trong bài ICR nhận dạng chữ viết tay. Nếu khối lượng phiếu đủ lớn và có nhiều mẫu khác nhau, nền tảng xử lý tài liệu thông minh IDP ghép OCR, phân loại và đối chiếu trong một luồng.
Kết quả OCR cho kanji hiếm hoặc tên riêng vẫn cần người đọc tiếng Nhật xác nhận. Công cụ không biết đáp án nào đúng với tên của một người cụ thể, nó chỉ chọn chữ có xác suất cao nhất.
Làm sao kiểm soát chất lượng dữ liệu tiếng Nhật?
Đo chất lượng theo trường, không theo dòng. Một phiếu 30 trường sai một trường vẫn là phiếu sai, nhưng cách tính đó che mất việc trường nào sai nhiều. Hãy ghi nhật ký lỗi gồm mã phiếu, tên trường, giá trị nhập, giá trị đúng, nguyên nhân, rồi tính tỷ lệ trường sai = số trường sai chia tổng trường đã nhập, tách riêng cho từng loại trường.
Các nguyên nhân hay lặp lại và cách xử lý:
- Sai chiều rộng ký tự: thêm quy tắc kiểm tra tự động trong Excel hoặc biểu mẫu nhập, ví dụ cột số điện thoại chỉ cho phép chữ số nửa rộng và dấu gạch nối.
- Nhầm chữ đồng âm: 橋 và 箸, 以外 và 意外 đều đọc giống nhau. Khi gõ bằng âm đọc, người nhập chọn nhầm ứng viên. Cách giảm là xây từ điển tên khách hàng, và đọc lại trường quan trọng theo hình chữ trên phiếu, không theo âm.
- Nhầm nét chữ viết tay: các cặp như ソ và ン, シ và ツ trong katakana dễ lẫn khi viết nhanh. Cần có cột “chưa chắc” để đẩy sang người đọc tiếng Nhật tốt hơn.
- Lệch quy ước giữa hai người nhập: khi hai người cho hai kết quả khác nhau, người quản lý ghi quy ước vào bảng trường chứ không chỉ sửa một dòng.
Với dữ liệu khách hàng có số liên quan đến cá nhân, ví dụ họ tên kèm địa chỉ, ngày sinh hoặc số định danh cá nhân, phạm vi truy cập phải giới hạn theo từng lô. Hợp đồng với đối tác Nhật thường kèm điều khoản bảo mật theo Luật Bảo vệ thông tin cá nhân của Nhật (APPI). Hãy kiểm tra điều khoản này cụ thể trong hợp đồng của bạn, vì nghĩa vụ xoá ảnh scan sau khi nhập có thể khác nhau giữa các khách hàng.
Tự tuyển nhân viên hay thuê ngoài nhập liệu tiếng Nhật?
Với khối lượng ổn định và dữ liệu nhạy cảm, tự tuyển giúp bạn kiểm soát truy cập. Với khối lượng biến động theo mùa, đơn vị chuyên làm có sẵn ca làm và quy trình kiểm hai lần. Tuyển dụng phổ biến đặt mốc N3 cho vị trí nhập liệu thuần tuý và N2 khi phải trao đổi với khách. Kết quả tìm kiếm cho thấy có những tin còn chấp nhận sinh viên mới ra trường, nghĩa là kinh nghiệm không phải rào cản lớn, và độ chính xác mới là thứ phải thử.
Khi phỏng vấn, cho ứng viên làm một bài thử 20 phút, gồm: gõ một đoạn có kanji hiếm, đổi một ngày Reiwa sang dương lịch, nhập một địa chỉ Nhật có tên toà nhà và chuyển 3 trường toàn rộng sang nửa rộng. Bài này kiểm tra đúng kỹ năng của công việc, không chỉ tốc độ gõ. Mô tả chung về vai trò xem ở bài nhân viên nhập liệu. Nếu cân nhắc giao cho bên ngoài, mô hình thuê ngoài nhập liệu nêu rõ phần việc nên giao và phần nên giữ.
Câu hỏi thường gặp
Nhập liệu tiếng Nhật có bắt buộc phải có N3 không?
Không có quy định chung. Chuẩn này do từng nhà tuyển dụng đặt. Các tin hiện nay hay ghi N3 cho nhập liệu và N2 khi cần giao tiếp với khách. Nếu bạn chỉ chép giá trị có sẵn từ phiếu in, mức đọc kanji vừa đủ nhận ra trường dữ liệu cũng có thể đáp ứng, miễn là có người kiểm tra.
Gõ tiếng Nhật trên bàn phím tiếng Việt được không?
Được. Bạn không cần bàn phím Nhật. Thêm bộ gõ Japanese trên Windows hoặc macOS, gõ romaji và dùng Space để chọn chữ. Phím chuyển chế độ thay bằng Alt + ~ khi không có phím 半角/全角.
Vì sao số điện thoại hoặc số tiền nhập vào hệ thống bị báo lỗi?
Nguyên nhân thường gặp là số được nhập ở dạng toàn rộng (123), hệ thống coi đó là chữ chứ không phải số. Bạn đổi sang nửa rộng bằng F10 trong lúc gõ, hoặc dùng hàm chuyển đổi trong Excel trước khi xuất.
OCR có đọc được chữ viết tay tiếng Nhật không?
Có công cụ làm được ở mức hạn chế, nhưng với kanji viết tay, kết quả cần người duyệt. Nếu phiếu có ô riêng cho từng chữ, độ chính xác tốt hơn so với chữ viết liền. Quyết định theo mẫu thật của bạn: thử trên một lô phiếu cũ và so với bản người nhập.
Mở file CSV tiếng Nhật bằng Excel bị lỗi chữ thì làm sao?
Đây thường là lệch bảng mã. Thử nhập file bằng chức năng lấy dữ liệu từ văn bản của Excel và chọn đúng bảng mã (UTF-8 hoặc Shift_JIS), hoặc yêu cầu bên gửi xuất lại ở CSV UTF-8. Không sửa tay từng ô vì chữ đã sai ở cấp mã.
Có nên chuyển hết tên kanji sang romaji cho dễ nhập?
Không nên nếu hệ thống đích hoặc khách hàng cần kanji gốc. Romaji làm mất thông tin: nhiều kanji khác nhau cho cùng một cách đọc. Nếu cần cả hai, dùng thêm cột phiên âm và giữ nguyên cột kanji.
Bài viết thuộc chuyên mục OCR & xử lý tài liệu trên blog công nghệ VBPO, trang tin tức và kiến thức công nghệ cho doanh nghiệp Việt Nam về AI, dữ liệu, blockchain, chuyển đổi số và tự động hoá.