Trả lời nhanh: Dữ liệu huấn luyện AI là tập mẫu (văn bản, ảnh, âm thanh, bảng số liệu) mà mô hình dùng để học quy luật. Với học có giám sát, mỗi mẫu gồm đầu vào kèm đáp án đúng (nhãn). Mô hình chỉ giỏi trong phạm vi những gì dữ liệu này bao phủ.
Điểm chính
- Dữ liệu huấn luyện là “bài tập có đáp án” để mô hình chỉnh tham số, khác với dữ liệu kiểm định và kiểm thử.
- Một bộ dữ liệu thường được chia thành ba tập: huấn luyện, kiểm định, kiểm thử.
- Lỗi nhãn, lệch phân bố và rò rỉ dữ liệu giữa các tập là ba nguyên nhân phổ biến khiến mô hình chạy tốt khi thử nhưng sai khi dùng thật.
- Dữ liệu tổng hợp có ích nhưng không nên thay hoàn toàn dữ liệu thật.
Mục lục
- Dữ liệu huấn luyện AI là gì?
- Mô hình học từ dữ liệu huấn luyện như thế nào?
- Dữ liệu huấn luyện, kiểm định và kiểm thử khác nhau thế nào?
- Dữ liệu huấn luyện gồm những loại nào?
- Dữ liệu huấn luyện đến từ đâu?
- Điều gì làm một bộ dữ liệu huấn luyện tốt?
- Bao nhiêu dữ liệu là đủ?
- Dữ liệu tổng hợp có thay được dữ liệu thật không?
- Ứng dụng cho doanh nghiệp Việt: ba tình huống
- Ưu điểm và hạn chế của cách học từ dữ liệu huấn luyện
- Khi nào nên và không nên tự xây bộ dữ liệu huấn luyện?
- Câu hỏi thường gặp
Dữ liệu huấn luyện AI là gì?
Dữ liệu huấn luyện (training data) là tập hợp các ví dụ được đưa cho một mô hình học máy để nó tự điều chỉnh các tham số bên trong, sao cho dự đoán ngày càng gần với kết quả đúng. Theo cách mô tả phổ biến, trong học có giám sát (supervised learning), tập này gồm các mẫu đầu vào ghép với nhãn đầu ra tương ứng, để mô hình học mối quan hệ giữa hai phần đó.
Ví dụ minh hoạ: một công ty logistics muốn mô hình đoán đơn hàng nào sẽ giao trễ. Mỗi dòng dữ liệu huấn luyện gồm tuyến đường, khung giờ lấy hàng, khối lượng, thời tiết (đầu vào) và một cột “trễ / đúng hẹn” (nhãn). Mô hình không được lập trình quy tắc “mưa thì trễ”. Nó tự rút ra mức ảnh hưởng của từng yếu tố từ hàng nghìn dòng như vậy.
Cần phân biệt ba khái niệm hay bị gộp làm một:
- Dữ liệu thô là dữ liệu vừa thu về, chưa xử lý. Dữ liệu huấn luyện là phần đã được chọn lọc, làm sạch và (nếu cần) gán nhãn từ đó.
- Dữ liệu huấn luyện khác dữ liệu đầu vào khi vận hành. Sau khi triển khai, mô hình nhận dữ liệu mới để dự đoán, không học thêm từ nó (trừ khi bạn chủ động huấn luyện lại).
- Dữ liệu tri thức trong chatbot (tài liệu nội bộ mà chatbot tra cứu khi trả lời) không tự động là dữ liệu huấn luyện. Tra cứu và huấn luyện là hai cơ chế khác nhau.
Mô hình học từ dữ liệu huấn luyện như thế nào?
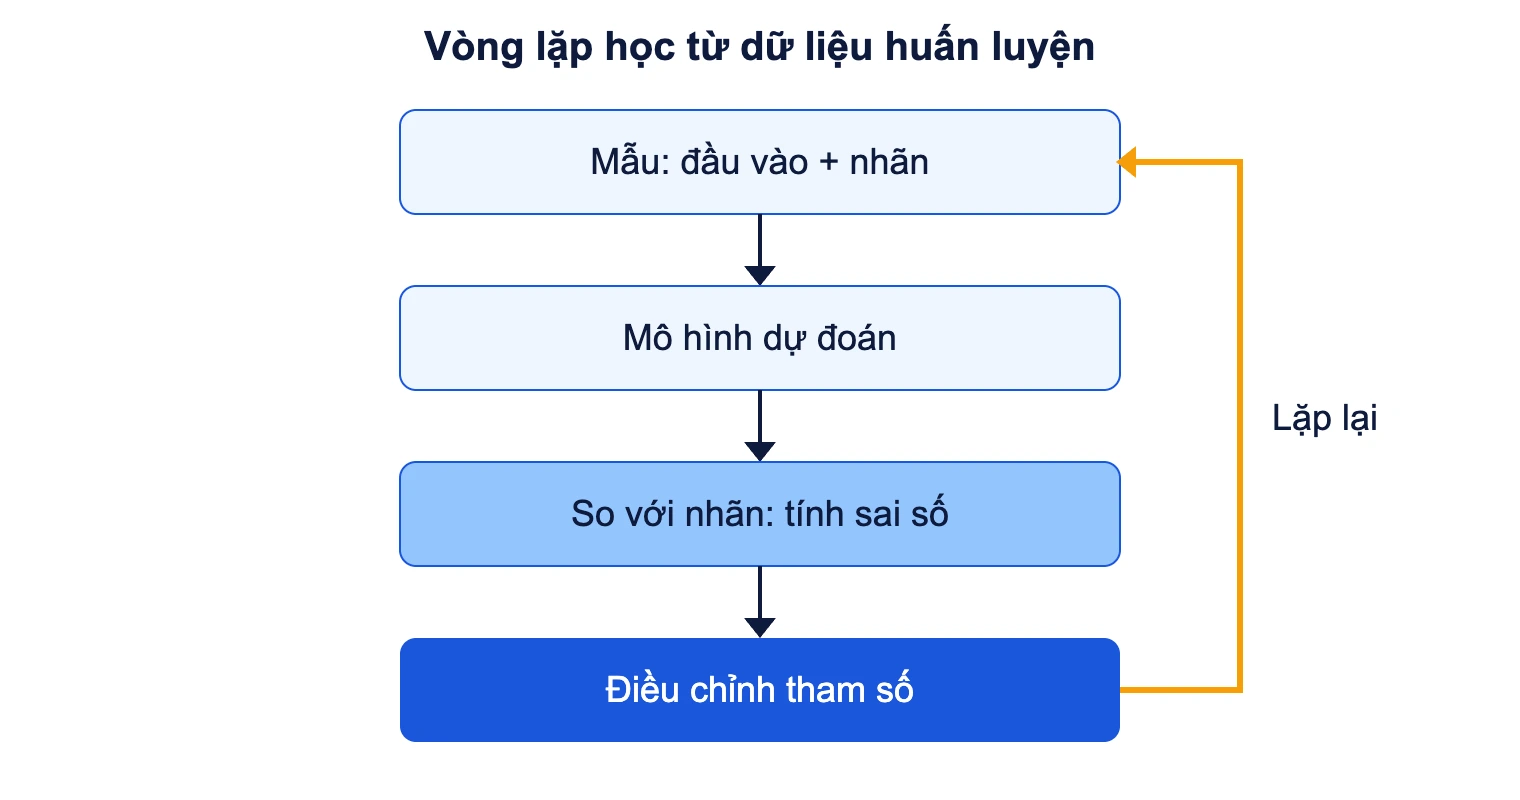
Quá trình học là một vòng lặp. Mô hình nhận một mẫu, đưa ra dự đoán, so với đáp án để tính sai số (hàm mất mát, loss), rồi chỉnh tham số theo hướng làm sai số giảm. Vòng này lặp lại qua toàn bộ tập, nhiều lượt (mỗi lượt gọi là một epoch). Nhờ vậy mô hình điều chỉnh tham số nội bộ để giảm chênh lệch giữa dự đoán và kết quả thực, rồi khái quát được cho dữ liệu mới.
Hệ quả quan trọng: mô hình không “hiểu” nghiệp vụ của bạn, nó khớp với các quy luật thống kê có trong tập mẫu. Nếu tập mẫu chỉ có đơn hàng nội thành, mô hình sẽ đoán tuyến liên tỉnh bằng những quy luật học từ nội thành, và sai một cách tự tin. Bài về học chuyển giao giải thích cách tận dụng mô hình đã học sẵn để giảm lượng dữ liệu cần có.
Dữ liệu huấn luyện, kiểm định và kiểm thử khác nhau thế nào?
Một bộ dữ liệu thường được chia làm ba phần với ba vai trò khác nhau. Việc dùng lẫn là lỗi kinh điển khiến báo cáo độ chính xác đẹp hơn thực tế.
| Tập | Mô hình dùng để làm gì | Ai nhìn thấy | Dấu hiệu dùng sai |
|---|---|---|---|
| Huấn luyện (training) | Học và chỉnh tham số | Mô hình thấy trực tiếp | Độ chính xác trên tập này cao nhưng tụt mạnh ở tập khác (quá khớp, overfitting) |
| Kiểm định (validation) | Chọn thuật toán, chỉnh siêu tham số, quyết định lúc dừng huấn luyện | Người xây mô hình xem nhiều lần | Chỉnh quá nhiều lần theo tập này khiến nó gián tiếp thành tập huấn luyện |
| Kiểm thử (test) | Chấm điểm cuối, trên dữ liệu mô hình chưa từng thấy | Chỉ dùng một lần khi chốt | Xem kết quả test rồi quay lại sửa mô hình |
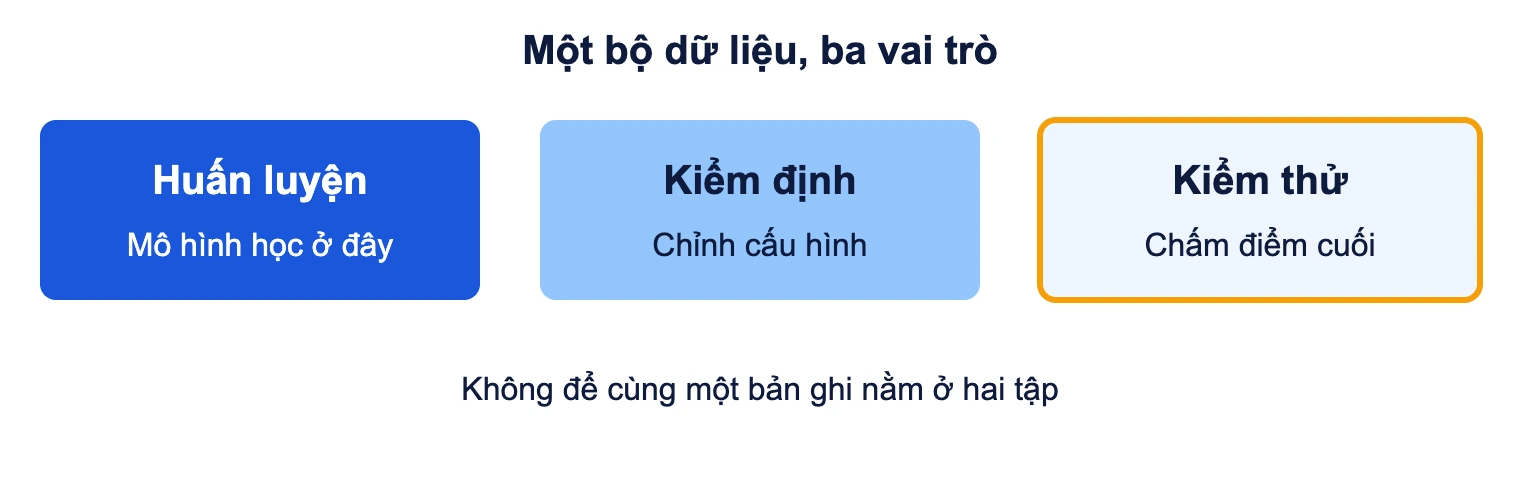
Có một lỗi tinh vi hơn việc chia sai tỷ lệ: rò rỉ dữ liệu (data leakage). Ví dụ minh hoạ: một khách hàng có 30 giao dịch, nếu chia ngẫu nhiên theo từng dòng thì 20 giao dịch nằm ở tập huấn luyện và 10 ở tập kiểm thử. Mô hình khi đó đang “nhận ra khách quen” chứ không học quy luật gian lận. Với dữ liệu theo thời gian, nên chia theo mốc ngày (huấn luyện trên quá khứ, thử trên giai đoạn sau) và với dữ liệu theo khách hàng, nên chia theo khách hàng thay vì theo dòng.
Dữ liệu huấn luyện gồm những loại nào?
Có hai cách phân loại hữu ích, tuỳ bạn đang hỏi về nhãn hay về dạng dữ liệu.
Theo cách có nhãn
- Có nhãn (học có giám sát): mỗi mẫu đi kèm đáp án, như email “spam / không spam” hay ảnh sản phẩm kèm “đạt / lỗi xước”.
- Không nhãn (học không giám sát): mô hình tự tìm cấu trúc, ví dụ gom nhóm khách hàng theo hành vi mua.
- Dữ liệu ưu tiên của con người: các cặp câu trả lời được người chấm điểm hoặc so sánh, dùng để tinh chỉnh mô hình ngôn ngữ cho phù hợp mong muốn. Cơ chế có người tham gia vòng lặp được trình bày ở bài về human-in-the-loop.
Theo dạng dữ liệu
- Bảng số liệu (giao dịch, lịch sử bảo trì máy, bảng chấm công).
- Văn bản (ticket hỗ trợ, hợp đồng, bình luận tiếng Việt).
- Hình ảnh và video (camera dây chuyền, ảnh hoá đơn).
- Âm thanh (ghi âm tổng đài, giọng vùng miền).
- Dữ liệu cảm biến chuỗi thời gian (nhiệt độ, rung động động cơ).
Ranh giới giữa dữ liệu có cấu trúc và phi cấu trúc ảnh hưởng đến chi phí chuẩn bị. Phần này đã có bài riêng: dữ liệu có cấu trúc và phi cấu trúc.
Dữ liệu huấn luyện đến từ đâu?
Nguồn quyết định rủi ro pháp lý, chi phí và độ lệch. Ma trận dưới đây giúp xếp nhanh nguồn dữ liệu của bạn.
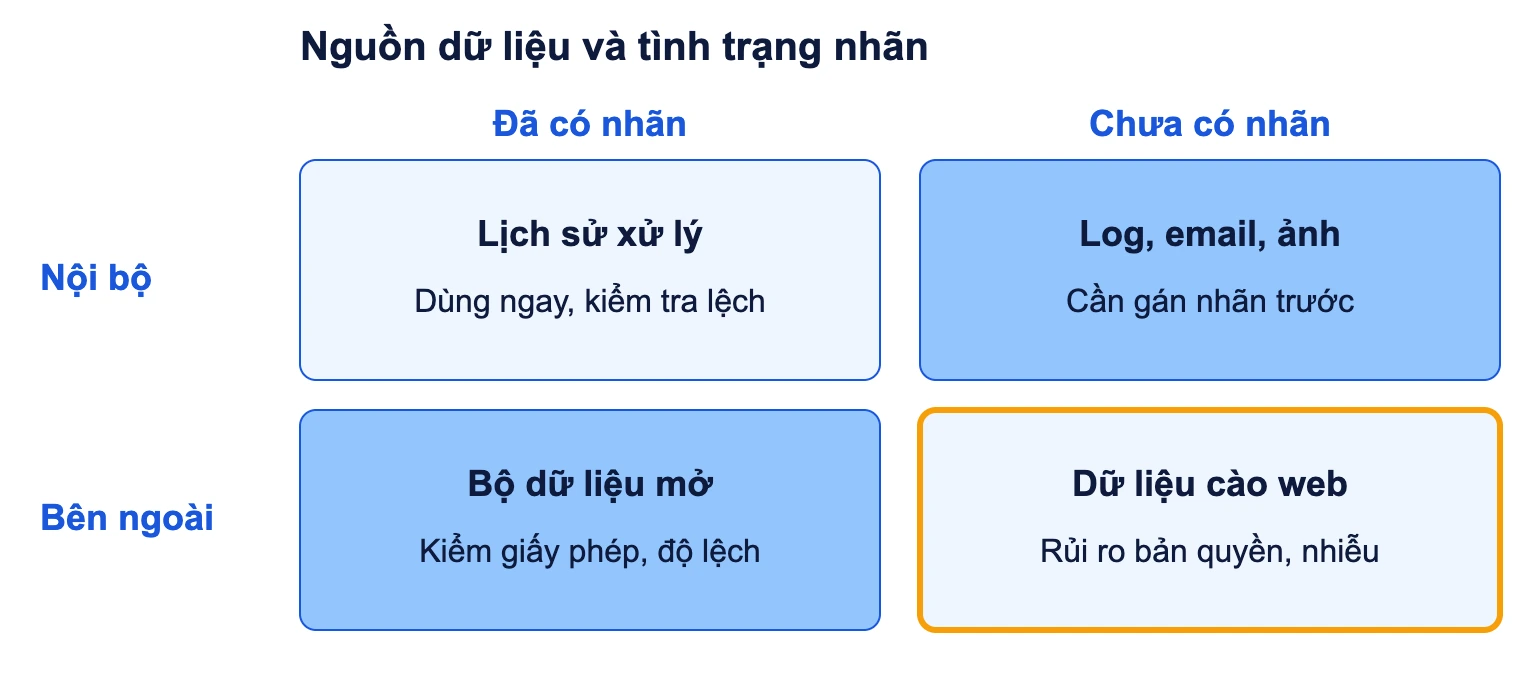
Với doanh nghiệp Việt, nguồn nội bộ thường giá trị nhất vì sát nghiệp vụ: lịch sử xử lý đơn, hồ sơ tín dụng đã quyết định, phiếu bảo hành, bản ghi cuộc gọi. Điểm yếu là dữ liệu nội bộ phản ánh cả thói quen và sai sót của quá trình cũ. Nếu nhân viên trước đây từ chối hồ sơ theo cảm tính, mô hình sẽ học đúng cảm tính đó.
Dữ liệu cào từ web hoặc mạng xã hội cần cân nhắc về quyền sở hữu, điều khoản sử dụng của trang nguồn và dữ liệu cá nhân lẫn trong nội dung. Nếu bộ dữ liệu có họ tên, số điện thoại, giấy tờ tuỳ thân, bạn cần xác định trường nào thực sự cần cho mô hình và loại hoặc che các trường còn lại trước khi đưa vào huấn luyện. Cách nhận diện nhóm trường này xem ở bài dữ liệu định danh.
Điều gì làm một bộ dữ liệu huấn luyện tốt?
Bốn tiêu chí thường được nhắc là chất lượng, số lượng, độ đa dạng và nhãn đúng, nhất quán. Trong thực tế triển khai, các lỗi cụ thể sau gây hại nhiều hơn việc “thiếu dữ liệu”:
- Nhãn nhiễu: cùng một câu phản hồi nhưng người này gán “khiếu nại”, người kia gán “góp ý”. Khi các người gán nhãn bất đồng, mô hình học sự bất đồng đó. Cách đo mức đồng thuận và quy trình xử lý nằm ở bài quy trình gán nhãn dữ liệu.
- Mất cân bằng lớp: trong phát hiện gian lận, giao dịch gian lận rất ít so với hợp lệ. Một mô hình đoán “hợp lệ” cho tất cả vẫn đạt độ chính xác tổng thể cao nhưng vô dụng. Cần xem thêm precision và recall của lớp hiếm, và cân nhắc lấy mẫu lại hoặc đặt trọng số.
- Lệch phân bố giữa quá khứ và hiện tại: mô hình huấn luyện trước đợt khuyến mãi lớn gặp hành vi mua khác hẳn sau đó. Dữ liệu cần phủ đủ mùa vụ và các tình huống hiếm.
- Trùng lặp: cùng một bản ghi xuất hiện nhiều lần, có thể nằm cả ở tập huấn luyện lẫn kiểm thử, làm kết quả thử đẹp giả.
- Thiếu tiếng Việt thật: với xử lý văn bản, dữ liệu viết không dấu, viết tắt, tiếng lóng, pha tiếng Anh là thứ mô hình đa ngôn ngữ thường xử lý kém nếu không có ví dụ riêng.
Câu “rác vào, rác ra” mô tả đúng hiện tượng này; phần phân tích từ góc độ gán nhãn nằm ở bài garbage in garbage out, còn việc đo và theo dõi chất lượng nói chung ở bài chất lượng dữ liệu.
Ví dụ minh hoạ về rò rỉ: mô hình dự báo khách rời bỏ dịch vụ có thêm cột “ngày đóng tài khoản”. Cột này chỉ có sau khi khách đã rời đi, nên mô hình đạt điểm gần tuyệt đối khi thử nhưng vô dụng khi cần dự báo trước. Khi điểm số cao bất thường, hãy kiểm tra từng cột đầu vào xem nó có tồn tại tại thời điểm cần dự đoán hay không.
Bao nhiêu dữ liệu là đủ?
Không có con số chung. Lượng dữ liệu cần thiết phụ thuộc độ phức tạp của bài toán, độ nhiễu và việc bạn huấn luyện từ đầu hay tinh chỉnh một mô hình có sẵn. Bài toán phân loại bảng số liệu đơn giản có thể chạy được với vài nghìn dòng; nhận dạng ảnh hay mô hình ngôn ngữ từ đầu cần lượng lớn hơn nhiều bậc. Nguồn tin nên tránh là những con số “tối thiểu 10.000 mẫu” áp cho mọi trường hợp.
Cách thực dụng để biết mình đã đủ chưa là vẽ đường cong học (learning curve): huấn luyện trên 10%, 25%, 50%, 100% dữ liệu hiện có rồi xem điểm trên tập kiểm định. Nếu điểm vẫn tăng đều khi thêm dữ liệu, bạn còn thiếu. Nếu điểm đã phẳng, thêm dữ liệu cùng loại không giúp mấy, vấn đề nằm ở nhãn, ở đặc trưng hoặc ở chọn mô hình.
Khi dữ liệu ít, có hai hướng bổ sung: biến đổi mẫu sẵn có (xem bài data augmentation) hoặc sinh mẫu mới bằng mô hình (xem bài dữ liệu tổng hợp).
Dữ liệu tổng hợp có thay được dữ liệu thật không?
Không nên thay hoàn toàn. Nghiên cứu về “sụp đổ mô hình” (model collapse) cho thấy khi mô hình bị huấn luyện lặp đi lặp lại trên dữ liệu do chính các thế hệ mô hình trước sinh ra, đầu ra mất dần sự đa dạng. Một công bố tại ICLR 2025 chỉ ra rằng ngay cả tỷ lệ dữ liệu tổng hợp rất nhỏ (cỡ 1 trên 1000) cũng khó tránh hoàn toàn hiện tượng này trong cấu hình nghiên cứu của họ.
Tuy vậy, kết luận không phải là “tránh dữ liệu tổng hợp”. Nhóm tác giả Gerstgrasser và cộng sự (2024) chứng minh rằng khi dữ liệu tổng hợp được tích luỹ thêm vào cạnh dữ liệu thật thì sai số kiểm thử có giới hạn trên hữu hạn, còn khi nó thay thế dữ liệu thật thì sai số tăng không giới hạn. Với doanh nghiệp, ý nghĩa thực tế là: giữ nguyên lõi dữ liệu thật đã kiểm chứng, dùng mẫu tổng hợp để bù các tình huống hiếm, và luôn chấm điểm trên tập kiểm thử gồm dữ liệu thật.
Ứng dụng cho doanh nghiệp Việt: ba tình huống
Ngân hàng, tài chính tiêu dùng: phát hiện giao dịch bất thường
Dữ liệu huấn luyện là lịch sử giao dịch với số tiền, thời điểm, địa điểm và nhãn hợp lệ hay gian lận do bộ phận điều tra xác nhận. Khó khăn nằm ở lớp gian lận rất hiếm và nhãn đến chậm (khách khiếu nại sau vài tuần). Khi chia tập, nên chia theo thời gian để tránh dùng tương lai dự đoán quá khứ.
Sản xuất: kiểm tra lỗi bề mặt bằng camera
Mỗi ảnh sản phẩm cần nhãn “đạt” hoặc loại lỗi cụ thể (xước, móp, lem sơn), có thể kèm khung bao quanh chỗ lỗi. Ảnh lỗi thật thường ít, nên cần chủ động chụp thêm ở nhiều điều kiện ánh sáng. Các kiểu nhãn khác nhau được nêu ở bài các loại gán nhãn hình ảnh.
Chăm sóc khách hàng: phân loại ticket và ghi âm cuộc gọi
Văn bản và ghi âm tiếng Việt cần nhãn chủ đề, mức độ khẩn, cảm xúc, và bản chép lời cho âm thanh. Giọng vùng miền và tạp âm tổng đài ảnh hưởng mạnh đến chất lượng, nên mẫu huấn luyện phải lấy từ chính kênh bạn đang vận hành. Chi tiết ở bài gán nhãn văn bản và âm thanh.
Trong cả ba tình huống, bài về data annotation là nơi giải thích vai trò của người gán nhãn.
Ưu điểm và hạn chế của cách học từ dữ liệu huấn luyện
| Ưu điểm | Hạn chế |
|---|---|
| Nắm được quy luật phức tạp mà khó viết thành quy tắc if-else | Chỉ giỏi trong vùng dữ liệu đã thấy; ngoài vùng đó dự đoán dễ sai |
| Cải thiện khi có thêm dữ liệu tốt | Chi phí gán nhãn và làm sạch thường lớn hơn chi phí chạy mô hình |
| Tái sử dụng được tài sản dữ liệu sẵn có của doanh nghiệp | Thừa hưởng định kiến và sai sót trong dữ liệu quá khứ |
| Có thể đánh giá khách quan bằng tập kiểm thử | Phải huấn luyện lại khi hành vi thị trường thay đổi |
Khi nào nên và không nên tự xây bộ dữ liệu huấn luyện?
Nên khi bài toán đặc thù (từ vựng ngành, mẫu mã sản phẩm, quy trình riêng) mà mô hình dùng chung xử lý kém, và bạn có sẵn lịch sử kèm kết quả đã xác nhận. Khi đó dữ liệu của bạn là lợi thế mà đối thủ khó sao chép.
Không nên khi một dịch vụ AI có sẵn đã đạt yêu cầu trên mẫu thật của bạn, hoặc khi dữ liệu chưa có kết quả đúng để làm nhãn (ví dụ chưa ai ghi lại hồ sơ nào thực sự xấu). Cũng không nên khi nhóm chưa thống nhất định nghĩa của nhãn, vì khi đó bạn đang tạo ra dữ liệu mâu thuẫn. Nếu mục tiêu chỉ là hỏi đáp trên tài liệu nội bộ, cơ chế tra cứu thường phù hợp hơn việc huấn luyện lại mô hình.
Câu hỏi thường gặp
Dữ liệu huấn luyện AI là gì, nói ngắn gọn?
Là tập ví dụ mà mô hình dùng để học. Với học có giám sát, mỗi ví dụ gồm đầu vào và đáp án đúng; mô hình chỉnh tham số để dự đoán gần đáp án nhất có thể.
Training data khác test data ở điểm nào?
Training data dùng để mô hình học, còn test data dùng để đánh giá độc lập trên mẫu mô hình chưa từng thấy. Nếu hai tập lẫn nhau, điểm đánh giá sẽ cao hơn thực tế.
Dữ liệu huấn luyện có bắt buộc phải gán nhãn không?
Không bắt buộc. Học có giám sát cần nhãn, còn học không giám sát (gom nhóm, phát hiện bất thường) thì không. Mô hình ngôn ngữ lớn cũng được tiền huấn luyện trên văn bản chưa gán nhãn thủ công, rồi mới tinh chỉnh bằng dữ liệu có nhãn hoặc dữ liệu đánh giá của con người.
Dùng dữ liệu khách hàng để huấn luyện mô hình có được không?
Về nguyên tắc có thể, nhưng bạn cần xác định mục đích xử lý, căn cứ hợp pháp và chỉ giữ những trường thật sự cần cho mô hình. Các trường định danh như họ tên, số điện thoại, số giấy tờ thường nên bị loại hoặc che trước khi đưa vào tập huấn luyện. Với trường hợp cụ thể, bạn nên hỏi tư vấn pháp lý.
Có thể dùng toàn bộ dữ liệu tổng hợp để huấn luyện không?
Không nên. Các nghiên cứu về sụp đổ mô hình cho thấy thay dữ liệu thật bằng dữ liệu do mô hình sinh ra làm giảm chất lượng qua các vòng huấn luyện. Cách an toàn hơn là giữ dữ liệu thật và bổ sung dữ liệu tổng hợp, đồng thời đánh giá bằng tập kiểm thử thật.
Làm sao biết bộ dữ liệu của tôi có vấn đề?
Các dấu hiệu thường gặp: điểm trên tập huấn luyện cao hơn hẳn tập kiểm định, điểm kiểm thử gần như tuyệt đối, người gán nhãn bất đồng nhiều trên cùng một mẫu, hoặc một lớp chiếm áp đảo. Kiểm tra trùng lặp, cột rò rỉ và phân bố nhãn trước khi chỉnh mô hình.
Đọc thêm tin tức, phân tích về AI, blockchain và chuyển đổi số trên blog công nghệ VBPO, hoặc các bài khác trong chuyên mục Dữ liệu & phân tích.