
Trả lời nhanh: GPU cho AI là bộ xử lý đồ họa được dùng để tăng tốc các phép nhân ma trận trong huấn luyện và chạy mô hình AI. Nó có hàng nghìn lõi làm việc song song, bộ nhớ VRAM tốc độ cao và lõi chuyên cho ma trận (Tensor Core). Khi chọn GPU, dung lượng VRAM và băng thông thường quan trọng hơn số nhân.
Điểm chính
- AI hiện đại chủ yếu là phép nhân ma trận lặp hàng tỷ lần, đúng loại việc GPU làm tốt hơn CPU.
- VRAM quyết định mô hình có nạp vừa hay không; băng thông bộ nhớ quyết định tốc độ sinh chữ khi suy luận.
- Huấn luyện cần nhiều bộ nhớ và kết nối nhiều GPU hơn hẳn suy luận.
- Phần lớn doanh nghiệp Việt chỉ cần suy luận hoặc tinh chỉnh nhỏ, nên thuê GPU đám mây trước khi mua.
Mục lục
- GPU cho AI là gì?
- Vì sao AI cần GPU mà không chỉ dùng CPU?
- GPU cho AI gồm những thành phần nào?
- Thông số nào quan trọng nhất khi nhìn bảng so sánh?
- Cần bao nhiêu VRAM để chạy một mô hình?
- Huấn luyện và suy luận cần GPU khác nhau thế nào?
- Doanh nghiệp Việt dùng GPU cho AI vào việc gì?
- GPU, CPU, NPU và TPU khác nhau ở đâu?
- GPU cho AI có ưu và nhược điểm gì?
- Nên mua GPU, thuê đám mây hay chạy tại chỗ?
- Khi nào nên và không nên đầu tư GPU?
- Câu hỏi thường gặp
GPU cho AI là gì?
GPU (Graphics Processing Unit) ban đầu sinh ra để vẽ hình ảnh. Theo AWS, GPU là mạch điện tử thực hiện phép toán tốc độ cao, cho phép áp dụng cùng một phép tính lên nhiều giá trị dữ liệu song song. Nhà phát triển nhận ra rằng huấn luyện mạng nơ-ron cũng cần đúng kiểu tính toán đó, nên GPU trở thành phần cứng nền của AI.
“GPU cho AI” vì vậy không phải một loại chip riêng, mà là cách gọi GPU khi dùng cho tính toán AI. Có hai nhóm. Nhóm thứ nhất là card đồ họa tiêu dùng hoặc workstation, thường gặp trên máy trạm. Nhóm thứ hai là GPU trung tâm dữ liệu như NVIDIA A100, H100, thiết kế riêng cho AI và tính toán khoa học, đặt trong máy chủ. Nếu cần hiểu nền tảng hơn, bạn có thể đọc về mạng nơ-ron nhân tạo, loại mô hình tạo ra khối lượng tính toán này.
Vì sao AI cần GPU mà không chỉ dùng CPU?
Một lớp của mạng nơ-ron về bản chất là phép nhân ma trận: ma trận đầu vào nhân với ma trận trọng số, cộng thêm hằng số, rồi qua hàm kích hoạt. Mỗi ô kết quả độc lập với các ô khác, nên có thể tính đồng thời. Mô hình có hàng tỷ trọng số thì mỗi lần dự đoán là hàng tỷ phép nhân cộng như vậy.
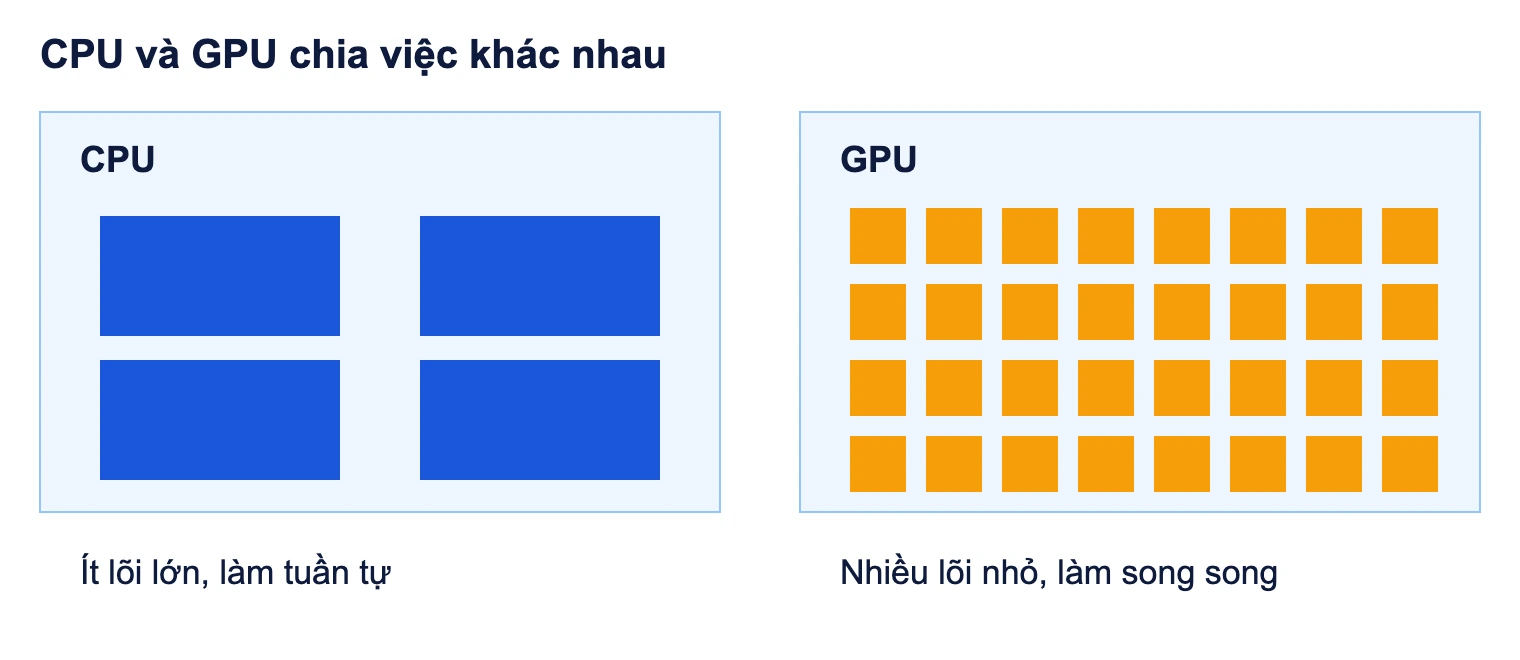
CPU có ít lõi nhưng mỗi lõi mạnh, giỏi xử lý logic rẽ nhánh và tác vụ tuần tự. GPU đảo ngược cách đánh đổi: Intel mô tả GPU gồm hàng trăm đến hàng chục nghìn lõi, mỗi lõi đơn giản hơn nhưng số lượng áp đảo. Với phép toán lặp đồng nhất, đông lõi nhỏ thắng ít lõi lớn.
GPU cho AI gồm những thành phần nào?
Khi đọc bảng thông số, bạn nên tách GPU thành năm phần, vì mỗi phần chặn hiệu năng ở một tình huống khác nhau.
- Lõi CUDA / stream processor: lõi tính toán đa dụng, xử lý số thực thông thường.
- Tensor Core (NVIDIA) hoặc Matrix Core (AMD): khối phần cứng chuyên nhân ma trận nhỏ trong một nhịp, hỗ trợ các định dạng số độ chính xác thấp như FP16, BF16, FP8. Đây là nơi tạo ra phần lớn tốc độ AI.
- VRAM: bộ nhớ gắn trên card, chứa trọng số mô hình, dữ liệu đang xử lý và bộ nhớ đệm trung gian. Hết VRAM thì mô hình không nạp được hoặc báo lỗi tràn bộ nhớ.
- Băng thông bộ nhớ: tốc độ đọc VRAM, tính bằng GB/s hoặc TB/s. GPU trung tâm dữ liệu dùng bộ nhớ HBM (High Bandwidth Memory) để đạt mức này.
- Kết nối giữa các GPU (NVLink, PCIe): quyết định việc chia một mô hình lớn ra nhiều card có chậm đi hay không.
Ngoài phần cứng còn có lớp phần mềm. CUDA là nền tảng lập trình của NVIDIA; ROCm là nền tảng mã nguồn mở của AMD. Các thư viện như PyTorch gọi xuống các nền tảng này, nên một card tốt nhưng thiếu hỗ trợ phần mềm vẫn có thể là lựa chọn kém.
Thông số nào quan trọng nhất khi nhìn bảng so sánh?
Ví dụ thực tế là so sánh A100 và H100 của NVIDIA ở bản SXM 80 GB. Dung lượng bộ nhớ như nhau, nhưng loại bộ nhớ khác. Theo các bảng thông số tổng hợp từ NVIDIA, H100 dùng HBM3 ở 3.350 GB/s, A100 dùng HBM2e ở 2.039 GB/s. Một phân tích nhận định chênh lệch băng thông này là động lực chính của mức tăng tốc suy luận trên các phép attention bị giới hạn bởi bộ nhớ.
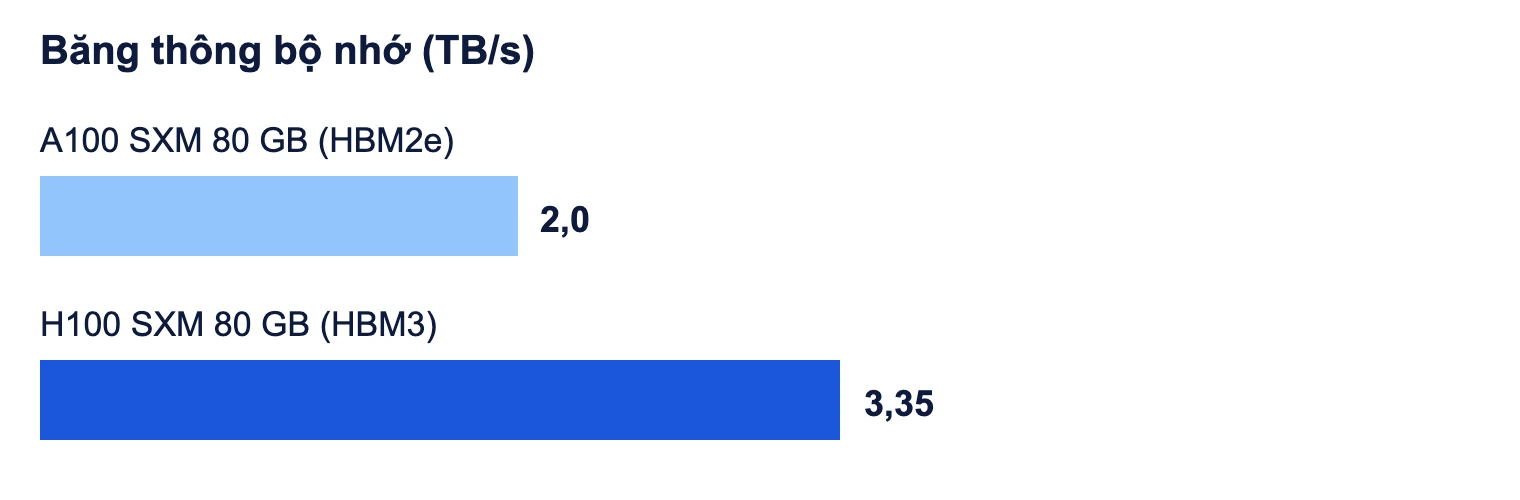
Bài học khi đọc bảng: cùng 80 GB VRAM vẫn có thể cho tốc độ khác nhau. Một bản H100 dạng PCIe còn dùng HBM2e thay vì HBM3, nên băng thông chỉ khoảng 2.000 GB/s thay vì 3.350 GB/s. Vì thế không nên chỉ so tên dòng chip, hãy so đúng biến thể.
| Thông số | Ảnh hưởng đến | Dấu hiệu khi thiếu |
|---|---|---|
| Dung lượng VRAM | Cỡ mô hình, độ dài ngữ cảnh, batch size | Lỗi hết bộ nhớ, phải giảm batch |
| Băng thông bộ nhớ | Tốc độ sinh từng token khi suy luận | GPU chờ đọc bộ nhớ, tải tính toán thấp |
| Tensor Core và định dạng số | Tốc độ huấn luyện, hỗ trợ FP8, BF16 | Huấn luyện chậm dù VRAM đủ |
| Kết nối NVLink | Huấn luyện hoặc phục vụ mô hình chia nhiều GPU | Thêm card nhưng tốc độ không tăng tương ứng |
| Hỗ trợ phần mềm | Chạy được thư viện bạn đang dùng | Phải tự biên dịch, lỗi tương thích |
Cần bao nhiêu VRAM để chạy một mô hình?
Đây là câu hỏi người mua GPU gặp đầu tiên. Quy tắc ước lượng nhanh: dung lượng trọng số bằng số tham số của mô hình nhân số byte mỗi tham số. FP16 hoặc BF16 dùng 2 byte; lượng tử hoá 4 bit dùng khoảng 0,5 byte.
Ví dụ minh hoạ (phép tính ước lượng, chưa tính chi phí phụ):
- Mô hình 7 tỷ tham số ở FP16: khoảng 14 GB chỉ cho trọng số. Lượng tử hoá 4 bit còn khoảng 3,5 GB.
- Mô hình 70 tỷ tham số ở FP16: khoảng 140 GB, vượt một card 80 GB, nên phải chia ít nhất hai GPU hoặc lượng tử hoá mạnh.
Con số thật luôn cao hơn, vì còn bộ nhớ đệm khoá-giá trị (KV cache) tăng theo độ dài hội thoại và số người dùng đồng thời, cộng thêm bộ nhớ cho framework. Khi huấn luyện, VRAM cần nhiều hơn rất nhiều vì phải giữ thêm gradient và trạng thái bộ tối ưu; quy tắc thường dùng cho huấn luyện độ chính xác hỗn hợp với Adam là cỡ mười mấy byte mỗi tham số, chưa kể activation. Hãy coi đó là mức ước lượng thô và thử trên máy thật trước khi quyết định.
Phép ước lượng trên là quy tắc ngón tay cái, không phải thông số nhà sản xuất. Kết quả thực tế phụ thuộc framework, độ dài ngữ cảnh và số người dùng đồng thời.
Huấn luyện và suy luận cần GPU khác nhau thế nào?
Hai giai đoạn này đòi hỏi phần cứng khác hẳn, và nhầm lẫn ở đây là lý do nhiều doanh nghiệp mua dư cấu hình.
- Huấn luyện (training): tính gradient và cập nhật trọng số, cần nhiều VRAM, tính toán dày và thường chạy nhiều GPU cùng lúc. Intel lưu ý một mạng nơ-ron lớn có thể mất nhiều ngày hoặc nhiều tuần trên CPU, nên GPU là phần cứng gần như mặc định.
- Suy luận (inference): chỉ chạy mô hình đã có để trả lời. Với mô hình ngôn ngữ, bước sinh chữ thường bị giới hạn bởi băng thông bộ nhớ hơn là số phép tính, như phân tích ở trên đã nêu. Chi tiết nằm ở bài về AI inference.
Với phần lớn doanh nghiệp, nhu cầu thực tế là suy luận hoặc tinh chỉnh một mô hình có sẵn bằng kỹ thuật tiết kiệm bộ nhớ. Tự huấn luyện mô hình nền từ đầu là việc của nhóm có ngân sách cụm GPU lớn.
Doanh nghiệp Việt dùng GPU cho AI vào việc gì?
Các tình huống phổ biến, kèm loại tải GPU tương ứng:
- Chatbot và trợ lý nội bộ chạy mô hình mở tại chỗ: tải suy luận, ưu tiên VRAM đủ nạp mô hình và băng thông tốt. Dữ liệu không rời hệ thống là lý do chính để chọn tại chỗ.
- Camera phân tích hình ảnh tại nhà máy, kho, cửa hàng: tải suy luận video liên tục. Có thể chạy tại biên bằng thiết bị nhỏ, xem thêm edge AI.
- Huấn luyện lại mô hình nhận dạng cho dữ liệu riêng (chứng từ, ảnh sản phẩm lỗi): tải huấn luyện ngắn, theo đợt, hợp với thuê GPU theo giờ.
- Tạo vector cho tìm kiếm tài liệu nội bộ: tải nhẹ hơn nhiều, nhiều trường hợp một card tầm trung là đủ.
Bạn cũng nên biết GPU không phải lựa chọn duy nhất cho suy luận nhỏ. Máy tính văn phòng đời mới có NPU đảm nhận các tác vụ AI nhẹ, tiết kiệm điện hơn GPU rời.
GPU, CPU, NPU và TPU khác nhau ở đâu?
| Bộ xử lý | Thế mạnh | Hạn chế | Hợp với |
|---|---|---|---|
| CPU | Linh hoạt, logic phức tạp, tiền xử lý dữ liệu | Chậm với ma trận cỡ lớn | Mô hình nhỏ, điều phối hệ thống |
| GPU | Song song, hệ sinh thái phần mềm rộng | Giá và điện năng cao, VRAM giới hạn | Huấn luyện và suy luận cỡ vừa đến lớn |
| NPU | Tiết kiệm điện cho suy luận nhẹ | Ít linh hoạt, phụ thuộc phần mềm nhà sản xuất | Laptop, thiết bị biên |
| TPU | Chip ASIC của Google tối ưu cho tensor | Chủ yếu dùng qua dịch vụ đám mây của Google | Khối lượng lớn trên hạ tầng Google |
Trong máy chủ AI, CPU vẫn cần thiết: nó nạp dữ liệu, tiền xử lý và điều phối GPU. CPU yếu có thể khiến GPU “đói dữ liệu” và nằm chờ.
GPU cho AI có ưu và nhược điểm gì?
Ưu điểm
- Rút ngắn thời gian huấn luyện từ nhiều ngày xuống nhiều giờ ở các bài toán phù hợp.
- Hệ sinh thái phần mềm trưởng thành: các framework học sâu chính hỗ trợ GPU sẵn.
- Thuê theo giờ qua đám mây giúp tránh vốn đầu tư ban đầu.
Nhược điểm
- Chi phí mua và điện năng cao; GPU trung tâm dữ liệu cần làm mát và nguồn điện phù hợp phòng máy.
- VRAM là giới hạn cứng: không đủ thì phải lượng tử hoá, chia nhiều card hoặc đổi mô hình.
- Phụ thuộc nhà cung cấp phần mềm. Chuyển giữa CUDA và ROCm có thể phát sinh việc chỉnh sửa.
- Nguồn cung và chính sách xuất khẩu thay đổi. Ví dụ, Bộ Thương mại Mỹ ngày 31/5/2026 công bố quy định mới siết xuất khẩu các dòng chip AI tiên tiến như Blackwell. Khi mua dòng cao cấp, hãy hỏi nhà phân phối về điều kiện cấp phép và thời gian giao hàng.
Nên mua GPU, thuê đám mây hay chạy tại chỗ?
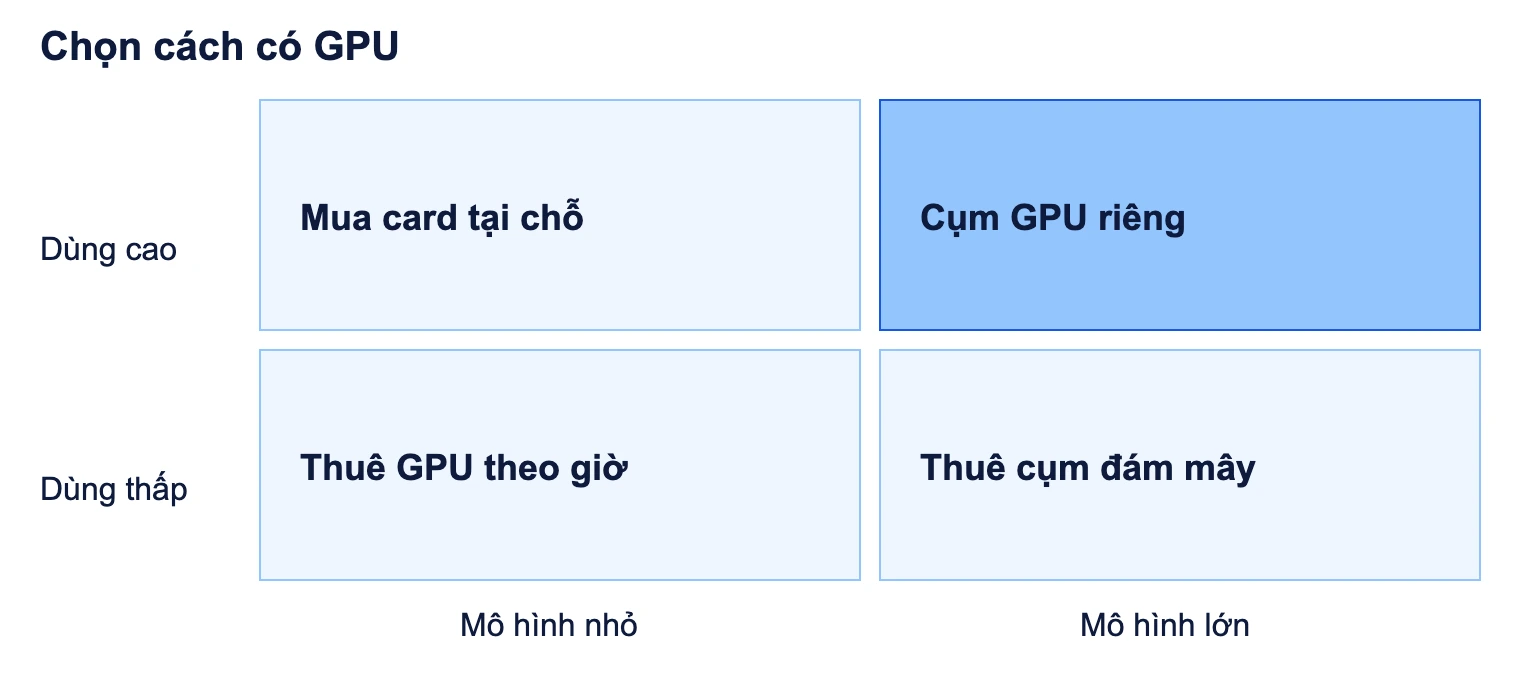
Hai trục giúp bạn khoanh vùng: cỡ mô hình và mức độ dùng thường xuyên. Đây là khung tham khảo, không phải kết luận cho mọi trường hợp.
Điểm cần cân nhắc thêm trước khi mua:
- Yêu cầu giữ dữ liệu trong nước hoặc trong hệ thống: nếu dữ liệu có thông tin cá nhân, Luật Trí tuệ nhân tạo có thể ảnh hưởng đến việc đưa dữ liệu lên đám mây, nên cần rà soát với bộ phận pháp chế.
- Phòng máy: card trung tâm dữ liệu cần nguồn, làm mát và khe PCIe phù hợp; card tiêu dùng cắm vào máy tính thường không đáp ứng sẵn.
- Khấu hao nhanh: mỗi thế hệ GPU ra đời, giá trị thế hệ trước giảm. Chạy thử trên máy thuê giúp bạn biết cấu hình thật sự cần.
Khi nào nên và không nên đầu tư GPU?
Nên cân nhắc khi: bạn đã có mô hình cụ thể cần chạy, đo được VRAM cần thiết trên máy thuê, và khối lượng truy vấn đủ ổn định để giá mua hoặc thuê dài hạn rẻ hơn trả theo giờ.
Chưa cần khi: dùng dịch vụ AI qua API là đủ; mô hình nhỏ chạy tốt trên CPU hoặc NPU; hoặc bạn chưa biết mô hình nào sẽ dùng. Trường hợp cuối thì mua card trước sẽ dễ sai cấu hình.
Nếu bạn mới làm quen, hãy đọc bài nền về deep learning để hiểu vì sao các mô hình này đòi tính toán lớn đến vậy.
Câu hỏi thường gặp
GPU cho AI khác card đồ họa chơi game ở điểm nào?
Về nguyên lý cả hai đều là GPU. Khác biệt nằm ở dung lượng và loại bộ nhớ (HBM so với GDDR), băng thông, độ chính xác số được hỗ trợ, kết nối nhiều card và độ bền chạy liên tục. Card chơi game vẫn chạy được nhiều mô hình nhỏ và vừa, nhất là sau khi lượng tử hoá.
Có chạy AI được mà không cần GPU không?
Có, với mô hình nhỏ hoặc đã lượng tử hoá, CPU hoặc NPU vẫn trả lời được, chỉ chậm hơn. Huấn luyện mô hình lớn trên CPU thì thường quá lâu để thực tế.
VRAM hay số nhân quan trọng hơn?
Thường là VRAM, vì quyết định mô hình có nạp vừa hay không. Sau khi đủ VRAM mới tính đến băng thông và Tensor Core. Một card ít nhân nhưng nhiều VRAM có thể chạy được mô hình mà card nhanh hơn nhưng ít VRAM thì không.
GPU AMD có dùng được cho AI không?
Có. AMD cung cấp lõi ma trận và nền tảng ROCm mã nguồn mở. Điểm cần kiểm tra là thư viện và mô hình bạn dùng có hỗ trợ ROCm ổn định hay chưa, vì hệ sinh thái CUDA của NVIDIA vẫn phổ biến hơn.
Một GPU phục vụ được bao nhiêu người dùng cùng lúc?
Không có con số chung. Số người dùng đồng thời phụ thuộc cỡ mô hình, độ dài ngữ cảnh, KV cache và yêu cầu độ trễ. Cách đáng tin là chạy thử tải thật trên máy thuê rồi đo thời gian phản hồi.
GPU có chạy được ở thiết bị biên như camera không?
Có, các module GPU nhỏ tiêu thụ điện thấp được thiết kế cho mục đích này. Thiết bị biên đặt nặng ràng buộc về điện năng, nhiệt và kích thước, nên mô hình thường phải được thu nhỏ trước khi triển khai.