
Trả lời nhanh: Semantic search (tìm kiếm ngữ nghĩa) là cách tìm thông tin theo ý nghĩa của câu hỏi, không chỉ theo từ gõ vào. Hệ thống đổi câu hỏi và tài liệu thành vector embedding, rồi lấy những đoạn có vector gần nhất. Nhờ vậy câu hỏi và tài liệu dùng từ khác nhau vẫn khớp.
Điểm chính
- Semantic search so khớp theo độ gần của vector, còn tìm kiếm từ khoá so khớp theo chuỗi ký tự.
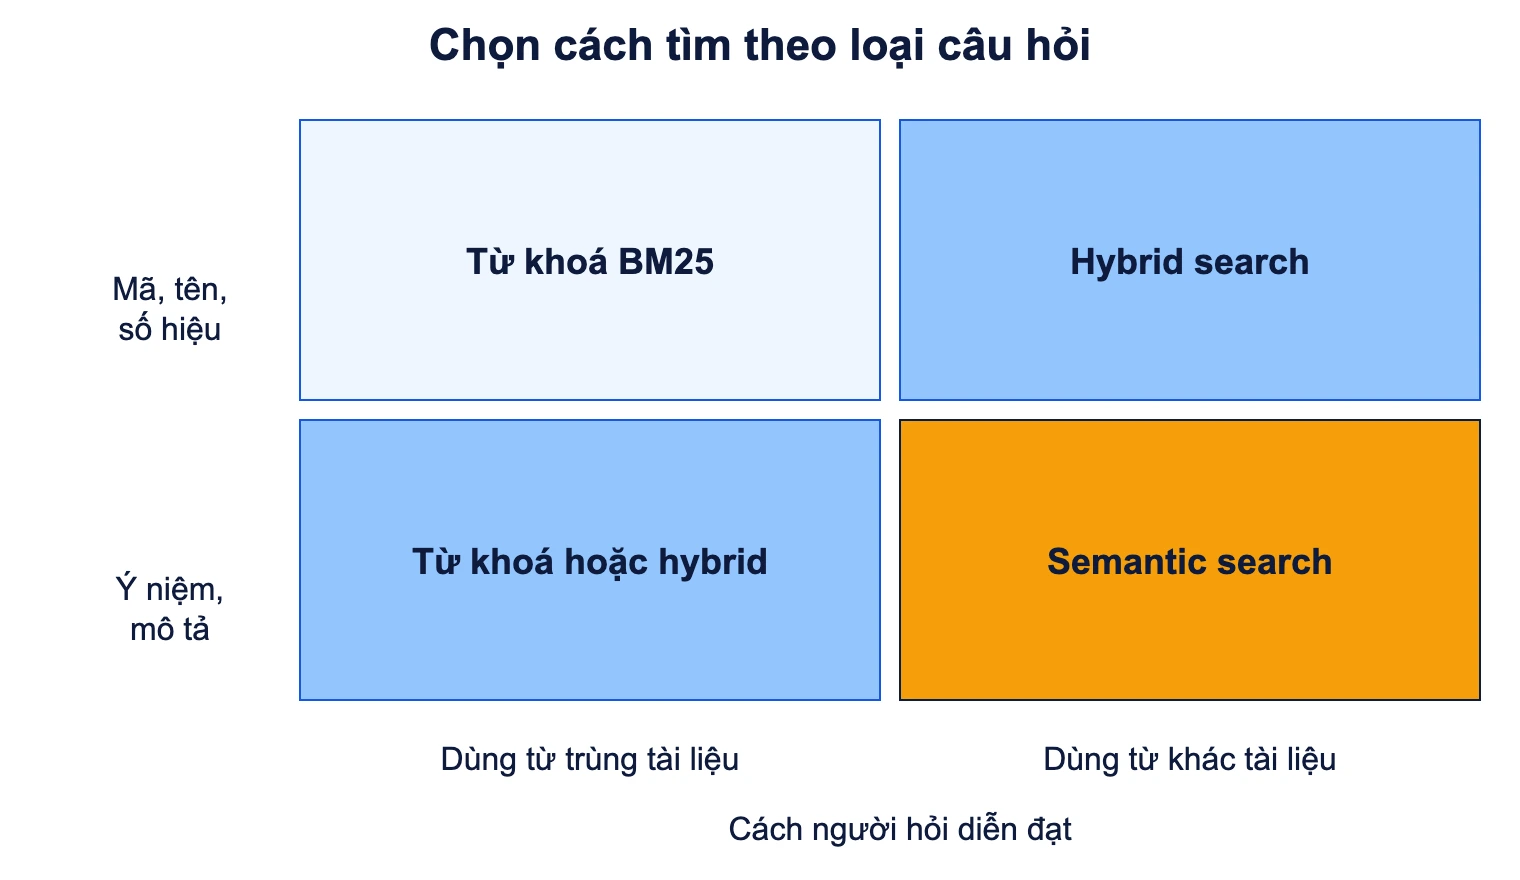
- Nó yếu ở mã sản phẩm, tên riêng, số hiệu. Vì vậy hệ thống thực tế thường dùng hybrid search: BM25 cộng vector.
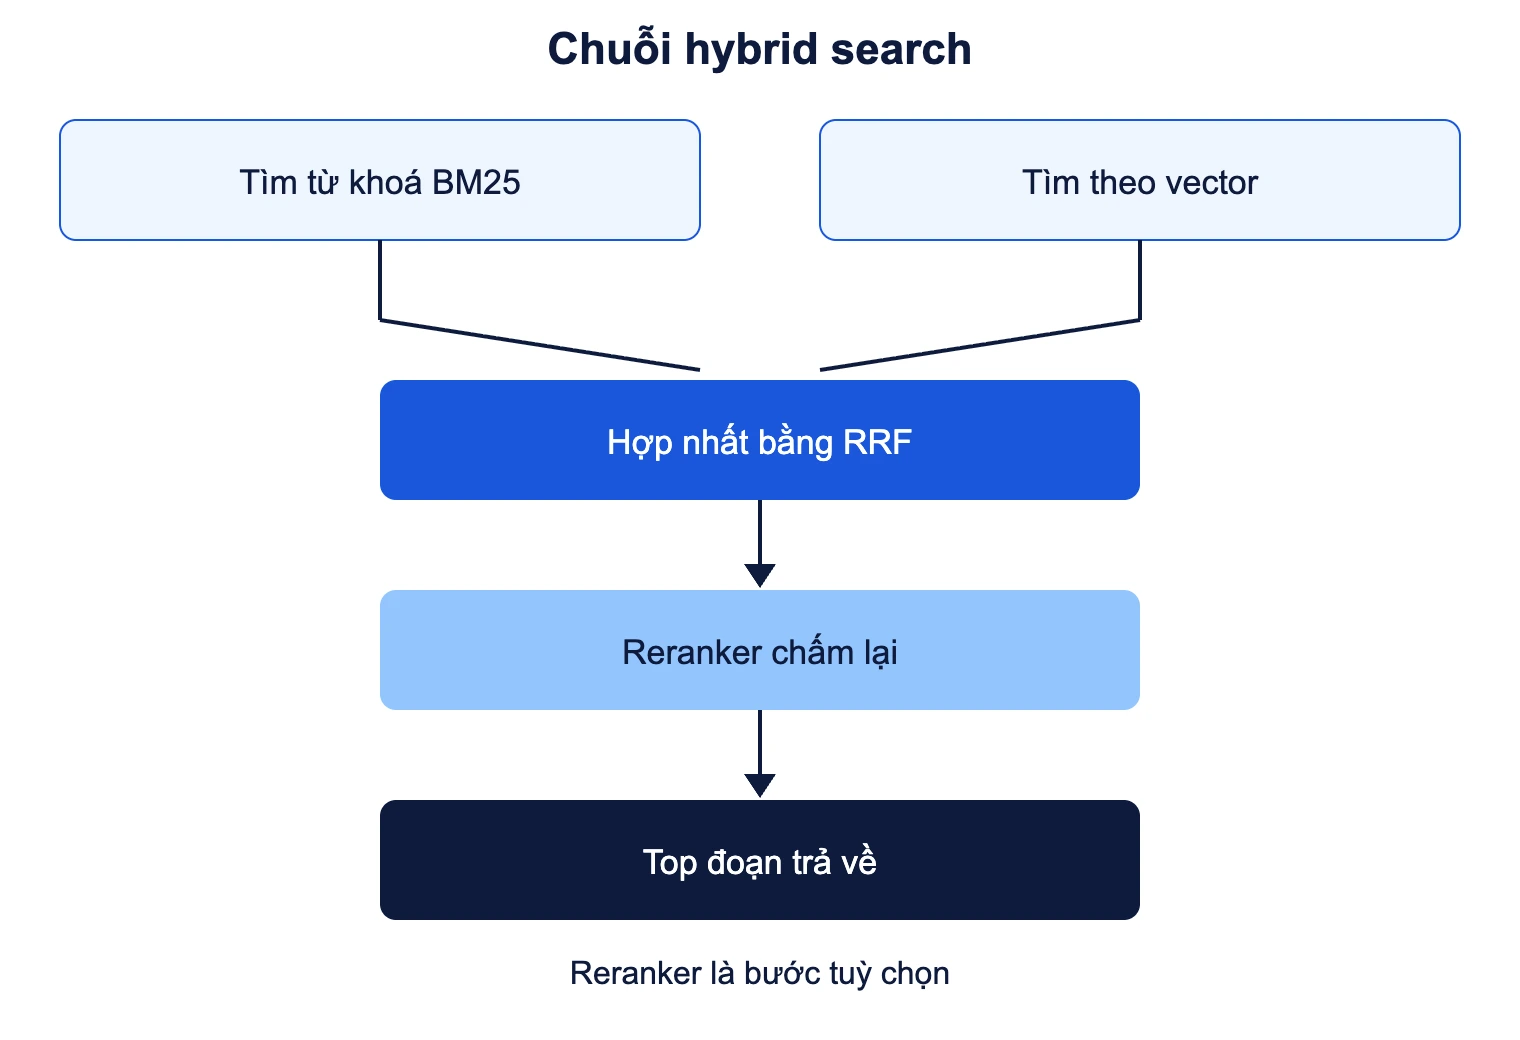
- Hai danh sách kết quả thường được hợp nhất bằng Reciprocal Rank Fusion (RRF), sau đó có thể chấm lại bằng reranker.
- Chất lượng phải đo trên bộ câu hỏi thật của doanh nghiệp. Với tiếng Việt, điều này càng cần thiết.
- Semantic search là tầng truy xuất của nhiều hệ thống RAG và trợ lý nội bộ.
Mục lục
- Semantic search là gì?
- Semantic search hoạt động thế nào?
- Ví dụ tiếng Việt: vì sao từ khoá hụt mà ngữ nghĩa trúng?
- Các loại và thành phần của hệ thống semantic search
- Hybrid search và RRF: kết hợp từ khoá với ngữ nghĩa
- Ứng dụng của semantic search cho doanh nghiệp Việt Nam
- Ưu điểm và hạn chế
- Semantic search khác gì các khái niệm gần?
- Khi nào nên và không nên dùng semantic search?
- Làm sao biết semantic search của bạn tìm đúng?
- Dữ liệu nhạy cảm và phân quyền khi lập chỉ mục
- Câu hỏi thường gặp
Semantic search là gì?
Semantic search là phương pháp truy xuất thông tin dựa trên nghĩa. Tìm kiếm truyền thống (lexical search) khớp chuỗi ký tự. Semantic search chuyển truy vấn thành vector biểu diễn ý nghĩa rồi so với nội dung có ý nghĩa tương đồng.
Bài này nói về semantic search trong hệ thống dữ liệu và AI: kho tài liệu nội bộ, website bán hàng, chatbot. Cùng cụm từ này, giới SEO còn dùng để chỉ việc công cụ như Google hiểu thực thể và ý định tìm kiếm. Hai cách dùng có chung ý tưởng, nhưng bài này chỉ bàn phần kỹ thuật bạn tự xây hoặc mua cho hệ thống của mình.
Điểm cốt lõi là máy không “hiểu” theo nghĩa của con người. Nó dùng mô hình đã học từ lượng văn bản rất lớn để đặt các câu có nghĩa gần nhau vào những vị trí gần nhau trong một không gian số nhiều chiều. Tìm kiếm khi đó trở thành bài toán tìm điểm gần nhất.
Semantic search hoạt động thế nào?
Hệ thống chạy hai pha: chuẩn bị dữ liệu một lần (và cập nhật khi tài liệu đổi), rồi xử lý từng câu hỏi.
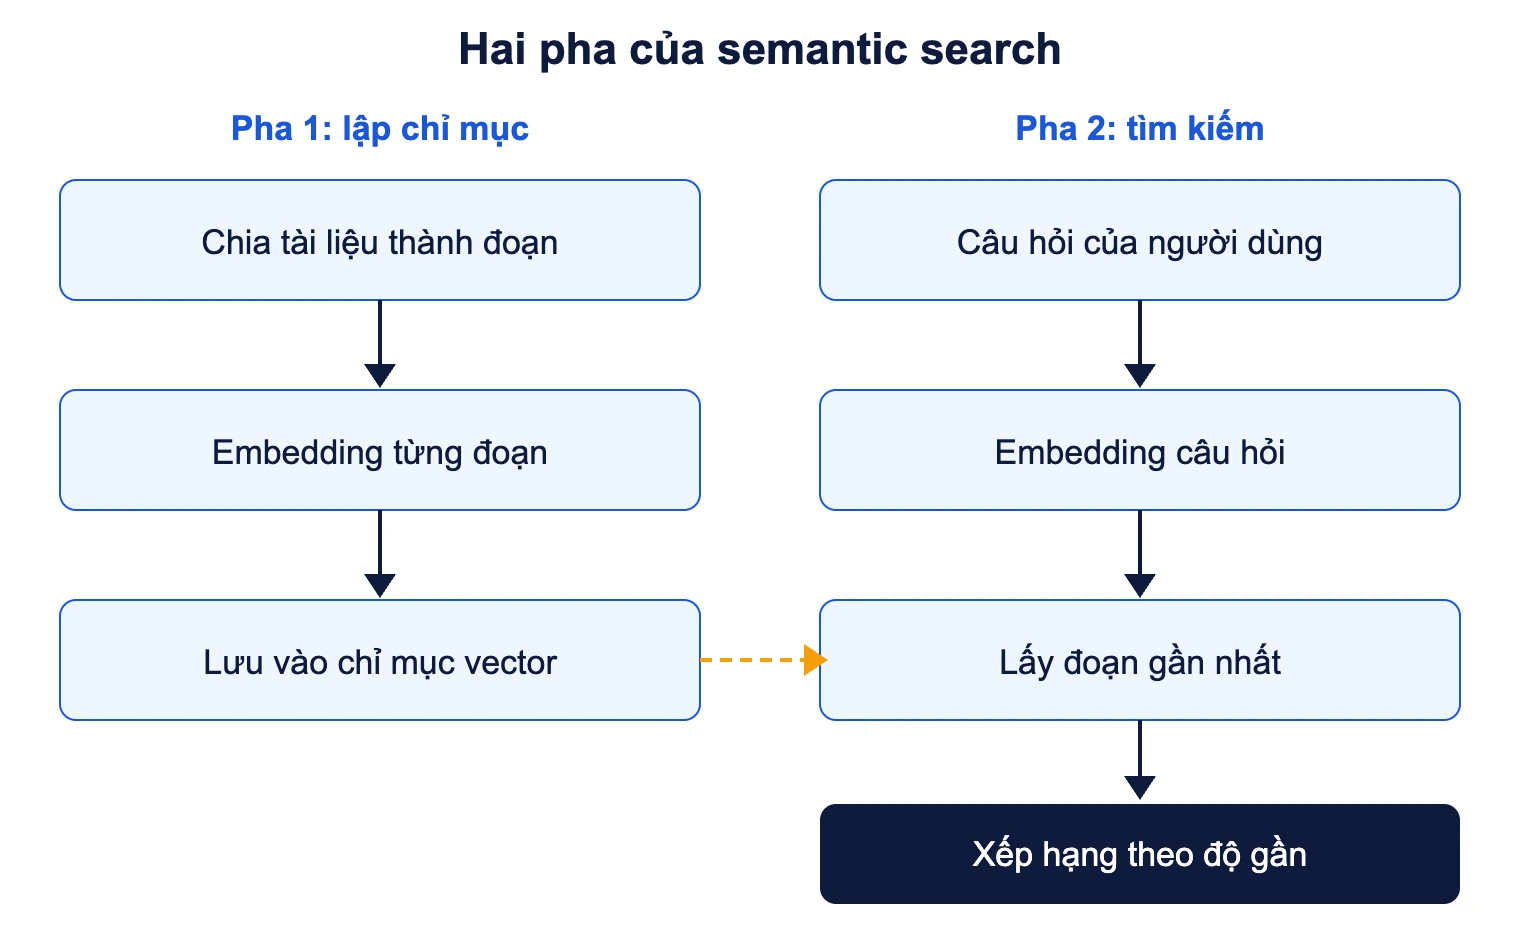
Bước 1: chia tài liệu thành đoạn (chunking)
Một hợp đồng 40 trang không nên thành một vector duy nhất, vì vector đó chỉ phản ánh nghĩa trung bình của cả văn bản. Hệ thống cắt thành các đoạn vài trăm chữ, thường theo mục, điều khoản hoặc đoạn văn. Cắt sai chỗ làm hỏng kết quả: nếu tiêu đề “Điều 12. Thanh toán” nằm ở đoạn này còn nội dung nằm ở đoạn kia, không đoạn nào tự mô tả đủ.
Bước 2: tạo embedding
Mỗi đoạn đi qua một mô hình embedding và cho ra một dãy số, thường vài trăm đến vài nghìn chiều. Cơ chế toán học và cách đo độ gần bằng cosine similarity có trong bài vector embedding và cosine similarity. Điều cần nhớ ở đây: câu hỏi và tài liệu phải đi qua cùng một mô hình, hoặc hai mô hình được huấn luyện để tương thích. Đổi mô hình giữa chừng thì phải tính lại toàn bộ vector.
Bước 3: lưu và truy vấn gần đúng
Vector được lưu trong chỉ mục chuyên dụng. Với vài chục nghìn đoạn, so khớp vét cạn vẫn nhanh. Với hàng triệu đoạn, hệ thống dùng thuật toán láng giềng gần đúng (ANN), đánh đổi một chút độ chính xác lấy tốc độ. Phần này được trình bày trong bài vector database, HNSW và IVF.
Ví dụ tiếng Việt: vì sao từ khoá hụt mà ngữ nghĩa trúng?
Ví dụ minh hoạ, không phải dữ liệu của một doanh nghiệp cụ thể.
Giả sử kho quy chế nhân sự có đoạn: “Người lao động được thoả thuận với người sử dụng lao động về việc tạm ngừng công việc mà không hưởng lương trong thời gian không quá 30 ngày.” Nhân viên gõ: “xin nghỉ không lương một tháng được không”.
- Tìm kiếm từ khoá: câu hỏi có “xin nghỉ”, “một tháng”. Đoạn trên có “tạm ngừng công việc”, “30 ngày”. Gần như không có từ chung, nên đoạn đúng bị xếp thấp hoặc không xuất hiện.
- Semantic search: “nghỉ không lương” và “tạm ngừng công việc không hưởng lương” có vector gần nhau, nên đoạn này lên đầu.
Ngược lại, nếu nhân viên gõ “mẫu BM-07”, từ khoá làm tốt còn vector có thể trả về các biểu mẫu khác trông giống nhau. Chỉ riêng cặp ví dụ này đã cho thấy lý do hệ thống thực tế hay kết hợp cả hai hướng.
Những điểm riêng của tiếng Việt
- Chính tả và dấu: “hoá đơn” và “hóa đơn”, hoặc câu không dấu như “hop dong lao dong”, là các chuỗi khác nhau với tìm kiếm từ khoá. Mô hình embedding đa ngữ thường xử lý được, nhưng chất lượng với văn bản không dấu khác nhau giữa các mô hình. Hãy thử trực tiếp.
- Từ ghép: tiếng Việt viết cách nhau bằng khoảng trắng, nên phần từ khoá cần bộ tách từ phù hợp. Nếu không, “hợp đồng” bị coi là hai từ rời.
- Thuật ngữ nội bộ và viết tắt: “PO”, “BHXH”, tên dự án, tên phòng ban thường không có trong dữ liệu huấn luyện công khai. Với những từ này, phần từ khoá của hybrid search thường đỡ cho vector.
Các loại và thành phần của hệ thống semantic search
| Thành phần | Vai trò | Lưu ý khi chọn |
|---|---|---|
| Dense retrieval (bi-encoder) | Câu hỏi và đoạn văn được mã hoá riêng thành vector dày, rồi so độ gần | Nhanh vì vector đoạn văn tính sẵn. Hay bỏ sót mã, tên riêng, số |
| Sparse retrieval (BM25, SPLADE) | Chấm điểm theo từ xuất hiện, trọng số theo độ hiếm của từ. SPLADE là biến thể học máy | Mạnh với từ hiếm, định danh. Không tự nhận ra đồng nghĩa (BM25) |
| Hybrid search | Chạy cả hai rồi hợp nhất danh sách | Cần chọn cách hợp nhất, thường là RRF |
| Reranker (cross-encoder) | Đọc cặp câu hỏi và đoạn văn cùng lúc để chấm lại danh sách ngắn | Chính xác hơn nhưng chậm hơn, chỉ dùng cho vài chục ứng viên |
| Bộ lọc metadata | Giới hạn theo phòng ban, năm, loại tài liệu, quyền truy cập | Nên chạy cùng lúc với truy vấn, không lọc sau cùng |
Cross-encoder khác bi-encoder ở chỗ nó không tạo vector độc lập. Nó cho cả câu hỏi và đoạn văn vào mô hình một lúc, nên bắt được quan hệ tinh hơn, nhưng không thể tính trước. Vì vậy cấu trúc thông dụng là hai tầng: tầng đầu lấy rộng và nhanh, tầng sau chấm lại một danh sách ngắn.
Hybrid search và RRF: kết hợp từ khoá với ngữ nghĩa
Vấn đề kỹ thuật chính của hybrid search là hai thang điểm không so được với nhau. Điểm BM25 là số dương không giới hạn, còn cosine similarity nằm trong khoảng từ -1 đến 1, nên cộng hoặc lấy trung bình trực tiếp dễ sai lệch. Cách phổ biến là Reciprocal Rank Fusion: RRF làm việc trên thứ hạng, không phải điểm số. Mỗi tài liệu nhận điểm bằng tổng của 1/(k + thứ hạng) qua các danh sách, và k thường đặt mặc định là 60.
Ví dụ tính RRF với k = 60
Bảng dưới đây lấy lại ví dụ tính toán với bốn đoạn A, B, C, D, trong đó có đoạn chỉ một nhánh tìm thấy:
| Đoạn | Hạng BM25 | Hạng vector | Phép tính | Điểm RRF |
|---|---|---|---|---|
| A | 1 | 3 | 1/61 + 1/63 | 0,03227 |
| C | 2 | 2 | 1/62 + 1/62 | 0,03226 |
| B | không có | 1 | 1/61 | 0,01639 |
| D | 3 | không có | 1/63 | 0,01587 |
Số liệu trên theo ví dụ của Cloud Soft Solutions. Đoạn nào được cả hai nhánh đồng thuận thì lên đầu, còn đoạn chỉ một nhánh tìm ra vẫn có cơ hội nằm trong danh sách ứng viên.
Về hiệu quả, bài hướng dẫn của Denser dẫn kết quả của Turnbull (2025) trên bộ dữ liệu thương mại điện tử WANDS: hybrid đã tinh chỉnh đạt NDCG 0,7497, cao hơn 7,4% so với BM25 (0,6983) hoặc vector thuần (0,6953). Đây là một bộ dữ liệu tiếng Anh. Mức tăng trên dữ liệu tiếng Việt của bạn có thể khác, nên cần đo lại.
Lý do thực tế của hybrid cũng được mô tả trong nhiều tài liệu kỹ thuật: vector hay làm mờ những từ chính xác như mã sản phẩm, tên và số. Một reranker dạng cross-encoder đặt ở cuối giúp cứu thứ tự cuối cùng.
Ứng dụng của semantic search cho doanh nghiệp Việt Nam
- Tìm trong kho quy chế, hợp đồng, quy trình ISO: nhân viên hỏi bằng lời thường ngày, hệ thống trả về điều khoản đúng. Phù hợp khi tài liệu nhiều và mỗi phòng đặt tên mục một kiểu.
- Helpdesk IT và chăm sóc khách hàng: khớp phiếu hỗ trợ mới với phiếu đã giải quyết, dù khách mô tả bằng từ khác. Ví dụ, “máy in không nhận lệnh” có thể khớp với phiếu ghi “spooler bị treo”.
- Tìm sản phẩm trên website bán hàng: khách gõ “áo mặc đi mưa nhẹ” và vẫn thấy áo khoác chống nước. Mã SKU và tên thương hiệu vẫn nên đi qua nhánh từ khoá.
- Tầng truy xuất của RAG: khi một mô hình ngôn ngữ trả lời dựa trên tài liệu nội bộ, chất lượng câu trả lời phụ thuộc phần lớn vào việc đoạn đúng có được lấy ra hay không. Chi tiết nằm trong bài RAG và cách triển khai.
- Tìm trong kho tri thức có cấu trúc: nơi chứa bài hướng dẫn, FAQ. Nếu bạn đang xây một knowledge base, semantic search giúp người dùng không phải đoán đúng từ khoá.
Về hạ tầng, bạn không nhất thiết cần cơ sở dữ liệu vector riêng. Theo một hướng dẫn kỹ thuật, PostgreSQL xử lý phần từ khoá bằng full-text search và phần vector bằng tiện ích pgvector. Đây là hướng phù hợp khi dữ liệu đã nằm sẵn trong PostgreSQL và quy mô chưa lớn.
Ưu điểm và hạn chế
| Ưu điểm | Hạn chế |
|---|---|
| Tìm được khi câu hỏi và tài liệu dùng từ khác nhau | Có thể trả về đoạn “na ná” nhưng sai chi tiết, ví dụ nhầm điều khoản của hai loại hợp đồng |
| Chịu được câu hỏi dài, nói tự nhiên | Yếu với mã, số hiệu, tên riêng nếu dùng vector thuần |
| Không phải tự soạn danh sách từ đồng nghĩa | Khó giải thích vì sao đoạn này đứng trên đoạn kia, nên khó gỡ lỗi hơn BM25 |
| Dùng được cho nhiều ngôn ngữ nếu chọn mô hình đa ngữ | Tốn chi phí tính embedding và lưu vector. Đổi mô hình là phải tính lại |
| Làm nền cho RAG và trợ lý nội bộ | Không kiểm tra tính đúng của nội dung: tài liệu cũ, sai vẫn được tìm ra |
Semantic search khác gì các khái niệm gần?
- Tìm kiếm từ khoá: khớp chuỗi ký tự. Vẫn là lựa chọn tốt cho mã, tên, số hiệu, và là một nửa của hybrid search.
- RAG: semantic search chỉ trả về đoạn văn. RAG đưa các đoạn đó cho mô hình ngôn ngữ để viết câu trả lời. Vì vậy RAG có thêm rủi ro ở bước sinh, như ảo giác AI.
- AI search: cách gọi rộng cho trải nghiệm tìm kiếm có AI, thường gồm cả tóm tắt và hội thoại. Bạn có thể đọc thêm ở bài AI search. Semantic search là một thành phần kỹ thuật bên trong.
- Knowledge graph: lưu quan hệ rõ ràng giữa các thực thể, ví dụ “Công ty A là nhà cung cấp của dự án B”. Semantic search đo độ gần về nghĩa, không lưu quan hệ tường minh. Hai hướng có thể bổ trợ nhau, xem bài knowledge graph.
- Semantic SEO: tối ưu nội dung website để công cụ tìm kiếm hiểu chủ đề và thực thể. Đó là việc của người làm nội dung, không phải hệ thống bạn tự dựng.
Khi nào nên và không nên dùng semantic search?
Nên dùng khi
- Người dùng hỏi bằng lời tự nhiên và hay diễn đạt khác tài liệu.
- Kho tài liệu viết bởi nhiều người, mỗi người một cách gọi cùng một khái niệm.
- Bạn đang xây trợ lý hoặc chatbot trả lời từ tài liệu nội bộ.
Chưa cần hoặc không nên dùng riêng lẻ khi
- Câu hỏi chủ yếu là tra mã đơn hàng, số hợp đồng, biển số. Tìm chính xác và lọc theo trường dữ liệu đã đủ.
- Dữ liệu là bảng số có cấu trúc. Truy vấn SQL phù hợp hơn.
- Kho tài liệu chỉ vài trăm trang và người dùng đã quen từ khoá. Khi đó lợi ích khó bù chi phí vận hành.
- Tài liệu còn mâu thuẫn, trùng phiên bản. Semantic search sẽ tìm ra cả bản cũ lẫn bản mới, và không biết bản nào đang có hiệu lực.
Làm sao biết semantic search của bạn tìm đúng?
Thử vài câu và thấy kết quả ổn chưa đủ để kết luận. Cách đo thực tế gồm các thao tác sau:
- Thu thập 50 đến 100 câu hỏi thật từ nhật ký tìm kiếm hoặc phiếu hỗ trợ. Với mỗi câu, người am hiểu nội dung ghi rõ đoạn nào là đáp án đúng.
- Chạy từng câu qua ba cấu hình: chỉ BM25, chỉ vector, hybrid. Có thể thêm bản có reranker.
- Tính recall@k (đáp án đúng có nằm trong k kết quả đầu không) và MRR hoặc NDCG (đáp án đúng đứng cao đến đâu). Với RAG, k thường nhỏ vì chỉ vài đoạn đi vào mô hình.
- Đọc riêng các câu thất bại. Nguyên nhân thường rơi vào ba nhóm: chunk bị cắt sai, từ viết tắt nội bộ, hoặc câu hỏi cần nhiều đoạn ghép lại.
Lỗi thường gặp và cách xử lý:
- Đoạn đúng nằm ở hạng 8 nhưng chỉ lấy 5: tăng số ứng viên rồi thêm reranker, thay vì đổi mô hình embedding ngay.
- Mã và tên riêng bị trượt: bật nhánh từ khoá hoặc tăng trọng số cho nhánh này.
- Kết quả đúng chủ đề nhưng sai năm, sai phiên bản: thêm metadata (năm, trạng thái hiệu lực) và lọc theo đó.
- Đổi mô hình embedding làm kết quả xấu đi: chạy lại toàn bộ bộ câu hỏi trước khi chuyển, và tính lại vector của toàn kho.
Nếu kết quả tìm kiếm đi tiếp vào một mô hình ngôn ngữ, hãy xem thêm bài mô hình ngôn ngữ lớn để hiểu giới hạn của bước sinh câu trả lời.
Dữ liệu nhạy cảm và phân quyền khi lập chỉ mục
Vector được tạo từ văn bản nên có thể mang thông tin của văn bản gốc. Nếu kho tài liệu chứa dữ liệu cá nhân, bạn nên coi chỉ mục vector chịu cùng chế độ bảo vệ như tài liệu gốc.
Về kỹ thuật, điểm hay bị bỏ sót là phân quyền. Nếu chỉ mục gộp tài liệu của nhiều phòng ban, người ở phòng này có thể nhận về đoạn thuộc phòng kia chỉ vì nó “gần nghĩa”. Hãy gắn quyền truy cập vào từng đoạn và lọc ngay trong truy vấn. Khi dùng PostgreSQL, một hướng dẫn kỹ thuật cũng khuyên chạy cả hai nhánh với cùng bộ lọc quyền và metadata.
Câu hỏi thường gặp
Semantic search có thay thế hoàn toàn tìm kiếm từ khoá không?
Thường là không. Vector làm tốt việc khớp nghĩa nhưng hay trượt mã, tên riêng và số, nên nhiều hệ thống chạy song song cả hai rồi hợp nhất bằng RRF. Tìm từ khoá vẫn rẻ, dễ giải thích và đủ dùng cho nhiều tình huống tra cứu chính xác.
Semantic search có cần AI tạo sinh không?
Không. Phần lõi chỉ cần mô hình embedding, không cần mô hình sinh văn bản. AI tạo sinh chỉ xuất hiện khi bạn muốn hệ thống viết câu trả lời từ các đoạn tìm được, như trong RAG.
Semantic search có hiểu tiếng Việt tốt không?
Phụ thuộc vào mô hình embedding. Các mô hình đa ngữ thường xử lý được tiếng Việt, nhưng chất lượng với thuật ngữ chuyên ngành, viết tắt nội bộ và văn bản không dấu khác nhau giữa các mô hình. Cách chắc chắn là đo trên bộ câu hỏi thật của bạn.
Có bắt buộc dùng vector database không?
Không bắt buộc. Với quy mô vừa, bạn có thể dùng tiện ích vector trong cơ sở dữ liệu quen thuộc như pgvector của PostgreSQL. Cơ sở dữ liệu vector chuyên dụng đáng cân nhắc khi số lượng vector rất lớn hoặc cần độ trễ thấp.
Semantic search và tìm kiếm của Google có giống nhau không?
Chúng chung ý tưởng là tìm theo ý định và ngữ cảnh thay vì chỉ theo từ khoá, nhưng quy mô và cách vận hành khác nhau. Hệ thống tìm kiếm của Google kết hợp nhiều tín hiệu và nguồn dữ liệu mà doanh nghiệp bên ngoài không có. Semantic search trong doanh nghiệp là hệ thống riêng trên kho dữ liệu của bạn.
Hybrid search có luôn tốt hơn vector thuần?
Không đảm bảo. Trên bộ dữ liệu WANDS mà bài dẫn số liệu của Turnbull (2025), hybrid đã tinh chỉnh cho kết quả cao hơn cả hai phương pháp đơn lẻ. Kết quả đó đến từ một bộ dữ liệu tiếng Anh, nên với dữ liệu tiếng Việt của bạn vẫn cần so sánh trực tiếp ba cấu hình trên cùng bộ câu hỏi.
VBPO cập nhật tin tức và kiến thức công nghệ cho doanh nghiệp Việt Nam. Xem thêm các bài cùng chuyên mục AI tạo sinh & LLM.