
Trả lời nhanh: SQL là cơ sở dữ liệu quan hệ: dữ liệu nằm trong bảng có lược đồ cố định, nối với nhau bằng khoá, truy vấn bằng ngôn ngữ SQL chuẩn. NoSQL gồm nhiều mô hình không quan hệ (document, key-value, cột rộng, đồ thị) với lược đồ linh hoạt, thường dễ mở rộng ngang hơn. Hai bên đang xích lại gần nhau, nên chọn theo cách truy cập dữ liệu.
Điểm chính
- Khác biệt cốt lõi nằm ở mô hình dữ liệu và nơi đặt các ràng buộc: SQL đặt ở cơ sở dữ liệu, NoSQL thường đặt ở ứng dụng.
- “NoSQL” là tên chung của bốn họ công nghệ rất khác nhau, nên không thể so “SQL với NoSQL” như so hai sản phẩm.
- NoSQL không đồng nghĩa với mất giao dịch ACID: một số hệ đã hỗ trợ, nhưng chi phí và giới hạn khác SQL.
- Nhiều hệ thống thực tế dùng cả hai (polyglot persistence), mỗi loại cho một nhóm dữ liệu.
- Ma trận và quy trình chọn trong bài giúp quyết định theo quan hệ dữ liệu, mức thay đổi cấu trúc và yêu cầu nhất quán.
Mục lục
- Khác biệt gốc: mô hình dữ liệu, không phải “có SQL hay không”
- Bảng so sánh SQL và NoSQL theo tiêu chí vận hành
- Bốn họ NoSQL: mỗi họ giải một bài toán khác nhau
- Giao dịch và tính nhất quán: chỗ hiểu lầm nhiều nhất
- Mở rộng quy mô: dọc, ngang và thực tế đằng sau
- Lược đồ linh hoạt: lợi thế thật và cái bẫy đi kèm
- Truy vấn và phân tích: nơi SQL vẫn dẫn trước
- Ma trận chọn: ba câu hỏi quyết định hơn mọi bảng so sánh
- Khi nào nên chọn SQL, khi nào nên chọn NoSQL
- Dùng cả hai: mô hình đa lưu trữ trong doanh nghiệp
- Chuyển đổi dữ liệu cá nhân: điểm áp dụng riêng cho từng loại
- Lộ trình đánh giá trước khi chọn
- Lỗi thường gặp khi chọn và cách xử lý
- Câu hỏi thường gặp
Khác biệt gốc: mô hình dữ liệu, không phải “có SQL hay không”
Nhiều bài trả lời câu hỏi này bằng một bảng “bảng so với tài liệu, dọc so với ngang”. Bảng đó đúng nhưng chưa đủ để quyết định. Cần hiểu hai điểm: SQL vừa là tên ngôn ngữ truy vấn vừa là cách gọi chung cho hệ quản trị cơ sở dữ liệu quan hệ (RDBMS) như PostgreSQL, MySQL, SQL Server, Oracle. NoSQL không phải một công nghệ mà là nhóm hệ thống không theo mô hình quan hệ. Nếu cần nền tảng, bạn có thể đọc bài cơ sở dữ liệu là gì và bài riêng về NoSQL và các họ của nó.
Trong mô hình quan hệ, bạn tách dữ liệu thành nhiều bảng nhỏ không lặp (chuẩn hoá), rồi ghép lại bằng phép JOIN khi đọc. Trong mô hình document, bạn gom dữ liệu thường đọc cùng nhau vào một tài liệu (thường là JSON) và chấp nhận lặp một phần. Một bên tối ưu cho việc ghi và giữ đúng dữ liệu ở một chỗ, bên kia tối ưu cho việc đọc nhanh một “cụm” dữ liệu.
Ví dụ minh hoạ: một đơn hàng của cửa hàng online
Ví dụ minh hoạ: đơn hàng gồm khách, địa chỉ giao và ba dòng sản phẩm. Ở SQL, dữ liệu rải trên ba bảng. Ở document, cả đơn nằm trong một tài liệu.
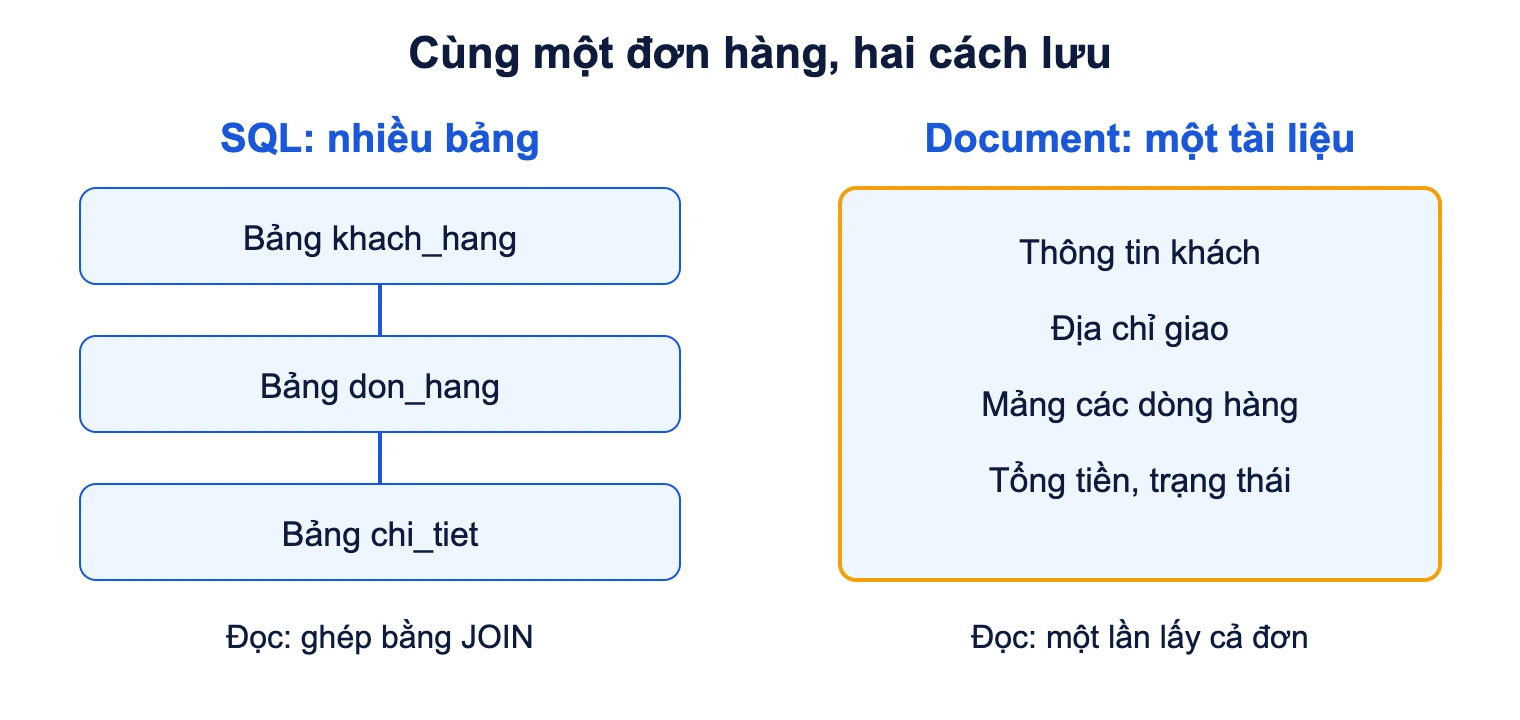
Cái giá của cách thứ hai: nếu khách đổi số điện thoại, bản sao cũ trong các đơn trước có thể phải giữ nguyên (đúng nghiệp vụ, vì đó là số lúc đặt hàng) hoặc phải cập nhật hàng loạt (nếu là thông tin cần đồng bộ). Quyết định đó do bạn thiết kế, không phải cơ sở dữ liệu tự lo như khoá ngoại ở SQL.
Bảng so sánh SQL và NoSQL theo tiêu chí vận hành
| Tiêu chí | SQL (quan hệ) | NoSQL |
|---|---|---|
| Mô hình | Bảng, hàng, cột; khoá chính và khoá ngoại | Document, key-value, cột rộng (wide-column), đồ thị |
| Lược đồ (schema) | Khai báo trước, thay đổi qua lệnh migration | Linh hoạt, thường do ứng dụng kiểm soát; vẫn nên có quy ước |
| Ngôn ngữ truy vấn | SQL, có chuẩn chung, chuyển đổi giữa hệ khá dễ | Mỗi hệ một cách: API của MongoDB, CQL của Cassandra, Cypher của Neo4j, lệnh Redis |
| Quan hệ giữa dữ liệu | JOIN và ràng buộc toàn vẹn ngay trong cơ sở dữ liệu | Thường nhúng hoặc tham chiếu thủ công; đồ thị là ngoại lệ mạnh |
| Giao dịch | ACID trên nhiều bảng là mặc định | Tuỳ hệ: có hệ chỉ đảm bảo trên một bản ghi, có hệ hỗ trợ đa tài liệu |
| Mở rộng | Thường nâng cấu hình máy trước, đọc thêm qua bản sao; chia dữ liệu (sharding) khó hơn | Thiết kế sẵn để chia dữ liệu qua nhiều nút |
| Phân tích báo cáo | Mạnh: gom nhóm, JOIN phức tạp, cửa sổ (window function) | Hạn chế hơn với truy vấn tuỳ biến; thường đẩy sang kho phân tích |
| Rủi ro điển hình | Migration lớn khi đổi cấu trúc; nghẽn cổ chai ở một nút ghi | Dữ liệu trùng lệch nhau, truy vấn chưa lường trước phải quét toàn bộ |
Bảng này nói về xu hướng chung. Từng sản phẩm có ngoại lệ, nên bước cuối luôn là đọc tài liệu của đúng phiên bản bạn định dùng.
Bốn họ NoSQL: mỗi họ giải một bài toán khác nhau
Gộp tất cả vào chữ “NoSQL” là nguyên nhân phổ biến của việc chọn sai. Đặt MongoDB cạnh Redis để so sánh cũng như đặt xe tải cạnh xe máy giao hàng.
- Document (ví dụ MongoDB, Couchbase): lưu JSON/BSON, hợp với danh mục sản phẩm có thuộc tính khác nhau theo loại hàng, hồ sơ người dùng, nội dung CMS.
- Key-value (ví dụ Redis, DynamoDB): tra cứu theo khoá rất nhanh. Redis giữ dữ liệu chủ yếu trong bộ nhớ nên hay làm bộ nhớ đệm (cache), phiên đăng nhập, bộ đếm, hàng đợi.
- Cột rộng (ví dụ Cassandra): ghi khối lượng lớn, dữ liệu theo thời gian như nhật ký thiết bị, sự kiện; thiết kế bảng xoay quanh câu truy vấn định trước.
- Đồ thị (ví dụ Neo4j): quan hệ là trung tâm, như phát hiện vòng gian lận, mạng lưới giới thiệu, truy vết chuỗi cung ứng.
Ngoài bốn họ này còn cơ sở dữ liệu vector phục vụ tìm kiếm theo ngữ nghĩa cho ứng dụng AI. Nó có logic riêng, bạn xem thêm ở bài vector database và cách chọn.
Giao dịch và tính nhất quán: chỗ hiểu lầm nhiều nhất
ACID và vì sao SQL được tin dùng cho tiền và kho
ACID gồm tính nguyên tử, nhất quán, cô lập và bền vững. Với SQL, bạn bọc “trừ tiền tài khoản A, cộng tiền tài khoản B” trong một giao dịch: hoặc cả hai thành công, hoặc không gì thay đổi. Đây là lý do hệ thống kế toán, ngân hàng lõi, tồn kho, ERP thường chọn quan hệ.
NoSQL và ACID: câu “NoSQL không có giao dịch” đã lỗi thời một phần
Cách nói này đúng với nhiều hệ ở giai đoạn đầu nhưng không đúng chung. MongoDB hỗ trợ giao dịch ACID đa tài liệu từ phiên bản 4.0 cho replica set và từ 4.2 cho cụm sharded. Tuy vậy, tài liệu về chủ đề này cũng khuyên không dùng giao dịch cho mọi thao tác ghi: giao dịch tốn hiệu năng hơn so với ghi một tài liệu. Nói cách khác, thiết kế document tốt vẫn cố đưa dữ liệu cần đổi cùng lúc vào một tài liệu để tránh phải dùng giao dịch.
Ngược lại, các hệ như Cassandra cho phép chỉnh mức nhất quán theo từng truy vấn (ví dụ yêu cầu đa số nút xác nhận). Bạn đổi một ít độ trễ lấy độ tin cậy cao hơn.
Định lý CAP trong một câu có ích
Khi mạng giữa các nút bị chia cắt, hệ phân tán phải chọn giữa trả lời ngay (có thể dữ liệu cũ) hoặc từ chối cho đến khi đồng bộ (nhất quán nhưng tạm không sẵn sàng). Cơ sở dữ liệu một máy chủ ít gặp lựa chọn này, còn hệ chia nhiều nút thì không tránh được. Đó là lý do “mở rộng ngang” không miễn phí.
Tình huống cần cẩn thận (ví dụ minh hoạ): hệ thống đặt hàng giảm tồn kho khi có đơn. Nếu tồn kho nằm ở một tài liệu và đơn nằm ở tài liệu khác, hai thao tác ghi riêng lẻ có thể lệch khi một bước lỗi giữa chừng. Bạn cần giao dịch, hoặc thiết kế lại để một thao tác ghi đủ cho cả hai việc.
Mở rộng quy mô: dọc, ngang và thực tế đằng sau
Mở rộng dọc là tăng CPU, RAM, ổ đĩa cho một máy. Mở rộng ngang là thêm máy và chia dữ liệu. Các bài phổ biến thường kết luận “SQL chỉ mở rộng dọc”. Thực tế chính xác hơn như sau:
- SQL có bản sao chỉ đọc (read replica) để chia tải đọc; tải ghi vẫn tập trung ở nút chính trừ khi bạn chia dữ liệu (sharding) hoặc dùng sản phẩm quan hệ phân tán.
- NoSQL phân tán chia dữ liệu theo khoá phân vùng. Chọn khoá sai sẽ gây “điểm nóng”: một nút gánh phần lớn tải trong khi nút khác rảnh.
- Với đa số doanh nghiệp Việt Nam, một máy chủ PostgreSQL hoặc MySQL được tối ưu chỉ mục và truy vấn đã đủ cho nhiều năm. Quy mô cần chia nút thường đến từ ứng dụng có hàng triệu sự kiện mỗi ngày, không phải từ hệ thống nội bộ vài trăm người dùng.
Truy vấn chậm ở hệ SQL thường do thiếu chỉ mục hoặc truy vấn viết kém, chứ không phải do mô hình quan hệ. Hãy đo bằng kế hoạch thực thi (EXPLAIN) trước khi quy lỗi cho công nghệ.
Lược đồ linh hoạt: lợi thế thật và cái bẫy đi kèm
Lợi thế: bạn thêm trường mới vào tài liệu mà không cần khoá bảng hay chạy migration lớn. Điều này hợp với sản phẩm đang thử nghiệm, hoặc dữ liệu nhiều nhóm có thuộc tính khác nhau (điện thoại có dung lượng, áo có size). Về loại dữ liệu, bạn có thể đối chiếu thêm với bài dữ liệu có cấu trúc và phi cấu trúc.
Cái bẫy: “không cần lược đồ” thực chất là lược đồ nằm trong mã ứng dụng. Sau hai năm, cùng một trường có thể tồn tại ở ba định dạng (số, chuỗi, rỗng) vì các phiên bản mã khác nhau ghi vào. Khi đó báo cáo phải xử lý mọi biến thể. Thực hành tốt là dùng kiểm tra lược đồ ở phía cơ sở dữ liệu (như JSON Schema validation của MongoDB) và gắn số phiên bản lược đồ vào tài liệu.
Chiều ngược lại cũng đáng biết: các hệ SQL hiện đại như PostgreSQL và MySQL có kiểu dữ liệu JSON, nên bạn có thể giữ một cột thuộc tính linh hoạt trong bảng quan hệ mà không cần thêm hệ thống mới.
Truy vấn và phân tích: nơi SQL vẫn dẫn trước
SQL có chuẩn chung, hệ sinh thái công cụ báo cáo rộng và đội ngũ nhân sự quen dùng. Các công cụ BI thường kết nối tự nhiên với nguồn quan hệ. Với NoSQL, bạn thường phải xuất dữ liệu sang kho phân tích qua quy trình ETL hoặc ELT, hoặc dùng bộ kết nối riêng từng hệ.
Cũng cần phân biệt khối lượng công việc: giao dịch (đọc ghi nhiều bản ghi nhỏ) khác phân tích (quét lượng lớn, tổng hợp). Sự khác biệt này không trùng hoàn toàn với SQL/NoSQL, bạn có thể xem bài OLAP và OLTP để tách hai việc này trước khi chọn công nghệ.
Điểm yếu thường gặp của NoSQL là “truy vấn chưa lường trước”. Cơ sở dữ liệu cột rộng được thiết kế quanh câu hỏi định trước; câu hỏi mới của phòng kinh doanh có thể buộc dựng bảng mới hoặc chạy xử lý riêng. Ở SQL, một câu hỏi mới thường chỉ cần một câu truy vấn mới, miễn dữ liệu đã được chuẩn hoá.
Ma trận chọn: ba câu hỏi quyết định hơn mọi bảng so sánh
Thay vì hỏi “công nghệ nào mới hơn”, hãy đặt dữ liệu của bạn lên hai trục: mức độ quan hệ chằng chịt giữa các thực thể, và mức độ cấu trúc thay đổi hoặc không đồng đều.
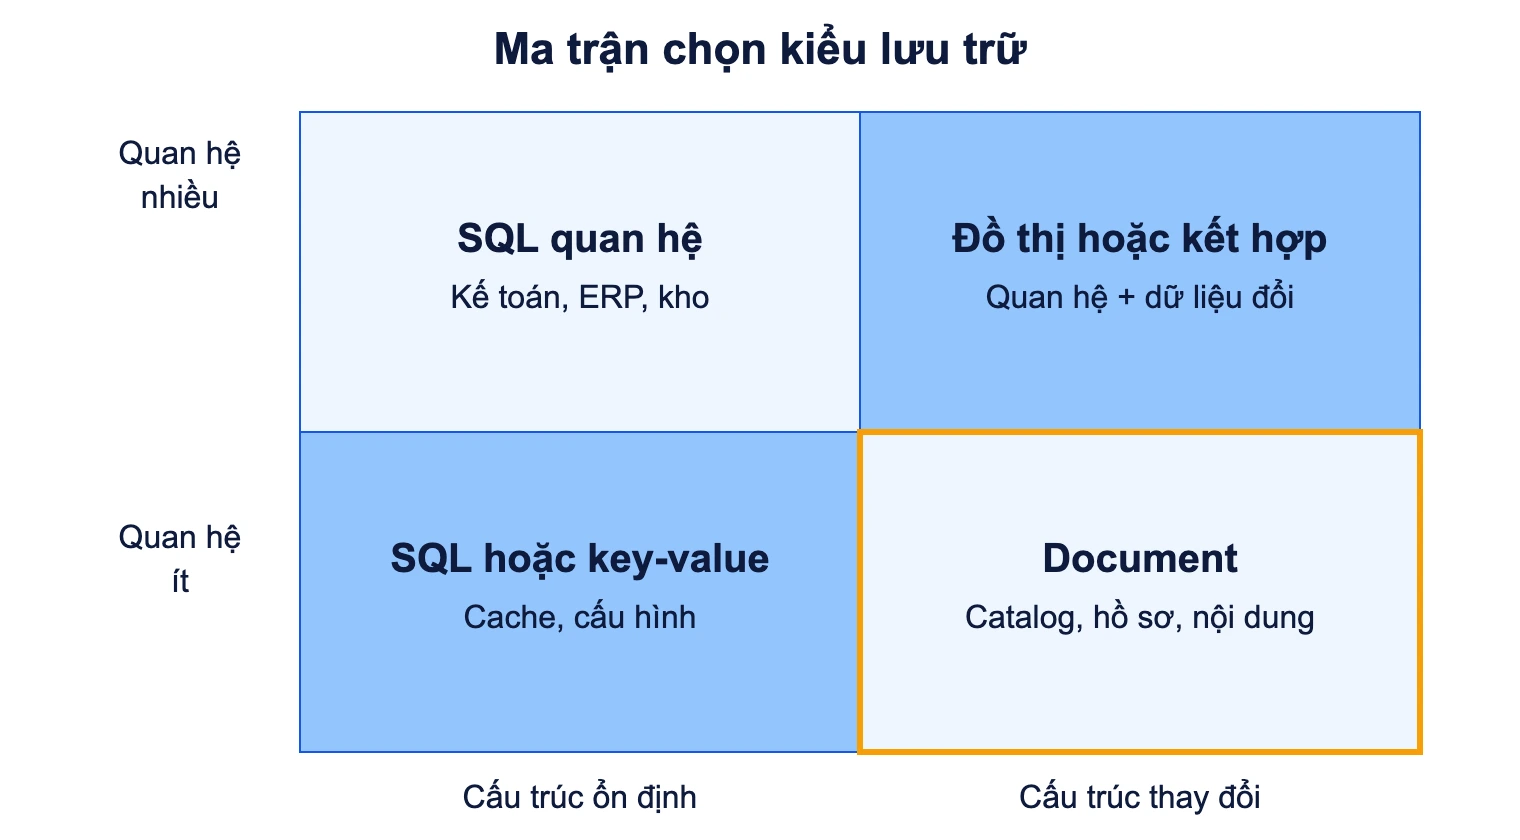
Câu hỏi thứ ba nằm ngoài ma trận: sai lệch tạm thời có chấp nhận được không? Số dư ví, tồn kho, hoá đơn thì không. Số lượt xem, gợi ý sản phẩm, trạng thái trực tuyến thì thường chấp nhận. Nếu không, dù ma trận chỉ về ô nào, bạn vẫn cần cơ chế giao dịch mạnh.
Khi nào nên chọn SQL, khi nào nên chọn NoSQL
Nên ưu tiên SQL khi
- Dữ liệu có nhiều thực thể liên kết và ràng buộc rõ (khách hàng, hợp đồng, hoá đơn, thanh toán), cần khoá ngoại và ràng buộc duy nhất để chặn dữ liệu rác.
- Bộ phận kế toán, kinh doanh thường xuyên hỏi câu hỏi mới trên cùng dữ liệu.
- Đội ngũ đã có kỹ năng SQL; điều này giảm chi phí tuyển dụng và vận hành.
- Bạn chưa biết chắc quy mô: SQL là điểm khởi đầu ít rủi ro cho đa số ứng dụng nghiệp vụ.
Nên cân nhắc NoSQL khi
- Đơn vị đọc ghi tự nhiên là một “cụm” (hồ sơ, đơn, phiên làm việc) và hiếm khi cần ghép chéo.
- Thuộc tính khác nhau mạnh theo bản ghi, hoặc lược đồ đổi theo từng tuần phát hành.
- Khối lượng ghi rất lớn, độ trễ thấp là ràng buộc cứng, ví dụ nhật ký thiết bị IoT, bộ đếm, cache.
- Quan hệ nhiều tầng là bản chất bài toán (đồ thị), mà JOIN nhiều tầng trong SQL trở nên chậm và khó đọc.
Khi nào không nên đổi
Không nên chuyển sang NoSQL chỉ vì hệ thống hiện tại chậm mà chưa xem chỉ mục và kế hoạch truy vấn. Cũng không nên chọn NoSQL cho hệ thống tài chính chỉ vì nghe nói “dễ mở rộng” khi chưa có ai thiết kế được cách giữ nhất quán giữa các tài liệu.
Dùng cả hai: mô hình đa lưu trữ trong doanh nghiệp
Ví dụ minh hoạ: một sàn thương mại điện tử cỡ vừa có thể dùng PostgreSQL cho đơn hàng, thanh toán và tồn kho; MongoDB cho danh mục sản phẩm nhiều thuộc tính; Redis cho giỏ hàng tạm và phiên đăng nhập. Dữ liệu từ ba nguồn được nạp định kỳ qua data pipeline vào kho phân tích. Nếu bạn cần hiểu kho đó khác cơ sở dữ liệu giao dịch thế nào, xem bài data warehouse.
Cái giá của đa lưu trữ là vận hành nhiều hệ: sao lưu, giám sát, nâng cấp, phân quyền khác nhau; và cùng một khách hàng có thể xuất hiện ở nhiều nơi với mã khác nhau. Vì vậy cần một nguồn sự thật cho mã khách hàng và quy ước dữ liệu chung, thuộc phạm vi quản trị dữ liệu, xem khung quản trị dữ liệu.
Chuyển đổi dữ liệu cá nhân: điểm áp dụng riêng cho từng loại
Về mặt kỹ thuật lưu trữ, một điểm cần lưu ý là yêu cầu xoá hoặc chỉnh sửa dữ liệu của chủ thể. Với SQL chuẩn hoá, thông tin cá nhân thường nằm ở vài bảng nên dễ xác định chỗ xử lý. Với document phi chuẩn hoá, cùng thông tin có thể nằm trong nhiều tài liệu, bản sao đệm Redis, chỉ mục tìm kiếm và bản sao lưu; bạn nên lập sơ đồ nơi chứa từng trường cá nhân ngay lúc thiết kế, không đợi đến khi có yêu cầu.
Lộ trình đánh giá trước khi chọn
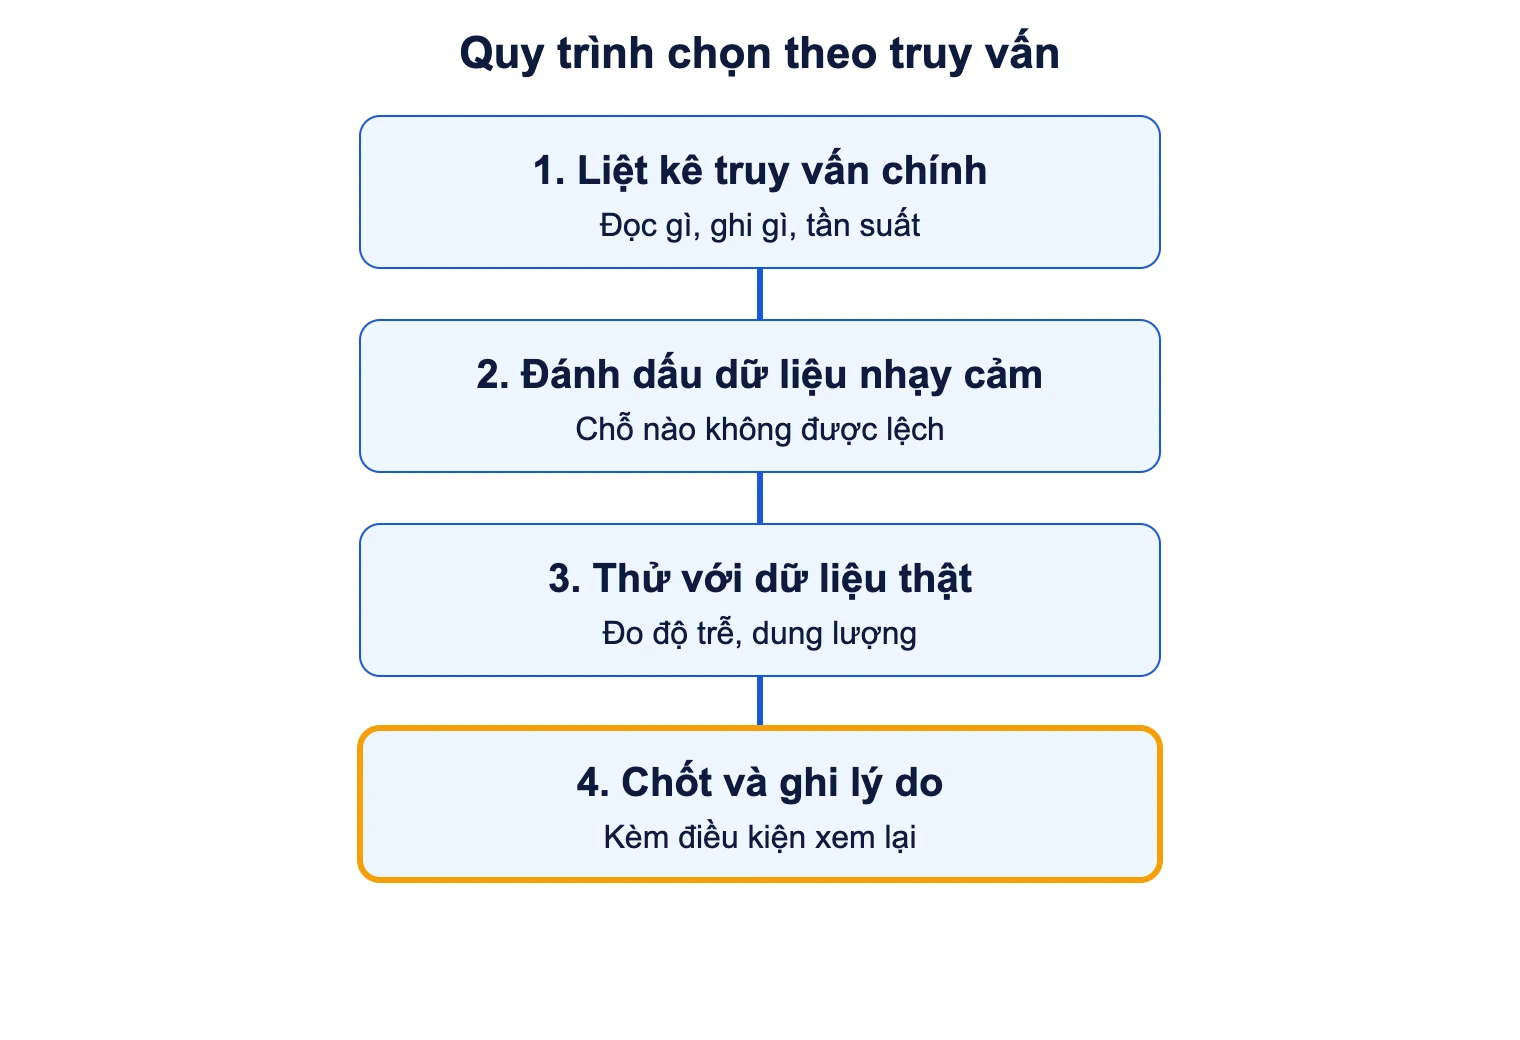
- Liệt kê 10 đến 20 truy vấn quan trọng nhất: ví dụ “lấy đơn của khách theo mã”, “tổng doanh thu theo tỉnh theo tuần”. Nếu phần lớn là câu đầu (lấy một cụm theo khoá), document hoặc key-value phù hợp; nếu nhiều câu sau, ưu tiên quan hệ.
- Đánh dấu dữ liệu không được phép lệch: tiền, tồn kho, hạn mức. Với nhóm này, kiểm tra hệ NoSQL định chọn hỗ trợ giao dịch đến mức nào, và trong phiên bản nào.
- Nạp thử vài triệu bản ghi thật đã ẩn danh và chạy các truy vấn ở bước 1 với số lượng người dùng đồng thời gần thực tế. Ghi lại độ trễ phân vị 95, dung lượng đĩa, thời gian khôi phục từ bản sao lưu.
- Ghi lại quyết định và điều kiện xem lại: ví dụ “xem lại nếu tải ghi vượt mức X” để lần sau tranh luận có căn cứ.
Nếu bài toán của bạn là báo cáo và dự báo, hãy tham khảo thêm hệ thống BI để xem dữ liệu sẽ được dùng ra sao ở đầu ra, vì đầu ra này thường là nơi lộ ra sai lầm của lựa chọn lưu trữ.
Lỗi thường gặp khi chọn và cách xử lý
| Lỗi | Biểu hiện | Cách xử lý |
|---|---|---|
| Dùng document như bảng quan hệ | Nhiều tài liệu chỉ chứa mã tham chiếu, ứng dụng phải ghép tay nhiều lượt | Nhúng dữ liệu hay đọc cùng nhau; hoặc quay lại SQL |
| Nhúng mảng phình vô hạn | Tài liệu tăng mãi (ví dụ lưu mọi bình luận trong bài), chậm dần | Tách ra bộ sưu tập riêng, giới hạn kích thước |
| Chọn khoá phân vùng kém | Một nút quá tải khi dữ liệu dồn theo ngày hoặc theo khách lớn | Chọn khoá có độ phân tán cao, thử tải trước |
| Không kiểm lược đồ | Cùng trường mang nhiều kiểu dữ liệu, báo cáo lỗi | Bật xác thực lược đồ, chuẩn hoá bằng tác vụ định kỳ |
| Chuyển đổi vì hiệu năng mà chưa tối ưu SQL | Truy vấn quét toàn bảng | Thêm chỉ mục, xem kế hoạch thực thi, phân vùng bảng |
| Bỏ qua chất lượng dữ liệu | Trùng, thiếu, sai định dạng ở cả hai loại | Quy tắc kiểm tra từ lúc nhập; xem chất lượng dữ liệu |
Lưu ý: dù chọn loại nào, chất lượng dữ liệu đầu vào vẫn quyết định giá trị báo cáo. Công nghệ lưu trữ không tự sửa dữ liệu sai.
Câu hỏi thường gặp
SQL nhanh hơn hay NoSQL nhanh hơn?
Không có câu trả lời chung. Key-value như Redis rất nhanh cho tra cứu theo khoá. Với truy vấn tổng hợp nhiều bảng, SQL có chỉ mục tốt thường nhanh và dễ viết hơn. Hãy đo bằng truy vấn thật của bạn.
NoSQL có hỗ trợ ACID không?
Tuỳ hệ. MongoDB hỗ trợ giao dịch ACID đa tài liệu từ bản 4.0 phát hành năm 2018. Các hệ khác có phạm vi bảo đảm khác nhau, nên cần đọc tài liệu về mức nhất quán và giao dịch của đúng sản phẩm và phiên bản.
Doanh nghiệp nhỏ nên bắt đầu bằng SQL hay NoSQL?
Nếu dữ liệu là nghiệp vụ như khách hàng, đơn hàng, công nợ, SQL thường là lựa chọn mặc định vì có ràng buộc, công cụ báo cáo và nhân lực phổ biến. NoSQL hợp khi có một phần dữ liệu đặc thù như danh mục đa thuộc tính hoặc cache.
Có thể lưu JSON trong cơ sở dữ liệu SQL không?
Có. PostgreSQL và MySQL đều có kiểu JSON, cho phép lưu và truy vấn trường bên trong. Cách này hợp khi chỉ một phần nhỏ dữ liệu cần linh hoạt, bạn không phải dựng thêm hệ thống riêng.
NoSQL có thay thế kho dữ liệu hoặc data lake không?
Không cùng mục đích. NoSQL thường phục vụ ứng dụng vận hành, còn phân tích tổng hợp dùng kho dữ liệu hoặc data lake. Dữ liệu từ NoSQL thường được đưa sang đó để phân tích.
Chuyển từ SQL sang NoSQL (hoặc ngược lại) khó đến mức nào?
Khó hơn đổi hệ cùng loại, vì phải thiết kế lại mô hình dữ liệu và viết lại phần truy cập trong ứng dụng, không chỉ chép dữ liệu. Vì vậy nên thử trên dữ liệu mẫu thật và ghi rõ điều kiện chuyển trước khi cam kết.
Đọc thêm tin tức, phân tích về AI, blockchain và chuyển đổi số trên trang tin công nghệ VBPO, hoặc các bài khác trong chuyên mục Dữ liệu & phân tích.