
Trả lời nhanh: Anomaly detection (phát hiện bất thường) là kỹ thuật tìm các điểm dữ liệu, sự kiện hoặc chuỗi hành vi lệch rõ rệt khỏi quy luật thông thường. Hệ thống học hoặc được khai báo thế nào là “bình thường”, chấm điểm độ lệch, rồi cảnh báo khi vượt ngưỡng để người kiểm tra.
Điểm chính
- Bất thường chia ba loại: điểm, theo ngữ cảnh và theo tập hợp. Mỗi loại cần cách bắt khác nhau.
- Phần lớn hệ thống thực tế không có nhãn “bất thường” nên dùng phương pháp không giám sát hoặc bán giám sát.
- Bất thường chỉ là “lạ”, chưa chắc là “xấu”. Kết quả luôn cần người xác minh.
- Điểm khó nhất là ngưỡng cảnh báo và tỷ lệ cảnh báo sai, không phải chọn thuật toán.
Mục lục
- Anomaly detection là gì?
- Ba loại bất thường bạn cần phân biệt
- Anomaly detection hoạt động thế nào?
- Các nhóm phương pháp và thuật toán thường gặp
- Chọn cách tiếp cận theo dữ liệu bạn có
- Ví dụ thực tế cho doanh nghiệp Việt Nam
- Vì sao cảnh báo sai là vấn đề lớn nhất?
- Những lỗi thường gặp khi triển khai
- Ưu điểm và hạn chế
- So sánh với các khái niệm gần
- Khi nào nên và không nên dùng?
- Câu hỏi thường gặp
Anomaly detection là gì?
Anomaly detection, tiếng Việt gọi là phát hiện bất thường hoặc phát hiện dị thường, là bài toán xác định những quan sát không phù hợp với mẫu hành vi dự kiến của tập dữ liệu. Trong thống kê, các điểm này còn gọi là ngoại lai (outlier). Trong vận hành, chúng xuất hiện dưới dạng cảnh báo: một giao dịch lạ, một máy rung bất thường, một tài khoản đăng nhập sai liên tục.
Điểm dễ nhầm là “bất thường” không đồng nghĩa với “sai” hay “gian lận”. Một đơn hàng gấp 20 lần thường lệ có thể là khách sỉ mới, cũng có thể là thẻ bị đánh cắp. Hệ thống chỉ nói “điểm này khác phần còn lại”, còn kết luận thuộc về người có nghiệp vụ.
Về bản chất, đây là một nhánh của machine learning, nhưng cũng có thể làm hoàn toàn bằng quy tắc và thống kê, không cần mô hình học máy. Nếu bạn cần nền tảng rộng hơn về lĩnh vực, hãy xem bài AI là gì.
Ba loại bất thường bạn cần phân biệt
Nhiều bài chỉ nói chung chung về “điểm lạ”. Trong thực tế, cách phân loại dưới đây quyết định bạn chọn kỹ thuật nào.
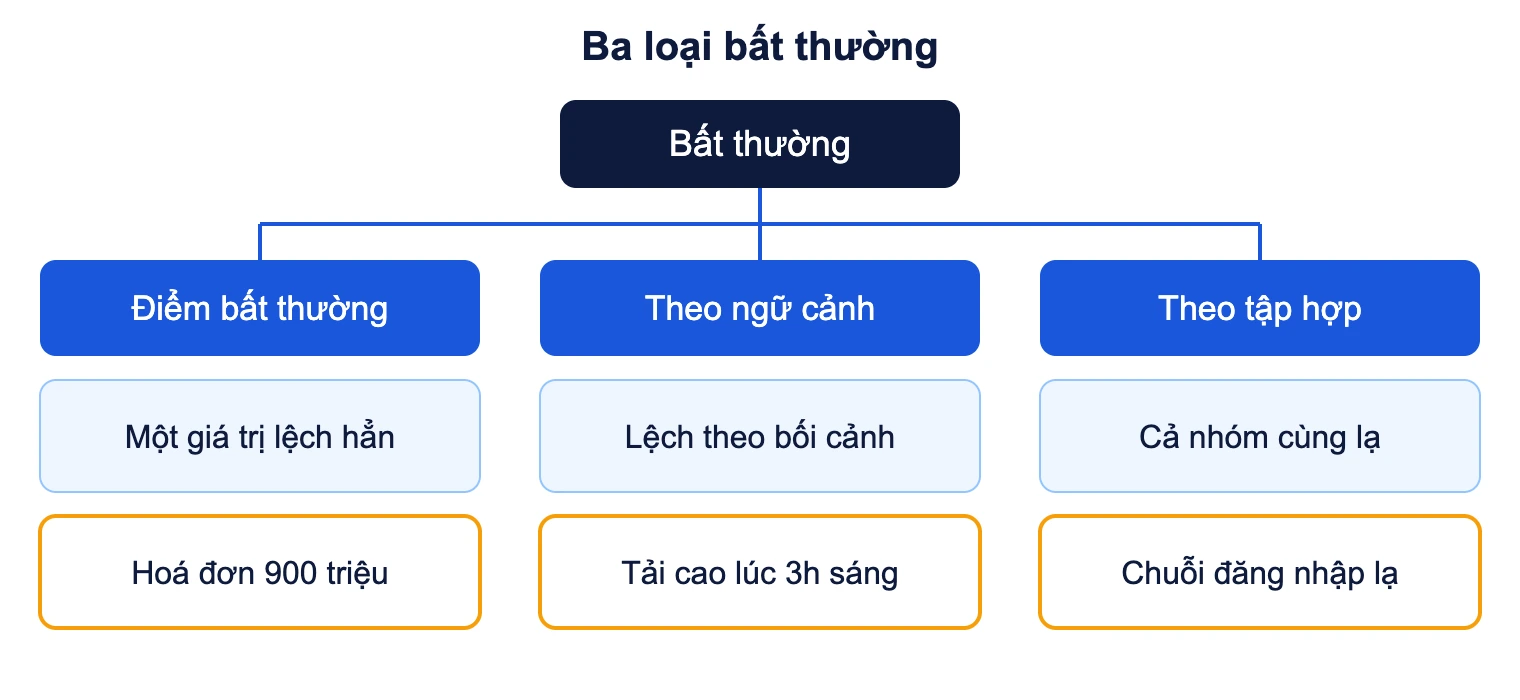
- Điểm bất thường (point anomaly): một bản ghi tự thân đã lạ. Ví dụ minh hoạ: nhiệt độ lò hiển thị âm 40 độ C do cảm biến hỏng. Ngưỡng thống kê đơn giản thường đủ.
- Bất thường theo ngữ cảnh (contextual anomaly): giá trị bình thường ở bối cảnh này nhưng lạ ở bối cảnh khác. Lưu lượng 5.000 yêu cầu mỗi phút là bình thường lúc khuyến mãi 12h trưa, nhưng đáng ngờ lúc 3h sáng. Mô hình phải biết giờ, ngày trong tuần, mùa vụ.
- Bất thường theo tập hợp (collective anomaly): từng bản ghi đều trông bình thường, nhưng cả chuỗi thì không. Ví dụ minh hoạ: mỗi lần chuyển 9 triệu đồng đều dưới mức cảnh báo, nhưng 40 lần liên tiếp trong một giờ sang nhiều tài khoản mới thì là mẫu đáng xem xét.
Anomaly detection hoạt động thế nào?
Mọi hệ thống phát hiện bất thường đều làm cùng một việc: dựng mô hình “bình thường”, đo độ lệch của quan sát mới so với mô hình đó, rồi quyết định có báo hay không.
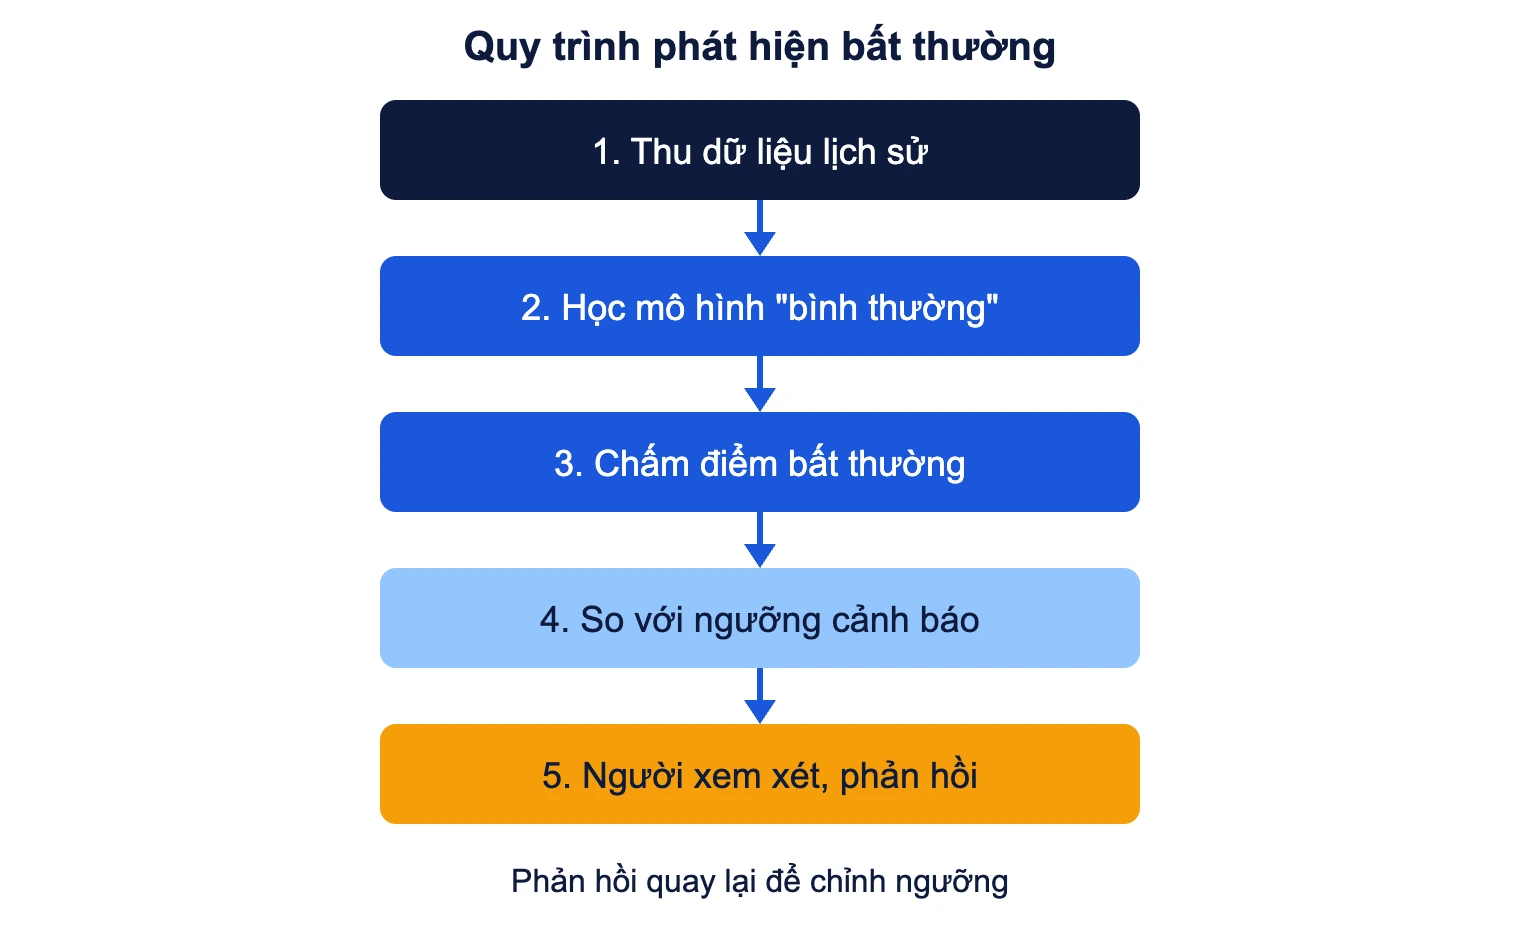
Bước 3 và 4 thường bị gộp nhầm. Điểm bất thường (anomaly score) là con số liên tục, ví dụ từ 0 đến 1. Ngưỡng là quyết định kinh doanh: đặt thấp thì nhiều cảnh báo sai, đặt cao thì bỏ sót. Cùng một mô hình, hai phòng ban có thể chọn hai ngưỡng khác nhau.
Các nhóm phương pháp và thuật toán thường gặp
Thống kê và quy tắc
Cách đơn giản nhất là tính trung bình, độ lệch chuẩn rồi báo khi giá trị cách xa vài độ lệch chuẩn. Một biến thể bền hơn dùng trung vị và khoảng tứ phân vị (IQR) để ít bị ảnh hưởng bởi chính các điểm bất thường. Với dữ liệu có chu kỳ như doanh thu theo tuần, bạn tách xu hướng và mùa vụ trước, rồi mới xét phần dư. Cách này dễ giải thích với kế toán, kiểm toán, và là điểm xuất phát hợp lý trước khi nghĩ đến mô hình phức tạp.
Isolation Forest
Đây là thuật toán không giám sát phổ biến. Ý tưởng: bất thường thì ít và khác biệt nên dễ bị “cô lập”. Theo tài liệu scikit-learn, thuật toán chọn ngẫu nhiên một đặc trưng, chọn ngẫu nhiên điểm cắt giữa giá trị nhỏ nhất và lớn nhất của đặc trưng đó, rồi lặp lại. Số lần cắt cần để cô lập một mẫu tương đương độ dài đường đi từ gốc đến lá, và đường ngắn nghĩa là bất thường hơn. Điểm cuối là trung bình qua nhiều cây.
Trong scikit-learn, mặc định là 100 cây (n_estimators=100) và tham số contamination đặt là “auto”. Nếu bạn nhập một số thực, giá trị phải nằm trong khoảng (0; 0,5], và nó quyết định bao nhiêu phần trăm mẫu huấn luyện bị gán nhãn bất thường. Đây là chỗ nhiều người mắc lỗi: nhập 0,1 thì dù dữ liệu sạch, khoảng 10% vẫn bị đánh dấu.
Phương pháp dựa trên khoảng cách và mật độ
Các phương pháp như k láng giềng gần nhất hoặc Local Outlier Factor so sánh mật độ quanh một điểm với mật độ quanh các điểm lân cận. Chúng bắt được bất thường cục bộ, thứ mà phân vùng toàn cục dễ bỏ sót, nhưng tốn tính toán khi dữ liệu lớn và nhạy với thang đo, nên cần chuẩn hoá đặc trưng trước.
Mạng nơ-ron: autoencoder
Autoencoder là một mạng nơ-ron được huấn luyện nén dữ liệu bình thường rồi dựng lại. Khi gặp mẫu lạ, mạng dựng lại kém, sai số dựng lại cao chính là điểm bất thường. Cách này hợp với dữ liệu nhiều chiều như ảnh, tín hiệu rung, nhưng khó giải thích hơn và cần đủ dữ liệu “sạch” để học.
Học có giám sát khi đã có nhãn
Nếu bạn có nhiều năm hồ sơ đã được đánh dấu “gian lận” và “bình thường”, bài toán thực chất chuyển sang phân loại. Khi đó học có giám sát thường chính xác hơn các phương pháp không nhãn, với điều kiện nhãn đủ nhiều và không lỗi thời. Điểm yếu: nó chỉ nhận ra kiểu bất thường đã từng thấy.
Chọn cách tiếp cận theo dữ liệu bạn có
Thay vì hỏi “thuật toán nào tốt nhất”, hãy hỏi hai câu: đã có nhãn bất thường chưa, và quy tắc nghiệp vụ đã rõ chưa.
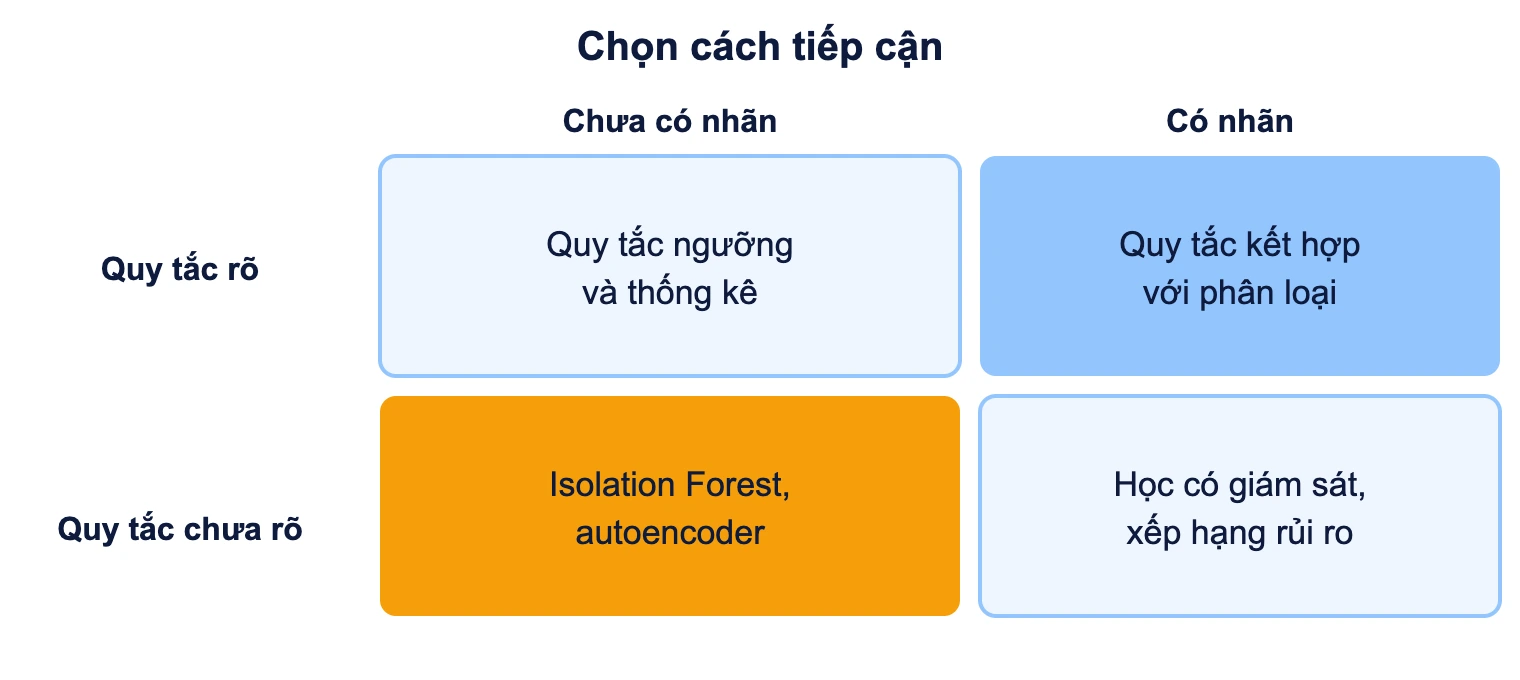
Ô cam, chưa có nhãn và chưa rõ quy tắc, là nơi các mô hình không giám sát phát huy. Đây cũng là ô khó nhất để kiểm chứng, vì không có đáp án chuẩn để chấm điểm mô hình.
Ví dụ thực tế cho doanh nghiệp Việt Nam
Các tình huống dưới đây là ví dụ minh hoạ, không phải số liệu của doanh nghiệp cụ thể.
- Ngân hàng, ví điện tử: phát hiện giao dịch lệch thói quen của chủ tài khoản về giờ, thiết bị, số tiền, người nhận. Đây là nền cho phát hiện gian lận, thường kết hợp cả quy tắc cứng và mô hình.
- Nhà máy: theo dõi rung, dòng điện, nhiệt độ động cơ. Khi mẫu rung lệch khỏi đường cơ sở của chính máy đó, đội bảo trì kiểm tra trước khi hỏng, thay vì sửa sau sự cố.
- Vận hành CNTT: bắt đợt tăng đột biến lỗi 5xx của API, thời gian phản hồi tăng dần sau một lần triển khai, hay tài khoản quản trị đăng nhập từ vị trí chưa từng thấy. Giám sát bằng ngưỡng cố định hay bị sai vì lưu lượng thay đổi theo giờ.
- Kế toán, kiểm soát nội bộ: tìm hoá đơn trùng, số tiền tròn bất thường, hoặc nhà cung cấp có nhiều khoản chi ngay dưới hạn mức duyệt.
- Bán lẻ và thương mại điện tử: phát hiện tồn kho âm, đơn hoàn tăng vọt ở một cửa hàng, hay chỉ số bán hàng lệch sau lỗi đồng bộ dữ liệu. Bối cảnh rộng hơn nằm trong bài AI trong bán lẻ.
- Camera giám sát: bắt hành vi hoặc cảnh khác thường so với nền thông thường, như vật bỏ quên hay người đi ngược luồng. Phần nhận diện đối tượng thuộc về camera AI.
Nếu dữ liệu hành vi gắn với nhân viên hoặc khách hàng cụ thể (lịch sử đăng nhập, vị trí, giao dịch), đó là dữ liệu cá nhân. Luật Bảo vệ dữ liệu cá nhân yêu cầu bạn xác định mục đích xử lý và căn cứ hợp pháp cho các trường như lịch sử đăng nhập, vị trí và giao dịch trước khi đưa chúng vào hệ thống giám sát hành vi.
Vì sao cảnh báo sai là vấn đề lớn nhất?
Bất thường là sự kiện hiếm, nên ngay cả mô hình có tỷ lệ báo sai thấp vẫn tạo ra rất nhiều cảnh báo sai. Hãy xem phép tính sau, đây là ví dụ minh hoạ với số giả định.
| Giả định | Giá trị |
|---|---|
| Số giao dịch mỗi ngày | 100.000 |
| Tỷ lệ giao dịch thật sự đáng ngờ | 0,1% (100 giao dịch) |
| Mô hình bắt được | 100 trên 100 |
| Tỷ lệ báo sai trên giao dịch bình thường | 1% |
| Số cảnh báo sai mỗi ngày | khoảng 999 |
| Độ chính xác của cảnh báo (precision) | khoảng 9% |
Dù bắt đủ 100 trường hợp, gần 91% cảnh báo vẫn là sai. Nếu đội kiểm tra chỉ xử lý được 200 cảnh báo mỗi ngày, bạn phải chọn xếp hạng theo điểm và chỉ chuyển phần đầu danh sách cho người. Vì vậy, khi đánh giá nên nhìn precision, recall (tỷ lệ bắt được trong số thật sự bất thường) và số cảnh báo mỗi ngày mà đội xử lý nổi. Độ chính xác tổng thể (accuracy) gần như vô nghĩa ở đây: một hệ thống không báo gì cả vẫn đúng 99,9% trong ví dụ trên.
Những lỗi thường gặp khi triển khai
- Huấn luyện trên dữ liệu đã lẫn bất thường. Mô hình sẽ coi sự cố cũ là “bình thường”. Hãy loại các giai đoạn sự cố đã biết trước khi học.
- Bỏ qua trôi dữ liệu (data drift). Sau đợt khuyến mãi, mở chi nhánh hay đổi hệ thống, “bình thường” đã khác. Mô hình cũ sẽ báo hàng loạt hoặc im lặng. Cần lịch huấn luyện lại và theo dõi tỷ lệ cảnh báo theo tuần.
- Đặt contamination theo cảm tính. Với Isolation Forest, con số này ép tỷ lệ bị gắn cờ trên dữ liệu huấn luyện. Nên bắt đầu từ “auto” rồi chỉnh theo năng lực xử lý của đội.
- Đặc trưng thiếu ngữ cảnh. Số tiền thô ít có ích hơn tỷ lệ so với mức chi trung bình của chính khách hàng đó. Việc thiết kế đặc trưng quan trọng hơn chọn thuật toán, xem thêm kỹ thuật tạo đặc trưng.
- Không có cách giải thích. Nhân viên không tin cảnh báo kiểu “điểm 0,87” nếu không biết đặc trưng nào góp phần. Các kỹ thuật trong AI giải thích được giúp chỉ ra yếu tố chính của từng cảnh báo.
- Thiếu vòng phản hồi. Nếu kết luận của người kiểm tra không quay lại thành nhãn, mô hình mãi ở mức không giám sát dù bạn đã tích lũy nhiều dữ liệu có đáp án.
Ưu điểm và hạn chế
| Tiêu chí | Ưu điểm | Hạn chế |
|---|---|---|
| Dữ liệu nhãn | Nhiều phương pháp không cần nhãn | Khó chấm điểm mô hình khi không có đáp án |
| Phạm vi phát hiện | Bắt được kiểu lạ chưa từng gặp | Cũng báo cả thay đổi vô hại |
| Quy mô | Giám sát liên tục hàng triệu bản ghi | Cảnh báo sai nhiều khi sự kiện hiếm |
| Giải thích | Thống kê, quy tắc dễ giải thích | Autoencoder khó giải thích với người dùng nghiệp vụ |
| Bảo trì | Cập nhật bằng phản hồi của người kiểm tra | Phải huấn luyện lại khi hành vi bình thường đổi |
So sánh với các khái niệm gần
- Outlier detection: thường dùng trong thống kê và làm sạch dữ liệu, coi ngoại lai là thứ cần loại hoặc xem xét. Anomaly detection thiên về giám sát, nơi điểm lạ chính là thứ bạn muốn bắt.
- Phân loại gian lận có giám sát: cần nhãn và nhận ra kiểu đã biết. Anomaly detection không cần nhãn nhưng cho nhiều cảnh báo hơn.
- Giảm chiều dữ liệu: kỹ thuật như PCA có thể dùng làm bước tiền xử lý, hoặc dùng sai số dựng lại để chấm điểm bất thường.
- Cảnh báo ngưỡng cố định: một dạng đơn giản nhất của phát hiện bất thường, không học từ dữ liệu và không thích nghi theo giờ hay mùa.
Khi nào nên và không nên dùng?
Phù hợp khi sự kiện đáng quan tâm hiếm, dạng của nó thay đổi liên tục (như thủ đoạn gian lận mới), có dòng dữ liệu đều đặn để học đường cơ sở, và có người đủ nghiệp vụ để kiểm tra cảnh báo hằng ngày.
Chưa phù hợp khi dữ liệu quá ít hoặc quá lộn xộn để định nghĩa “bình thường”, khi hành vi vốn thay đổi thất thường (cửa hàng mới mở vài tuần), hoặc khi một quy tắc đơn giản như “không chi quá hạn mức này” đã đủ. Cũng cần thận trọng nếu kết quả dẫn tới quyết định bất lợi cho cá nhân như khoá tài khoản hay kỷ luật. Trường hợp đó nên có người duyệt cuối và đối chiếu với quy định về hệ thống AI rủi ro cao trong Luật Trí tuệ nhân tạo 2025.
Câu hỏi thường gặp
Anomaly detection là gì, nói ngắn gọn?
Là kỹ thuật tìm dữ liệu hoặc sự kiện lệch khỏi quy luật thông thường, rồi cảnh báo để người kiểm tra. Nó có thể dùng thống kê, quy tắc hoặc học máy.
Anomaly detection có phải là machine learning không?
Không hoàn toàn. Ngưỡng thống kê và quy tắc cũng là phát hiện bất thường mà không cần học máy. Khi dùng mô hình như Isolation Forest hoặc autoencoder thì nó thuộc machine learning, thường là học không giám sát hoặc bán giám sát.
Anomaly detection khác outlier detection thế nào?
Hai khái niệm chồng lấn nhiều. Outlier thường nói đến giá trị ngoại lai trong phân tích thống kê. Anomaly nhấn vào sự kiện đáng chú ý trong vận hành như gian lận, sự cố, xâm nhập.
Cần bao nhiêu dữ liệu để bắt đầu?
Không có con số cố định. Điều kiện cần là dữ liệu lịch sử đủ dài để bao phủ các chu kỳ bình thường, ví dụ cả ngày thường, cuối tuần và đợt cao điểm. Nếu chu kỳ quan trọng của bạn theo năm, dữ liệu vài tuần sẽ không đủ.
Làm sao biết mô hình bắt đúng khi không có nhãn?
Bạn nhờ chuyên gia nghiệp vụ xem lại một mẫu cảnh báo, ghi lại cái nào thật sự đáng xử lý, và tính tỷ lệ đúng trong top cảnh báo. Đồng thời có thể cài vài sự cố đã biết từ quá khứ để kiểm tra mô hình có bắt lại được không.
Phát hiện bất thường có dùng cho nhận diện sinh trắc học không?
Có, theo hai hướng: bắt dấu hiệu giả mạo hoặc hành vi truy cập khác thường. Nội dung về loại sinh trắc và quy định nằm ở bài sinh trắc học.