
Trả lời nhanh: Underfitting (thiếu khớp) là tình trạng mô hình học máy quá đơn giản hoặc chưa được huấn luyện đủ, nên không nắm được quy luật trong dữ liệu. Dấu hiệu rõ nhất là sai số cao ngay trên tập huấn luyện, và cũng cao trên tập kiểm định. Nguyên nhân gốc là độ chệch (bias) cao.
Điểm chính
- Underfitting lộ ra ngay trên tập huấn luyện, nên thường dễ phát hiện hơn overfitting.
- Học đường cong (learning curve) cho thấy hai đường sai số đều cao và nằm sát nhau.
- Thêm dữ liệu thường không cứu được mô hình thiếu khớp. Cần tăng năng lực mô hình, cải thiện đặc trưng hoặc giảm regularization.
- Sửa quá tay sẽ đẩy mô hình sang overfitting, nên phải đo lại trên tập kiểm định sau mỗi thay đổi.
Mục lục
- Underfitting là gì?
- Làm sao nhận biết mô hình bị underfitting?
- Nguyên nhân khiến mô hình bị underfitting
- Ví dụ minh hoạ: dự báo doanh số theo tuần
- Underfitting và bias-variance tradeoff
- Underfitting khác overfitting thế nào?
- Cách khắc phục underfitting theo thứ tự nên thử
- Thêm dữ liệu có chữa được underfitting không?
- Lỗi thường gặp khi chẩn đoán underfitting
- Khi nào underfitting chấp nhận được?
- Câu hỏi thường gặp
Underfitting là gì?
Underfitting, tiếng Việt hay gọi là thiếu khớp hoặc chưa khớp, là hiện tượng mô hình không học được mối quan hệ giữa đầu vào và đầu ra. Theo IBM, mô hình thiếu khớp cho tỷ lệ lỗi cao trên cả tập huấn luyện lẫn dữ liệu chưa từng thấy. Nói cách khác, mô hình sai ngay cả với những ví dụ mà nó đã được học.
Hãy so sánh với một nhân viên kế toán chỉ có một công thức cố định để ước tính chi phí cho mọi khách hàng. Công thức đó sai với khách hàng cũ, và cũng sai với khách hàng mới. Lỗi không nằm ở việc “chưa gặp trường hợp lạ”. Công thức vốn không đủ khả năng mô tả thực tế.
Underfitting là một trường hợp lỗi trong quá trình huấn luyện của machine learning. Mục tiêu của huấn luyện là tìm ra mô hình tổng quát hoá tốt, tức là đúng với dữ liệu mới. Mô hình thiếu khớp thất bại ngay từ bước đầu, vì nó chưa nắm được xu hướng chính của dữ liệu.
Hai cách gọi cùng một hiện tượng: high bias và thiếu khớp
Trong thống kê, người ta mô tả underfitting bằng thuật ngữ độ chệch cao (high bias) và phương sai thấp (low variance). Bias đo mức dự đoán của mô hình lệch khỏi giá trị thật. Theo IBM, mô hình bias cao đưa ra giả định quá chặt về dạng của dữ liệu và gây ra underfitting. Ví dụ điển hình là giả định mọi quan hệ đều là đường thẳng trong khi dữ liệu thực tế cong.
Phương sai thấp nghĩa là mô hình ổn định. Nếu bạn huấn luyện lại trên một mẫu dữ liệu khác, kết quả gần như không đổi. Nhưng đó là sự ổn định của một mô hình luôn sai theo cùng một hướng. Một nguồn mô tả chuẩn xác điều này: dự đoán nhất quán nhưng không chính xác.
Làm sao nhận biết mô hình bị underfitting?
Bạn chỉ cần hai con số: sai số trên tập huấn luyện và sai số trên tập kiểm định (validation). Chọn cùng một thước đo cho cả hai, ví dụ MAE hoặc RMSE với bài toán dự báo số, accuracy hoặc F1 với bài toán phân loại.
- Cả hai đều xấu: mô hình đang underfitting. Một hướng dẫn thực hành nêu rõ: nếu cả hai sai số đều cao thì mô hình bias cao và đang underfitting.
- Huấn luyện tốt, kiểm định kém: đây là overfitting, bài toán khác hẳn.
- Cả hai đều tốt và sát nhau: mô hình đang ở vùng cân bằng.
Điểm dễ vướng là “cao” so với cái gì? Sai số tuyệt đối không tự nói lên điều gì. Bạn cần một mốc tham chiếu như mức sai số chấp nhận được theo yêu cầu nghiệp vụ, kết quả của mô hình baseline đơn giản (ví dụ luôn dự báo bằng giá trị trung bình), hoặc mức sai số của người làm thủ công. Nếu mô hình của bạn không vượt được baseline “lấy trung bình”, gần như chắc chắn nó chưa học được gì.
Đọc learning curve để phân biệt
Learning curve là đồ thị sai số theo số mẫu huấn luyện. Với underfitting, sai số huấn luyện cao, sai số kiểm định cũng cao và rất sát sai số huấn luyện. Khi tăng số mẫu, cả hai đường chững lại ở mức cao thay vì tiếp tục đi xuống.
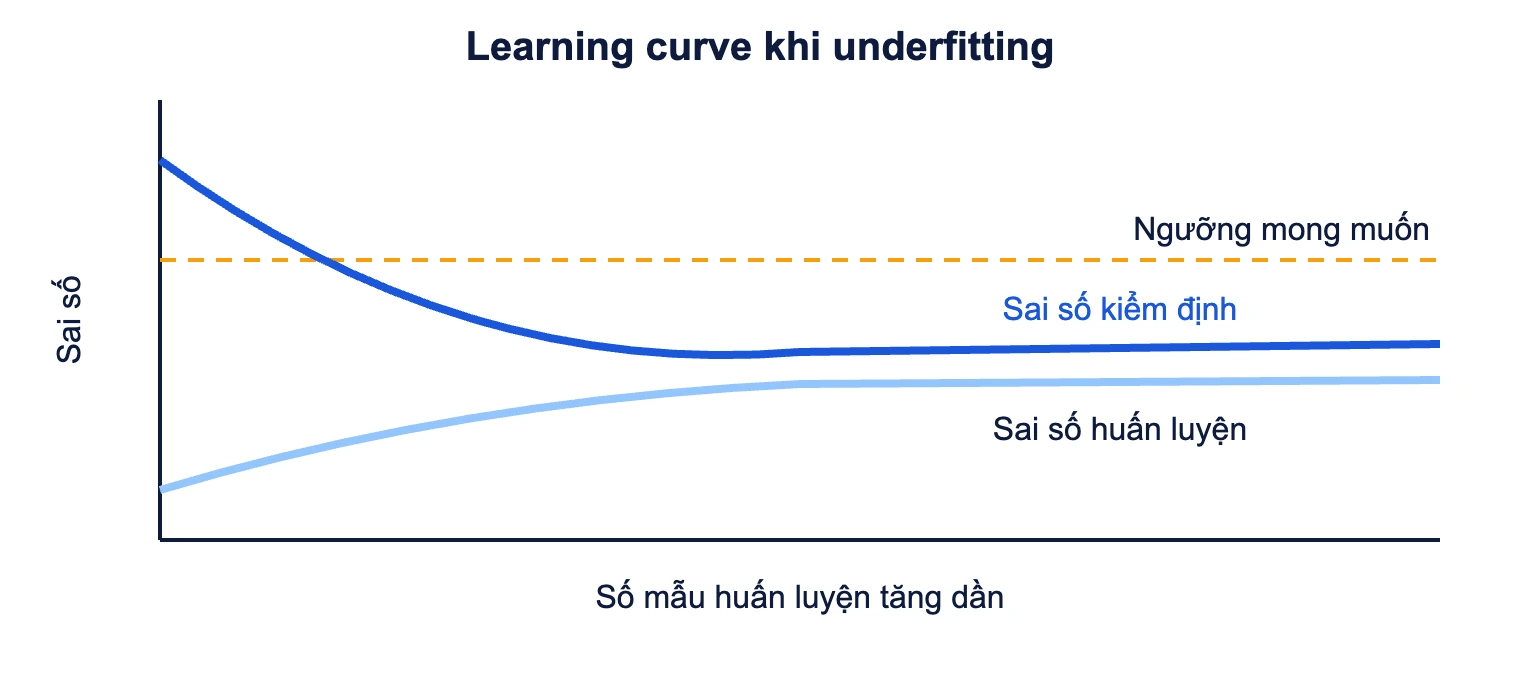
Đây cũng là khác biệt quan trọng với overfitting. Ở overfitting, khoảng cách giữa hai đường là dấu hiệu chính. Ở underfitting, khoảng cách nhỏ, nhưng cả hai đều nằm quá cao.
Nguyên nhân khiến mô hình bị underfitting
Theo IBM, underfitting xảy ra khi mô hình quá đơn giản, do cần thêm thời gian huấn luyện, thêm đặc trưng đầu vào hoặc giảm regularization. Trong thực tế, bạn có thể gặp năm nhóm nguyên nhân.
- Mô hình thiếu năng lực. Dùng hồi quy tuyến tính cho dữ liệu phi tuyến, cây quyết định cắt nông chỉ một hai tầng, hoặc mạng nơ-ron có quá ít tầng ẩn và quá ít nơ-ron.
- Thiếu đặc trưng quan trọng. Mô hình dự báo doanh thu không có biến ngày lễ, khuyến mãi hay mùa vụ thì không thể học được các đỉnh doanh thu. Phần này liên quan trực tiếp đến feature engineering.
- Huấn luyện chưa đủ. Số epoch quá ít, hoặc dừng sớm (early stopping) quá tay. IBM cũng lưu ý rằng underfitting thường xuất hiện khi người làm cố tránh overfitting bằng early stopping.
- Regularization quá mạnh. Regularization thêm một đại lượng phạt vào hàm mất mát (loss). Nếu hệ số lambda quá lớn, phần phạt lấn át phần học, và mô hình xây dựng sẽ bị sai, tức underfitting.
- Siêu tham số đặt chưa hợp lý. Tốc độ học quá thấp hoặc tối ưu hoá chưa hội tụ khiến mô hình đứng ở vùng sai số cao. Các lựa chọn này nằm trong nhóm hyperparameter.
Ngoài ra, dữ liệu nhiễu nặng hoặc nhãn sai nhiều cũng làm sai số huấn luyện cao. Trường hợp này trông giống underfitting nhưng nguyên nhân nằm ở dữ liệu, không phải ở mô hình. Phần “Lỗi chẩn đoán” bên dưới sẽ nói cách tách hai trường hợp.
Ví dụ minh hoạ: dự báo doanh số theo tuần
Ví dụ minh hoạ, số liệu giả định. Một chuỗi cửa hàng muốn dự báo số đơn mỗi tuần. Nhóm dữ liệu dựng mô hình hồi quy tuyến tính chỉ với một biến: số tuần tính từ đầu năm. Doanh số thực tế có đỉnh dịp Tết, giảm sau Tết và tăng khi có khuyến mãi lớn.
- Mô hình vẽ ra một đường thẳng nghiêng nhẹ, nằm xuyên qua các đỉnh và đáy.
- Giả sử sai số trung bình (MAE) trên tập huấn luyện là 18% và trên tập kiểm định là 19%. Hai số gần nhau, cùng cao, và baseline “lấy trung bình 4 tuần gần nhất” đạt 15%. Mô hình tệ hơn cả cách làm đơn giản.
- Thêm biến “cách Tết bao nhiêu tuần”, cờ khuyến mãi và số đơn của tuần trước. Cả hai sai số cùng giảm. Nếu chuyển sang mô hình cây tăng cường (gradient boosting) mà vẫn không thêm biến, mức giảm sẽ ít hơn.
Bài học nằm ở thứ tự: lỗi này không được giải quyết bằng việc thu thập thêm hàng nghìn tuần dữ liệu, mà bằng cách cho mô hình “nhìn thấy” các yếu tố mà doanh số phụ thuộc vào.
Underfitting và bias-variance tradeoff
Underfitting là một đầu của đường cân bằng bias-variance. Theo IBM, mô hình bias cao dễ underfitting vì bỏ lỡ các mẫu quan trọng, còn mô hình phương sai cao dễ overfitting vì coi nhiễu như tín hiệu. Khi độ phức tạp mô hình tăng, bias giảm còn phương sai tăng. Điểm tổng sai số thấp nhất nằm ở giữa.
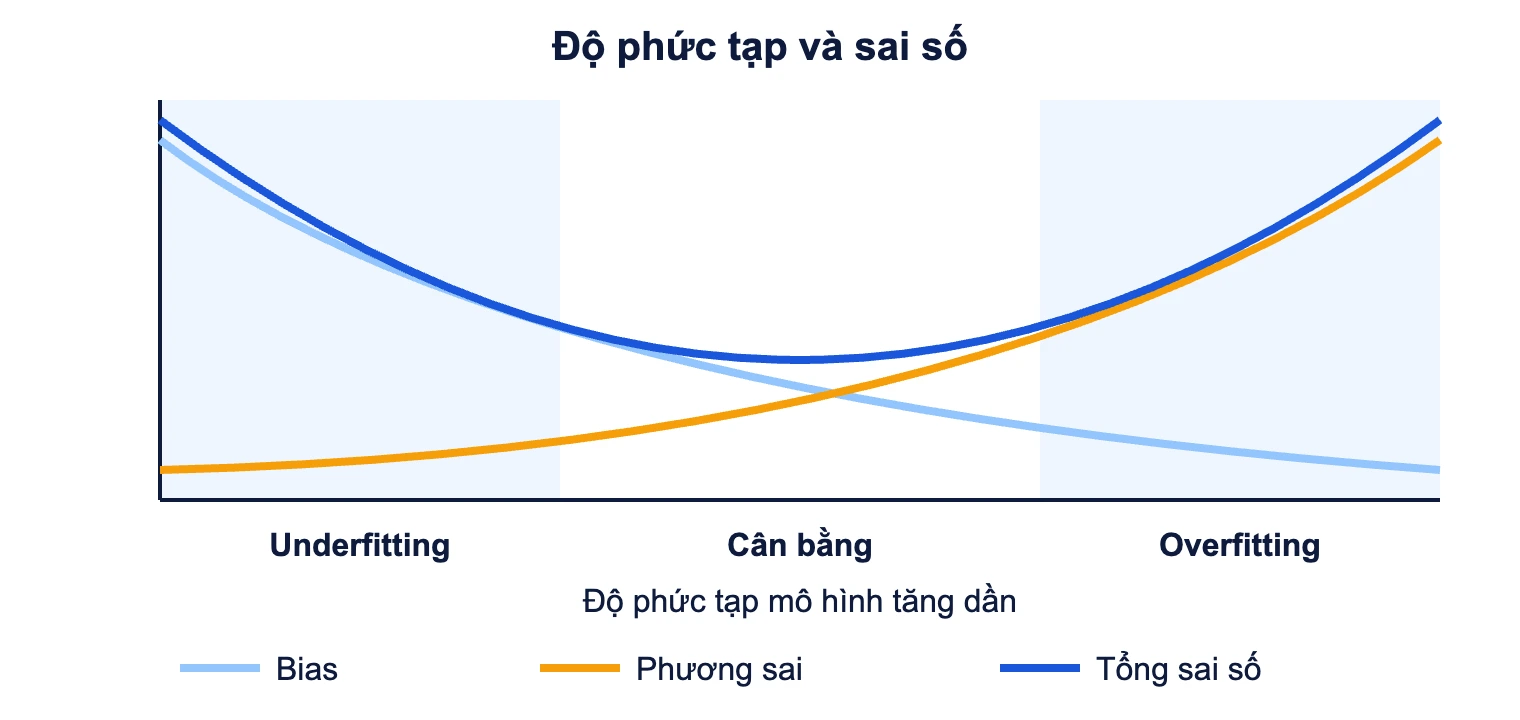
Vì vậy “mô hình đơn giản” không xấu theo bản chất. Nó chỉ xấu khi đơn giản hơn cấu trúc thật của bài toán. Đây cũng là chỗ để phân biệt với overfitting, mặt đối lập của hiện tượng này.
Underfitting khác overfitting thế nào?
| Tiêu chí | Underfitting | Overfitting |
|---|---|---|
| Sai số huấn luyện | Cao | Thấp |
| Sai số kiểm định | Cao, sát sai số huấn luyện | Cao hơn nhiều so với huấn luyện |
| Bias / phương sai | Bias cao, phương sai thấp | Bias thấp, phương sai cao |
| Mô hình điển hình | Quá đơn giản, quá ít đặc trưng | Quá phức tạp so với lượng dữ liệu |
| Thêm dữ liệu | Ít cải thiện | Thường thu hẹp khoảng cách |
| Tăng độ phức tạp | Thường giúp ích | Làm tệ thêm |
| Tăng regularization | Làm tệ thêm | Thường giúp ích |
| Cách phát hiện | Chỉ cần nhìn tập huấn luyện | Phải có tập kiểm định hoặc kiểm tra chéo |
Hai dòng cuối cho thấy một cái bẫy: thuốc chữa overfitting lại là nguyên nhân của underfitting. Nếu bạn áp dụng cả bộ biện pháp chống overfitting (dropout, regularization mạnh, dừng sớm, cắt tỉa cây) trước khi kiểm tra sai số huấn luyện, bạn có thể tự tạo ra underfitting.
Cách khắc phục underfitting theo thứ tự nên thử
Nên thử từ biện pháp rẻ và ít rủi ro đến biện pháp tốn kém. Sau mỗi thay đổi, bạn ghi lại cả sai số huấn luyện và kiểm định. Nếu chỉ nhìn một con số, bạn không biết mình đã chuyển sang overfitting hay chưa.
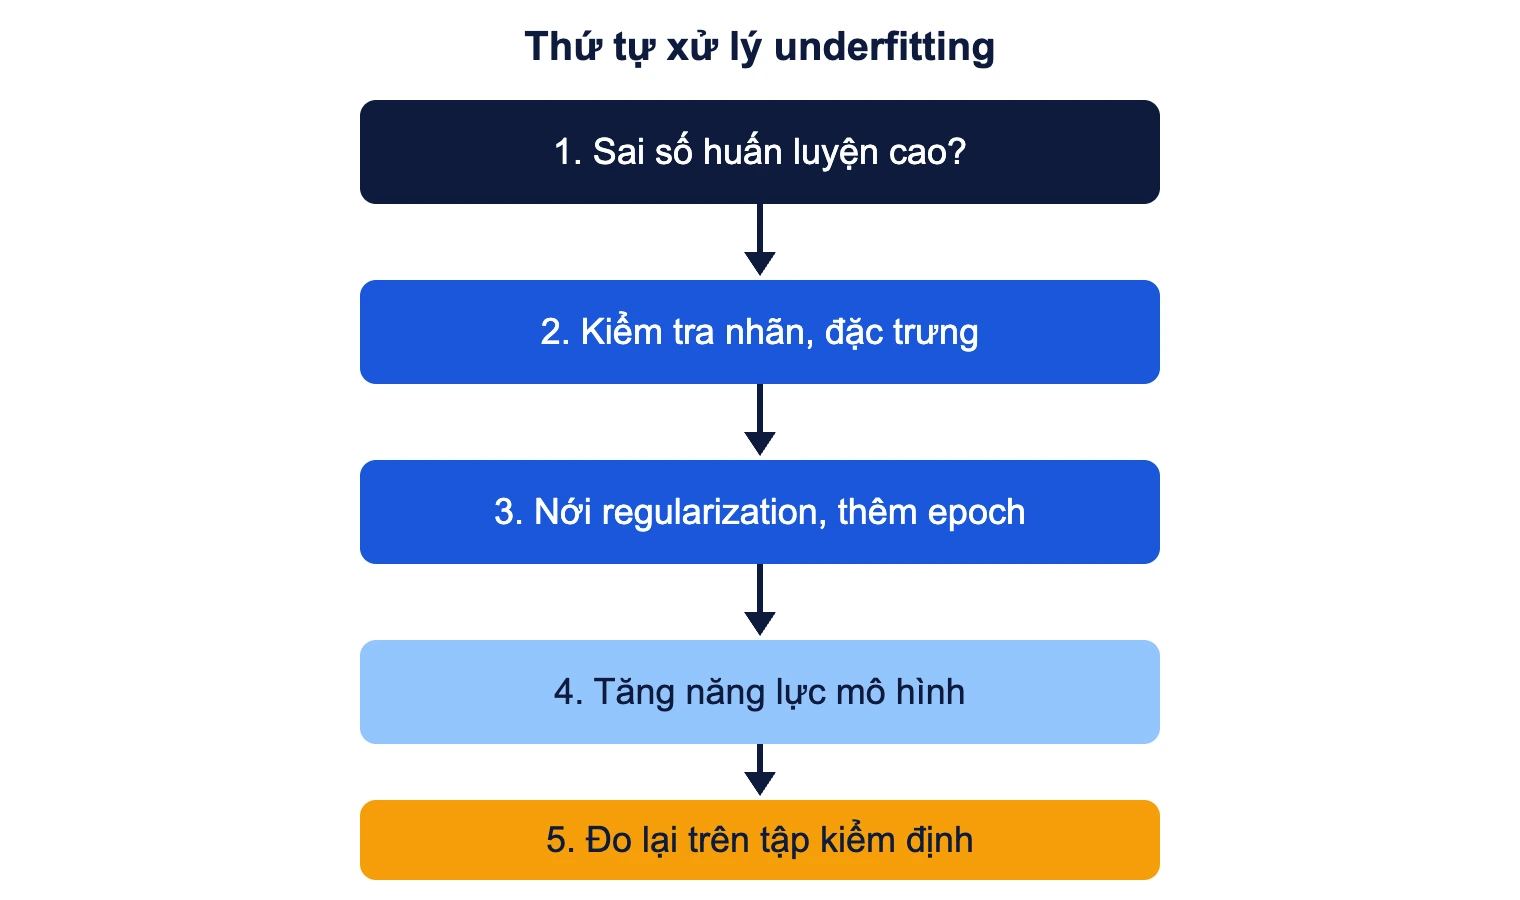
Bước 1: Xác nhận lỗi nằm ở mô hình, không phải ở dữ liệu
Lấy ngẫu nhiên vài chục mẫu mà mô hình dự đoán sai nhiều nhất trên tập huấn luyện và đọc bằng mắt. Nếu nhãn mâu thuẫn nhau (cùng một đầu vào nhưng hai nhãn khác nhau), mô hình nào cũng không giảm được sai số. Sửa nhãn trước khi đổi mô hình.
Bước 2: Bổ sung và biến đổi đặc trưng
Đây thường là biện pháp có hiệu quả cao nhất với dữ liệu dạng bảng. Thêm đặc trưng tương tác (ví dụ giá nhân với cờ khuyến mãi), đặc trưng thời gian (thứ trong tuần, cách ngày lễ), hoặc sinh các số hạng đa thức. Với hồi quy, đưa từ bậc 1 lên bậc 2 là cách đơn giản nhất để mô hình bắt được đường cong.
Bước 3: Giảm regularization, kéo dài huấn luyện
Giảm hệ số lambda của L1 hoặc L2, giảm tỷ lệ dropout, tăng số epoch hoặc nới điều kiện dừng sớm. Hãy quan sát đường loss huấn luyện. Nếu đường này vẫn đang đi xuống khi bạn dừng, mô hình chưa hội tụ. Cách tối ưu hoá này gắn với gradient descent, nơi tốc độ học và số vòng lặp quyết định mô hình có kịp đến vùng sai số thấp hay không.
Bước 4: Tăng năng lực mô hình
Chuyển từ hồi quy tuyến tính sang cây quyết định sâu hơn, rừng ngẫu nhiên hoặc gradient boosting. Với mạng nơ-ron, thêm tầng ẩn hoặc tăng số nơ-ron mỗi tầng. Đây là bước cuối vì mô hình lớn hơn tốn nhiều tài nguyên hơn và dễ chuyển sang overfitting hơn.
Bước 5: Đo lại, và dừng đúng lúc
Bạn dừng khi sai số huấn luyện đã gần mức mong muốn và khoảng cách với sai số kiểm định chưa nở rộng. Nếu khoảng cách bắt đầu mở rộng, bạn đã đi quá xa và cần quay lại với regularization hoặc kiểm tra chéo (cross-validation).
Bảng tra nhanh: dấu hiệu và hướng xử lý
| Quan sát | Nguyên nhân có thể | Hướng xử lý |
|---|---|---|
| Dự đoán luôn gần một giá trị trung bình | Mô hình quá đơn giản hoặc thiếu đặc trưng | Thêm đặc trưng, đổi mô hình |
| Loss huấn luyện vẫn giảm khi dừng | Số epoch ít, tốc độ học thấp | Huấn luyện thêm, chỉnh tốc độ học |
| Sai số giảm mạnh khi tắt regularization | Lambda hoặc dropout quá lớn | Giảm dần, đo lại từng mức |
| Cùng đầu vào, nhãn khác nhau | Nhãn nhiễu hoặc định nghĩa không thống nhất | Làm sạch và thống nhất nhãn |
| Hai đường learning curve chập nhau ở mức cao | Bias cao về cấu trúc | Tăng độ phức tạp mô hình |
Thêm dữ liệu có chữa được underfitting không?
Thường là không, và đây là nhầm lẫn phổ biến khi người làm gặp mô hình kém. Một nguồn thống kê giải thích: thêm dữ liệu huấn luyện không giúp nhiều vì nút thắt nằm ở cấu trúc mô hình, không ở kích thước mẫu. Một đường thẳng vẫn là đường thẳng dù bạn có một triệu điểm cong.
Có ngoại lệ. Nếu dữ liệu hiện có quá ít hoặc thiếu các nhóm quan trọng, mô hình có thể không học được quy luật của nhóm đó. Khi đó bạn thu thêm dữ liệu cho nhóm bị thiếu, không phải thêm đại trà. Tập huấn luyện của bài toán học có giám sát chỉ có ích nếu nhãn phản ánh đúng thứ bạn muốn dự đoán.
Lỗi thường gặp khi chẩn đoán underfitting
- Chỉ nhìn một chỉ số trên tập kiểm định. Bạn không thể phân biệt underfitting và overfitting nếu không có sai số huấn luyện đi kèm.
- Dùng độ chính xác trên dữ liệu mất cân bằng. Giả sử 95% giao dịch là hợp lệ, mô hình luôn trả lời “hợp lệ” đạt 95% accuracy nhưng không học được gì về phần còn lại. Hãy xem thêm recall, precision hoặc F1 của lớp hiếm.
- Quên chuẩn hoá dữ liệu. Với các mô hình dùng khoảng cách hoặc gradient, thang đo lệch nhau khiến huấn luyện chậm, nhìn giống chưa khớp.
- Cắt sớm theo thói quen. Dừng sớm cài sẵn trong thư viện có thể kết thúc huấn luyện trước khi loss ổn định, nhất là khi loss kiểm định dao động.
- Nhầm giới hạn của dữ liệu với underfitting. Một phần sai số đến từ nhiễu không thể loại bỏ (irreducible noise). Nếu hai mô hình rất khác nhau đều dừng ở cùng một sai số, có thể bạn đã chạm trần của dữ liệu.
Một phép thử nhanh: cho mô hình học một tập con rất nhỏ, khoảng vài chục mẫu. Nếu mô hình không thể ghi nhớ nổi tập nhỏ đó (sai số huấn luyện vẫn cao), nghĩa là có lỗi về năng lực mô hình, tốc độ học hoặc nhãn. Với mô hình đủ mạnh, sai số trên tập nhỏ phải tiến gần 0.
Khi nào underfitting chấp nhận được?
Không phải mô hình đơn giản nào cũng là lỗi. Nếu một mô hình tuyến tính đạt sai số nằm trong ngưỡng nghiệp vụ, nó có thể là lựa chọn tốt. Nó huấn luyện nhanh, chạy nhẹ và dễ giải thích hệ số từng biến cho người dùng. Yêu cầu giải thích kết quả thường xuất hiện trong chấm điểm tín dụng hoặc đánh giá rủi ro, nơi nhóm vận hành phải trả lời được “vì sao” với khách hàng. Phần này gần với chủ đề AI có thể giải thích.
Câu hỏi đúng không phải “mô hình có đơn giản không”, mà là “sai số có nằm trong ngưỡng mà nghiệp vụ chấp nhận không”. Nếu có, giữ mô hình đơn giản. Nếu không, mới cần tăng độ phức tạp, và chỉ tăng đến mức đạt ngưỡng.
Câu hỏi thường gặp
Underfitting có nghĩa là mô hình chưa học xong?
Có thể, nhưng không phải lúc nào cũng vậy. Nếu loss huấn luyện vẫn đang giảm khi dừng thì mô hình chưa học xong, và huấn luyện thêm sẽ giúp. Nếu loss đã phẳng ở mức cao thì vấn đề là năng lực mô hình hoặc đặc trưng, và huấn luyện thêm sẽ không đổi được gì.
Làm sao biết đang underfitting hay overfitting?
So sánh sai số huấn luyện với sai số kiểm định bằng cùng một thước đo. Cả hai cùng cao thì là underfitting. Huấn luyện thấp mà kiểm định cao thì là overfitting. Vẽ learning curve giúp bạn thấy xu hướng khi số mẫu tăng, thay vì chỉ so hai con số tại một thời điểm.
Mô hình deep learning có bị underfitting không?
Có. Mạng quá nhỏ, tốc độ học không phù hợp, khởi tạo trọng số hoặc chuẩn hoá dữ liệu sai, hay dropout và weight decay quá mạnh đều dẫn đến sai số huấn luyện cao. Bạn xem thêm cách các tầng học đặc trưng trong bài về deep learning.
Underfitting và high bias là một không?
Gần như vậy. High bias là nguyên nhân thống kê, còn underfitting là hiện tượng quan sát được: sai số cao trên cả hai tập. Nhiều tài liệu dùng hai thuật ngữ thay thế cho nhau, vì mô hình bias cao thường cho kết quả thiếu khớp.
Có nên cố đưa sai số huấn luyện về 0 không?
Không. Sai số huấn luyện bằng 0 thường là dấu hiệu mô hình đã ghi nhớ cả nhiễu. Mục tiêu là sai số huấn luyện đủ thấp để đạt yêu cầu nghiệp vụ và khoảng cách với sai số kiểm định đủ nhỏ để kết quả giữ được trên dữ liệu mới.
Underfitting có xảy ra với mô hình ngôn ngữ lớn không?
Có thể xảy ra khi mô hình được huấn luyện quá ít so với kích thước hoặc quá sớm so với lịch học, tức là loss vẫn còn giảm mạnh khi dừng. Khái niệm này vẫn là sai số cao trên dữ liệu huấn luyện, chỉ khác ở quy mô và chi phí để kiểm tra.