
Trả lời nhanh: NLG (Natural Language Generation, sinh ngôn ngữ tự nhiên) là nhánh của AI giúp máy tạo ra văn bản hoặc lời nói mà người đọc hiểu được từ dữ liệu đầu vào, như bảng số, kết quả phân tích hay một câu hỏi. NLG có thể chạy bằng mẫu câu, quy tắc ngữ pháp hoặc mô hình thần kinh.
Điểm chính
- NLG lo phần “nói ra”, còn NLU lo phần “hiểu vào”. Cả hai là hai nửa của xử lý ngôn ngữ tự nhiên.
- Một hệ NLG cổ điển đi qua ba việc: chọn nội dung, lập câu, hoàn thiện câu chữ. Mô hình transformer hiện đại làm gộp các việc này.
- Có ba cách làm chính: mẫu điền chỗ trống, quy tắc ngữ pháp và mô hình thần kinh. Mỗi cách đánh đổi giữa độ chắc chắn và độ tự nhiên.
- Rủi ro lớn nhất của NLG thần kinh là “ảo giác” (hallucination): câu văn trôi chảy nhưng sai dữ kiện.
Mục lục
- NLG là gì và nó nằm ở đâu trong AI?
- NLG khác NLU và NLP ở điểm nào?
- NLG hoạt động qua những giai đoạn nào?
- Ba cách làm NLG: mẫu, quy tắc và mô hình thần kinh
- Ví dụ NLG trong thực tế: từ dữ liệu đến câu chữ
- Khi nào chọn cách nào? Ma trận quyết định
- Rủi ro và hạn chế khi dùng NLG
- NLG có lợi và hạn chế gì cho doanh nghiệp Việt?
- NLG khác gì với AI tạo sinh (generative AI)?
- Khi nào nên và không nên dùng NLG?
- Câu hỏi thường gặp
NLG là gì và nó nằm ở đâu trong AI?
NLG là quá trình phần mềm tạo ra đầu ra bằng ngôn ngữ tự nhiên. Một bản khảo sát NLG được trích dẫn rộng rãi định nghĩa đây là lĩnh vực con của AI và ngôn ngữ học tính toán, lo việc xây dựng hệ thống sinh ra văn bản dễ hiểu từ một biểu diễn thông tin không phải ngôn ngữ. Nói đơn giản: đầu vào là con số, bản ghi hoặc sự kiện, đầu ra là câu chữ mà người đọc không cần biết đọc bảng.
Các nguồn không hoàn toàn thống nhất về ranh giới. Có định nghĩa chỉ tính khi đầu vào là dữ liệu phi ngôn ngữ. Có định nghĩa rộng hơn, tính cả tóm tắt, dịch, diễn đạt lại và trả lời câu hỏi. Khi bạn đọc tài liệu, hãy xem tác giả dùng nghĩa hẹp hay nghĩa rộng để khỏi hiểu lệch.
Về vị trí, NLG là một nửa của xử lý ngôn ngữ tự nhiên. Nửa còn lại là NLU, tức khả năng hiểu văn bản hoặc lời nói của người dùng. Nếu cần nền tảng rộng hơn về lĩnh vực này, bạn có thể đọc bài AI là gì trước.
NLG khác NLU và NLP ở điểm nào?
NLU đi từ văn bản sang ý nghĩa: phân tích hình thái, cú pháp, ngữ nghĩa, ngữ cảnh. Theo bản khảo sát NLG trên arXiv, quá trình sinh có tính chất khác hẳn: nó đi từ ý định và nội dung sang các từ được xếp theo thứ tự tuyến tính. Một bên “giải mã”, một bên “mã hoá” ý nghĩa thành chữ.
| Tiêu chí | NLU | NLG | NLP |
|---|---|---|---|
| Hướng xử lý | Từ chữ sang ý nghĩa | Từ dữ liệu hoặc ý định sang chữ | Bao gồm cả hai |
| Đầu ra điển hình | Ý định, thực thể, nhãn cảm xúc | Câu, đoạn, báo cáo, lời nói | Tuỳ nhiệm vụ |
| Lỗi hay gặp | Hiểu sai ý hoặc bỏ sót thực thể | Sai dữ kiện, lặp, giọng văn lệch | Tuỳ nhiệm vụ |
| Ví dụ trong tổng đài | Nhận ra khách hỏi về cước tháng | Soạn câu trả lời nêu đúng số tiền | Cả cuộc hội thoại |
Một số tác vụ nằm giữa hai nửa. Dịch máy vừa phải hiểu câu nguồn vừa phải sinh câu đích, nên các tài liệu hay xếp nó vào nhóm sinh văn bản theo nghĩa rộng.
NLG hoạt động qua những giai đoạn nào?
Mô hình sách giáo khoa chia NLG thành ba việc lớn. Nhiều tài liệu chia chi tiết hơn thành năm bước, thêm lập cấu trúc tài liệu và chọn từ vựng, nhưng bản chất vẫn là đi từ “nói gì” tới “nói thế nào”.
- Chọn nội dung (content determination). Hệ thống quyết định đưa thông tin nào vào bài. Một bản ghi có hàng chục trường, không phải trường nào cũng đáng nhắc. Một bộ tạo bản tin thể thao phải chọn pha bóng và chỉ số đáng kể, bỏ phần còn lại.
- Lập câu (sentence planning, hay microplanning). Gồm gộp nhiều dữ kiện vào một câu (aggregation), chọn cách gọi lại thực thể như “công ty”, “nó” hay tên riêng (referring expression), và chọn từ.
- Hoàn thiện câu chữ (surface realization). Biến kế hoạch câu thành câu đúng ngữ pháp: chia dạng từ, hoà hợp, sắp xếp trật tự từ. Hệ dựa trên quy tắc dùng bộ máy ngữ pháp, còn hệ thần kinh tự học việc này khi huấn luyện.
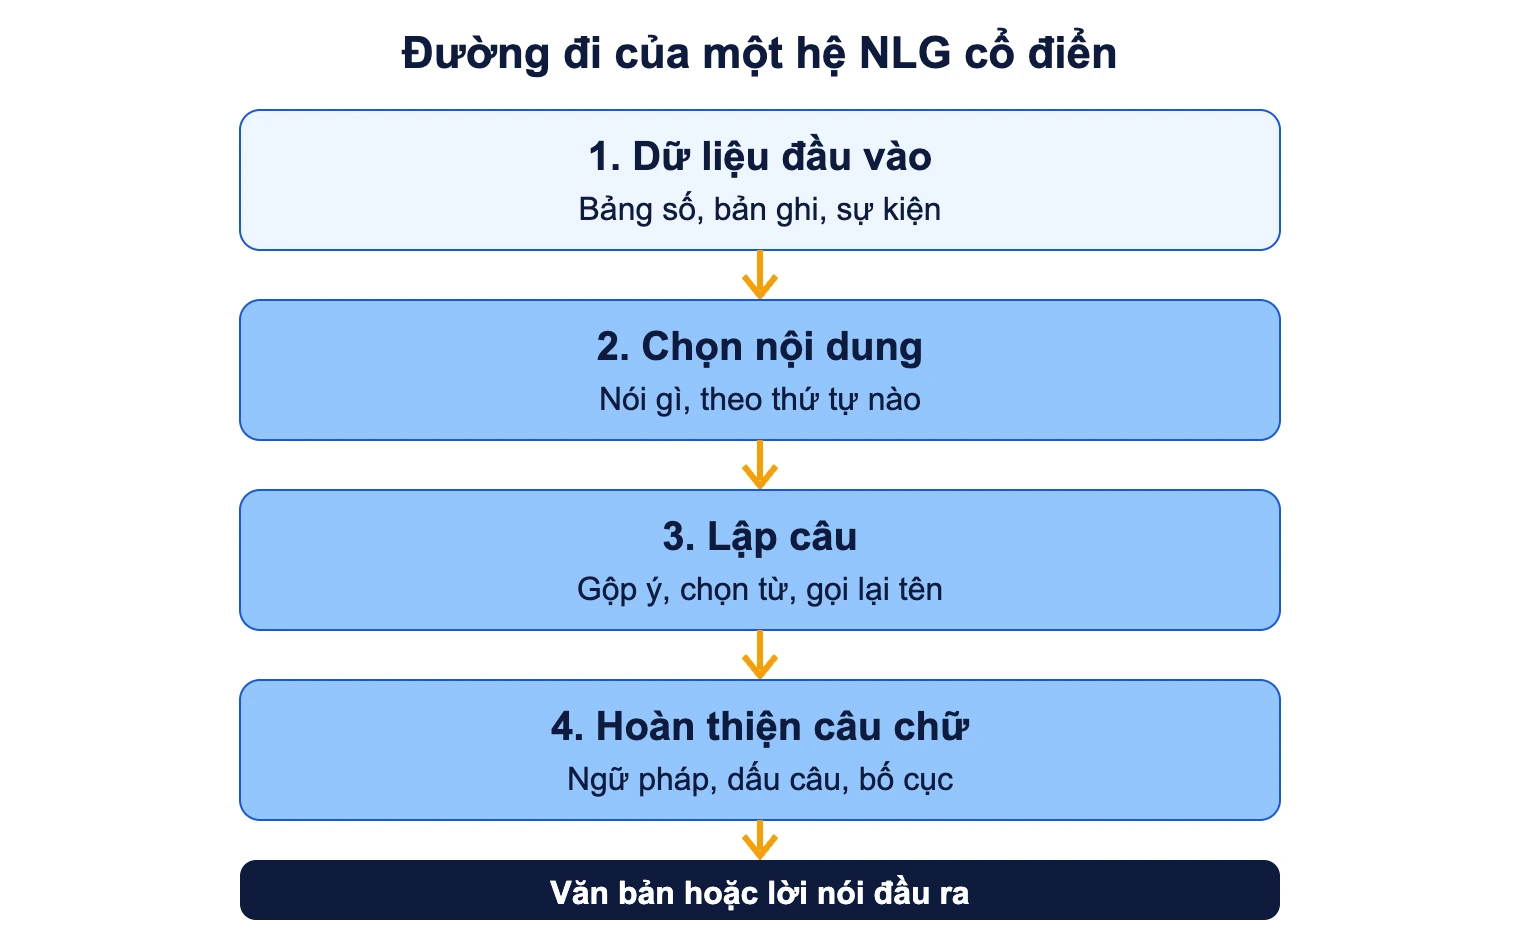
Trong hệ thống thực tế, ít hệ cài đủ cả chuỗi. Theo tài liệu giảng dạy của Đại học Charles (Séc), nhiều hệ chỉ làm lập kế hoạch nội dung với khâu hoàn thiện rất đơn giản, hoặc chỉ làm riêng khâu hoàn thiện câu chữ. Trong tổng đài tự động, bộ quản lý hội thoại đã quyết định nội dung, nên khối NLG chỉ còn lập câu và hoàn thiện câu chữ, và cách dùng mẫu câu rất hợp ở đó.
Ba cách làm NLG: mẫu, quy tắc và mô hình thần kinh
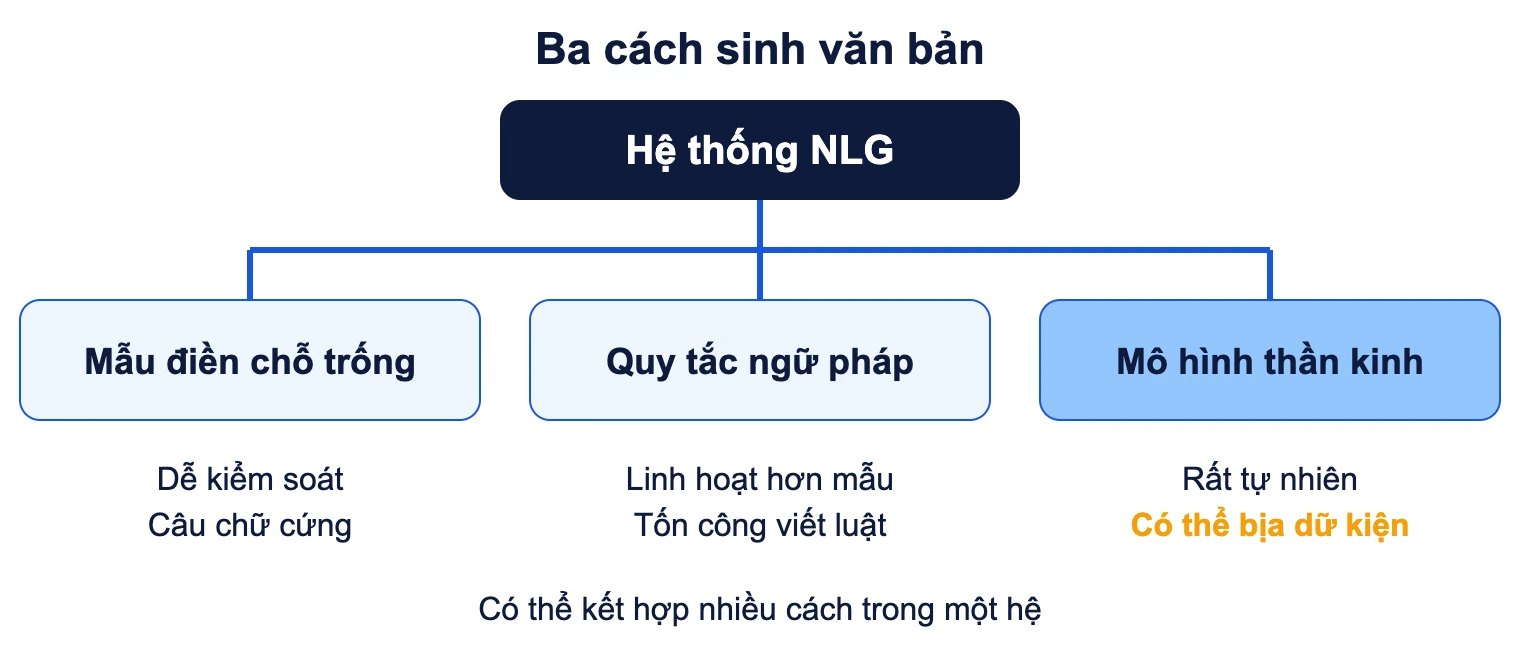
Mẫu điền chỗ trống (template-based)
Văn bản có cấu trúc định sẵn với các khoảng trống, dữ liệu được điền vào. Về sau, các hệ này được bổ sung kịch bản và quy tắc nghiệp vụ để kiểm soát tốt hơn. Ví dụ minh hoạ: mẫu “Tài khoản {số_cuối} biến động {số_tiền} VND lúc {giờ}” cho ra thông báo biến động số dư. Câu luôn đúng cấu trúc, nhưng chỉ nói được điều đã được viết sẵn.
Với tiếng Việt, mẫu câu gặp khó ở xưng hô (anh, chị, quý khách), loại từ đi kèm số đếm và cách đọc số, ngày tháng. Mẫu càng nhiều biến thể thì kho mẫu càng phình ra.
Quy tắc ngữ pháp (grammar-based)
Hệ thống có bộ máy ngữ pháp để dựng câu từ biểu diễn ngữ nghĩa, tự chia dạng từ và sắp thứ tự từ. Cách này linh hoạt hơn mẫu nhưng đòi hỏi chuyên gia ngôn ngữ viết luật, nên chi phí xây dựng cao. Một bài nghiên cứu năm 2019 trên arXiv ghi nhận các hệ dựa trên quy tắc và mẫu chiếm ưu thế trong NLG thương mại, vì đáng tin về độ đầy đủ nhưng tốn nhiều công sức tạo ra.
Mô hình thần kinh (neural)
Mô hình học từ kho văn bản lớn và sinh từng đơn vị từ tiếp theo. Các hệ dựa trên kiến trúc transformer thực hiện các giai đoạn trên một cách ngầm định, không tách thành module riêng. Cơ chế cốt lõi là cơ chế attention, cho phép mô hình cân nhắc phần nào của ngữ cảnh quan trọng khi chọn từ kế tiếp. Cùng bài nghiên cứu năm 2019 nói trên cũng chỉ ra điểm yếu của hướng này: câu văn trôi chảy nhưng có vấn đề về ảo giác và thiếu độ đầy đủ.
Chatbot và trợ lý soạn thảo hiện nay là NLG thần kinh. Nhưng NLG không đồng nghĩa với chatbot: thông báo biến động số dư dùng mẫu câu cũng là NLG.
Ví dụ NLG trong thực tế: từ dữ liệu đến câu chữ
Bảng dưới là ví dụ minh hoạ, không phải số liệu của doanh nghiệp cụ thể. Nó cho thấy cùng một bản ghi có thể ra những câu rất khác nhau tuỳ cách làm.
| Đầu vào (ví dụ minh hoạ) | Bằng mẫu | Bằng mô hình thần kinh |
|---|---|---|
| Chi nhánh Đà Nẵng, doanh thu tháng 9: 4,2 tỷ, kế hoạch 4,5 tỷ | “Doanh thu chi nhánh Đà Nẵng tháng 9 đạt 4,2 tỷ đồng, bằng 93% kế hoạch.” | “Đà Nẵng chưa chạm kế hoạch tháng 9, mới đạt 4,2 trên 4,5 tỷ đồng.” (cách diễn đạt có thể đổi mỗi lần chạy) |
| Kết quả xét nghiệm có chỉ số vượt ngưỡng | Mẫu cố định liệt kê chỉ số và ngưỡng | Diễn giải mềm hơn nhưng cần người có chuyên môn rà soát |
Các ứng dụng NLG được nêu nhiều trong tài liệu gồm báo cáo thời tiết, báo cáo bệnh nhân, chú thích ảnh và chatbot. Trong doanh nghiệp, bốn tình huống thường gặp là:
- Báo cáo từ công cụ BI. Bảng điều khiển đi kèm đoạn văn nêu ba biến động lớn nhất trong kỳ, để người không đọc được biểu đồ vẫn nắm ý.
- Giao diện hỏi đáp trên dữ liệu. Khi người dùng gõ “doanh số theo vùng năm nay”, hệ thống trả kèm một câu tóm tắt kết quả.
- Thông báo giao dịch và nhắc lịch. Khối lượng lớn, nội dung lặp, độ chính xác của con số là yêu cầu số một.
- Mô tả sản phẩm hàng loạt. Từ bảng thuộc tính (chất liệu, kích thước, màu) sinh mô tả cho hàng nghìn mã hàng. Chủ đề này liên quan chặt tới AI trong bán lẻ.
Khi nào chọn cách nào? Ma trận quyết định
Hai câu hỏi quyết định nhanh: sai một con số thì hậu quả đến đâu, và nội dung có cần đa dạng câu chữ không.
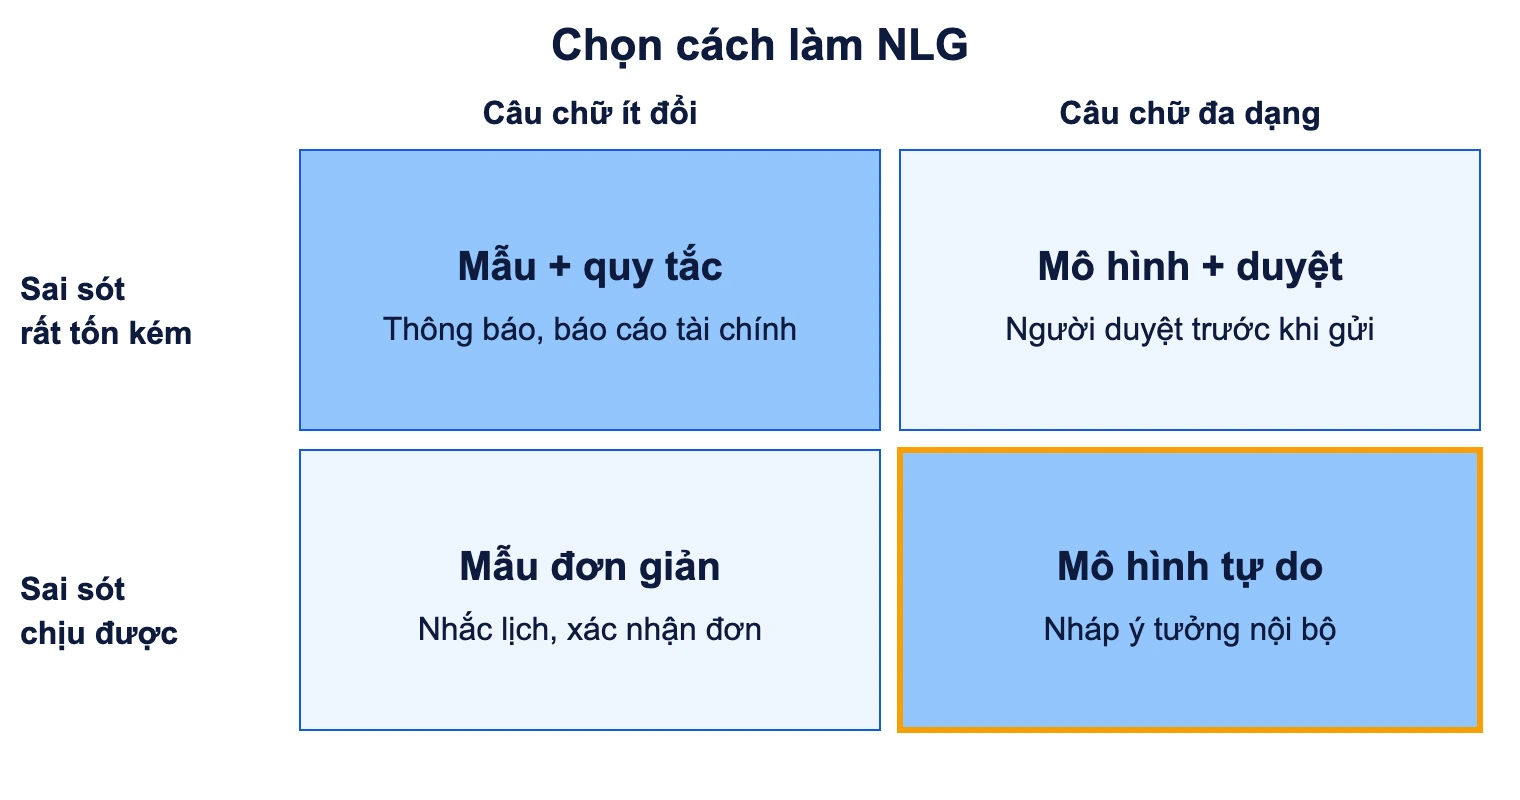
Hệ quả thực tế: nội dung chứa con số, ngày hạn, số tiền hay điều khoản nên đi bằng mẫu hoặc quy tắc, còn mô hình thần kinh chỉ nên đảm nhận phần diễn đạt khi có bước kiểm tra dữ kiện. Nhiều hệ lai cho mô hình viết nháp, rồi một lớp kiểm tra đối chiếu mọi con số trong câu với bản ghi gốc trước khi phát hành.
Rủi ro và hạn chế khi dùng NLG
- Ảo giác dữ kiện. Mô hình thần kinh có thể thêm chi tiết không có trong dữ liệu, hoặc bỏ sót chi tiết quan trọng. Câu văn mượt làm lỗi khó bị phát hiện hơn.
- Thiên lệch. Mô hình học từ văn bản có sẵn nên có thể lặp lại định kiến trong cách gọi và mô tả. Xem thêm về thiên lệch AI.
- Khó giải thích vì sao có câu đó. Với mẫu câu, bạn lần được câu về đúng mẫu và đúng trường dữ liệu. Với mô hình thần kinh thì khó hơn nhiều.
- Dữ liệu đưa vào. Nếu bản ghi chứa thông tin cá nhân và được gửi tới dịch vụ bên ngoài để sinh văn bản, bạn cần xác định rõ trường nào thực sự cần thiết cho việc sinh văn bản và loại bỏ hoặc ẩn các trường còn lại như họ tên, số điện thoại, địa chỉ trước khi gửi đi, theo đúng Luật Bảo vệ dữ liệu cá nhân về căn cứ xử lý và chuyển dữ liệu.
- Quy định về AI. Nếu sản phẩm của bạn sinh nội dung cho người dùng cuối, hãy đọc bài về Luật Trí tuệ nhân tạo 2025 để xem hệ thống của mình rơi vào nhóm nghĩa vụ nào.
NLG có lợi và hạn chế gì cho doanh nghiệp Việt?
Lợi thế: văn bản cho hàng nghìn bản ghi được tạo cùng một chuẩn giọng văn, người đọc không chuyên vẫn hiểu được số liệu, và kết quả chạy lại được khi dữ liệu thay đổi.
Hạn chế: tiếng Việt có hệ thống xưng hô và sắc thái lịch sự phụ thuộc quan hệ giữa người nói và người nghe, nên một mẫu câu chung dễ nghe cứng hoặc thiếu lễ độ. Dữ liệu huấn luyện tiếng Việt chuyên ngành cũng ít hơn tiếng Anh, nên mô hình dễ sai thuật ngữ ngành. Với tình huống nội dung đi ra ngoài (thư gửi khách, văn bản pháp lý), hãy xác định trước ai duyệt.
NLG khác gì với AI tạo sinh (generative AI)?
AI tạo sinh là khái niệm rộng, gồm cả sinh ảnh, âm thanh và mã nguồn, ví dụ qua mô hình khuếch tán. NLG chỉ là phần sinh ngôn ngữ. Ngược lại, NLG không nhất thiết là AI tạo sinh: hệ thống mẫu câu hay hệ ngữ pháp nhỏ vẫn là NLG nhưng không học từ kho dữ liệu khổng lồ. Khi một nhà cung cấp nói “dùng AI tạo sinh”, hãy hỏi cụ thể phần sinh văn bản chạy bằng mẫu hay bằng mô hình, vì rủi ro và cách kiểm soát khác nhau.
Khi nào nên và không nên dùng NLG?
Nên cân nhắc khi dữ liệu đầu vào đã có cấu trúc và đáng tin, nội dung lặp lại với số lượng lớn, và có một nguồn gốc để đối chiếu từng câu, như bản ghi giao dịch hay bảng chỉ số.
Không nên khi dữ liệu gốc còn lộn xộn hoặc mâu thuẫn, vì NLG chỉ diễn đạt lại và khuếch đại chất lượng dữ liệu. Cũng không nên khi nội dung là cam kết pháp lý mà không có người duyệt, hoặc khi chỉ cần một bảng số là đủ.
Câu hỏi thường gặp
NLG là viết tắt của gì?
NLG là Natural Language Generation, tiếng Việt thường gọi là sinh ngôn ngữ tự nhiên hoặc tạo ngôn ngữ tự nhiên. Nó chỉ phần máy tạo ra văn bản hoặc lời nói từ dữ liệu hoặc ý định.
NLG và NLP khác nhau thế nào?
NLP là phạm vi rộng, gồm mọi công nghệ để máy làm việc với ngôn ngữ con người. NLG là phần sinh ngôn ngữ, đi cùng NLU là phần hiểu ngôn ngữ.
ChatGPT có phải là NLG không?
Các chatbot dựa trên mô hình ngôn ngữ lớn được xếp vào ứng dụng NLG, theo cách hiểu rộng về sinh văn bản. Tuy vậy NLG còn gồm cả hệ mẫu câu và hệ quy tắc không dùng mô hình lớn.
NLG có tự viết được tiếng Việt chuẩn không?
Mô hình thần kinh hiện sinh được tiếng Việt khá trôi chảy, nhưng bạn vẫn cần kiểm tra thuật ngữ chuyên ngành, xưng hô và dữ kiện. Với nội dung có số liệu, mẫu câu cộng quy tắc cho kết quả ổn định hơn.
Làm sao biết đầu ra NLG có đáng tin?
Đối chiếu từng con số, tên và ngày trong văn bản với bản ghi gốc. Với hệ thần kinh, thêm một lớp kiểm tra tự động cho dữ kiện và giữ người duyệt với nội dung gửi ra ngoài.
Hiểu sâu hơn về NLG nên đọc gì tiếp?
Nếu muốn biết mô hình học cách sinh chữ thế nào, hãy đọc về dịch máy như một ví dụ sinh chuỗi có đối chiếu nguồn, và các bài về attention và NLU đã nêu ở trên.
VBPO Tech Blog cập nhật tin tức và kiến thức công nghệ cho doanh nghiệp Việt Nam. Xem thêm các bài cùng chuyên mục AI cơ bản.