
Trả lời nhanh: NLU (Natural Language Understanding, hiểu ngôn ngữ tự nhiên) là phần của AI chuyển một câu nói hoặc câu chữ tự do thành dữ liệu có cấu trúc: người dùng muốn làm gì (ý định) và các chi tiết đi kèm (thực thể). Chatbot, tổng đài tự động và hệ thống phân loại yêu cầu dựa vào kết quả này để hành động.
Điểm chính
- Hai nhiệm vụ cốt lõi của NLU là phân loại ý định (intent classification) và gán thực thể vào các ô thông tin (slot filling).
- Đầu ra của NLU là dữ liệu có cấu trúc, không phải câu trả lời. Việc viết câu trả lời thuộc về NLG.
- Tiếng Việt có những khó khăn riêng: tách từ, không dấu, viết tắt, số tiền viết tắt, địa chỉ viết rút gọn.
- Chất lượng NLU đo theo từng ý định (precision, recall) và theo tỷ lệ câu bị chuyển cho người, không đo bằng một con số chung.
Mục lục
- NLU là gì?
- NLU hoạt động như thế nào?
- Các thành phần chính của NLU
- Ví dụ NLU với câu tiếng Việt
- Ứng dụng của NLU trong doanh nghiệp Việt Nam
- Có những cách nào để xây NLU?
- Làm sao biết NLU hoạt động tốt?
- Ưu điểm và hạn chế của NLU
- NLU khác NLP và NLG ở đâu?
- Khi nào nên và không nên dùng NLU?
- Câu hỏi thường gặp
NLU là gì?
NLU là một nhánh của xử lý ngôn ngữ tự nhiên tập trung vào phần “đọc hiểu”: nhận một câu ở dạng tự do và trả về ý nghĩa mà phần mềm dùng được. Theo mô tả trong nghiên cứu về trợ lý giọng nói, NLU nhằm tạo ra một khung có cấu trúc cho các truy vấn của người dùng, và thường gồm hai nhiệm vụ chính là phân loại ý định và điền slot.
Hãy xem một câu ví dụ minh hoạ: “Đổi lịch giao đơn 4821 sang chiều mai giúp mình”. Con người đọc là hiểu ngay. Phần mềm kế toán hay hệ thống đơn hàng thì cần một thứ khác: một mã hành động (đổi lịch giao), mã đơn (4821) và một mốc thời gian cụ thể (ngày mai, buổi chiều). NLU là bước tạo ra ba thứ đó từ câu chữ.
Điểm cần nhớ: NLU không “hiểu” theo nghĩa con người. Nó ánh xạ câu vào một tập ý định và thực thể mà đội dự án đã định nghĩa trước. Câu nằm ngoài tập đó thường bị gán sai hoặc rơi vào nhóm “không rõ”.
NLU hoạt động như thế nào?
Một hệ thống NLU điển hình xử lý câu qua nhiều bước nối tiếp. Tên bước thay đổi theo công cụ, nhưng chuỗi logic khá giống nhau.
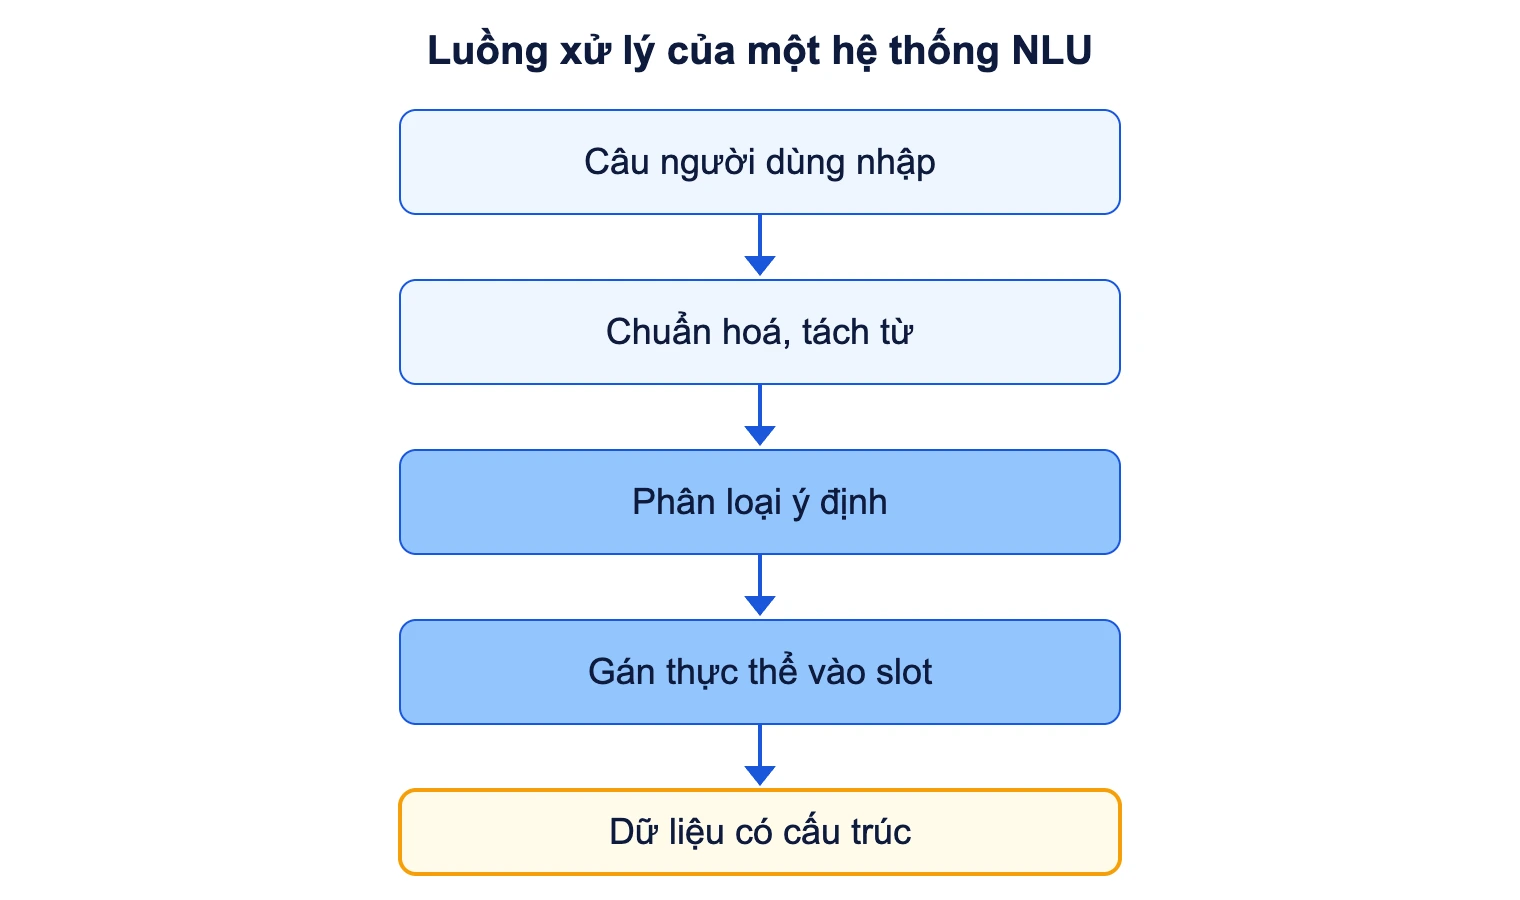
Bước 1: chuẩn hoá và tách từ
Văn bản được làm sạch (xử lý dấu cách thừa, ký tự lạ, chuẩn Unicode) rồi chia thành đơn vị nhỏ gọi là token. Với tiếng Việt, đây là chỗ khác tiếng Anh: chữ cách nhau bằng dấu cách nhưng từ có thể gồm nhiều tiếng. “Sinh viên” là một từ, còn “sinh” và “viên” đứng riêng lại mang nghĩa khác. Nhiều hệ thống dùng mô hình đã huấn luyện sẵn để tránh phải tách từ bằng tay.
Bước 2: phân loại ý định
Toàn bộ câu được xếp vào một trong các ý định đã định nghĩa. Theo khảo sát về mô hình kết hợp ý định và slot, bài toán này thường được xem là phân loại có giám sát, ánh xạ cả câu vào một tập lớp hữu hạn. Nếu bạn chưa quen khái niệm này, hãy đọc bài về học có giám sát.
Bước 3: gán thực thể vào slot
Mỗi ý định đi kèm vài ô thông tin cần điền. Với ý định đặt vé, các ô có thể là điểm đi, điểm đến, ngày bay. Một ví dụ trong tài liệu nghiên cứu: câu “Book me a flight from Denver to New Jersey” có ý định book_flight cùng cặp slot origin là Denver, destination là New Jersey. Về kỹ thuật, slot filling gắn nhãn cho từng token trong câu, thuộc nhóm bài toán gán nhãn chuỗi.
Bước 4: chuẩn hoá giá trị (entity resolution)
Giá trị lấy từ câu vẫn là chữ. Hệ thống cần đổi thành giá trị máy dùng được. Tài liệu về nền tảng giọng nói Snips minh hoạ rất rõ: cụm “tomorrow evening” được đổi thành mốc ngày giờ định dạng chuẩn. Với tiếng Việt, bạn sẽ gặp các cụm như “chiều mai”, “2tr5”, “Q.7” hay “thứ Sáu tuần sau”, mỗi loại cần quy tắc chuyển đổi riêng.
Các thành phần chính của NLU
| Thành phần | Việc làm | Ví dụ minh hoạ |
|---|---|---|
| Ý định (intent) | Xác định mục đích của cả câu | “Tra cứu bảo hành”, “Huỷ đơn”, “Xin hoá đơn” |
| Thực thể (entity/slot) | Lấy chi tiết cần để thực hiện | Mã đơn, số điện thoại, ngày giao, số tiền |
| Chuẩn hoá thực thể | Đổi cụm chữ thành giá trị chuẩn | “2tr5” thành 2.500.000 đồng |
| Ngữ cảnh hội thoại | Nhớ các lượt trước | “Cái đó” chỉ đơn hàng vừa nhắc |
| Phân tích cảm xúc | Gắn nhãn tích cực, tiêu cực, trung tính | Phản hồi sau mua hàng |
| Điểm tin cậy (confidence) | Cho biết mức chắc chắn của dự đoán | Dưới ngưỡng thì hỏi lại hoặc chuyển người |
Về phân tích cảm xúc, đây là bài toán có thể đứng riêng, xem phân tích cảm xúc. Khác với slot filling, bài toán nhận diện tên riêng (NER) chỉ tìm các thứ có tên như người, công ty, địa điểm; slot filling gắn thông tin vào đúng vai trò trong ý định đó.
Ví dụ NLU với câu tiếng Việt
Ví dụ minh hoạ: một cửa hàng online nhận tin nhắn “ko nhận đc hàng, đơn 4821, ship lại chiều mai dc ko”. Một cấu hình NLU hợp lý có thể trả về kết quả như bảng dưới.
| Thông tin | Giá trị trích ra | Điểm khó |
|---|---|---|
| Ý định | doi_lich_giao | Câu mở đầu nói về “không nhận được hàng”, dễ bị xếp nhầm vào khiếu nại |
| Mã đơn | 4821 | Dễ nhầm với số điện thoại hoặc số lượng |
| Thời điểm giao | ngày mai, 12:00–18:00 | “Chiều” cần quy ước khoảng giờ do doanh nghiệp tự định |
| Biến thể viết tắt | “ko” là “không”, “đc” là “được”, “dc” cũng là “được” | Cần dữ liệu huấn luyện chứa cách viết thật của khách |
Ví dụ trên cho thấy lý do NLU cần dữ liệu thật. Mô hình học trên văn bản báo chí sẽ vấp với tin nhắn chat. Với tin nhắn không dấu như “toi muon doi dia chi giao”, bạn cần quyết định: thêm bước khôi phục dấu, hay huấn luyện thêm mẫu không dấu.
Ứng dụng của NLU trong doanh nghiệp Việt Nam
- Chatbot chăm sóc khách hàng: nhận diện ý định (hỏi giá, tra đơn, huỷ dịch vụ) rồi gọi đúng API. Phần chữ trả lời có thể do kịch bản soạn sẵn hoặc do sinh ngôn ngữ tự nhiên.
- Tổng đài và voice bot: giọng nói qua nhận dạng giọng nói thành chữ, sau đó NLU xác định ý định. Lỗi ở bước chuyển giọng thành chữ sẽ lan sang bước hiểu, nên cần đo riêng từng lớp.
- Phân loại yêu cầu nội bộ: email hoặc ticket gửi vào hộp thư chung được gán nhãn (IT, nhân sự, kế toán) và độ khẩn.
- Trích thông tin từ tin nhắn bán hàng: tên sản phẩm, số lượng, địa chỉ nhận từ tin nhắn trên mạng xã hội, đổ thẳng vào phiếu đơn.
- Tìm kiếm nội bộ: hiểu câu hỏi như “mẫu đơn nghỉ phép năm” thay vì chỉ khớp từ khoá. Mảng này thường kết hợp với embedding để so khớp theo nghĩa.
Nhật ký chat và ghi âm cuộc gọi chứa dữ liệu cá nhân (số điện thoại, địa chỉ, đôi khi cả thông tin tài chính). Khi dùng chúng làm dữ liệu huấn luyện NLU, bạn cần xem lại căn cứ xử lý và mục đích theo Luật Bảo vệ dữ liệu cá nhân, đồng thời nên ẩn danh các trường nhận dạng như số điện thoại, địa chỉ và thông tin tài chính trước khi gán nhãn.
Có những cách nào để xây NLU?
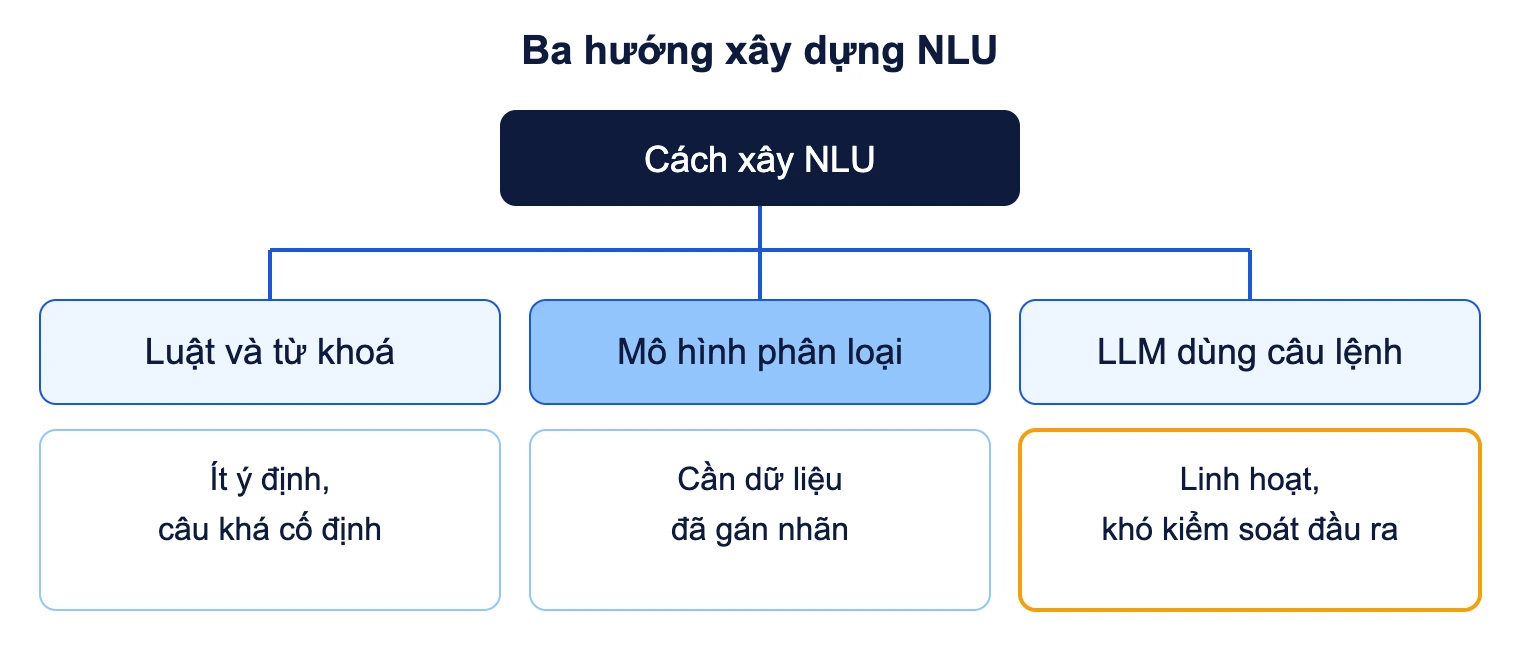
Luật và từ khoá
Viết mẫu câu, biểu thức chính quy (regex) và danh sách từ đồng nghĩa. Ưu điểm là kết quả giải thích được và sửa tức thì. Nhược điểm là số luật phình ra rất nhanh khi khách diễn đạt đa dạng.
Mô hình phân loại huấn luyện từ dữ liệu
Đội dự án gán nhãn câu mẫu theo ý định và thực thể, rồi huấn luyện mô hình. Từ khoảng năm 2019, hướng phổ biến là tinh chỉnh mô hình ngôn ngữ đã học sẵn; công trình “BERT for Joint Intent Classification and Slot Filling” được công bố trên arXiv năm 2019. Nếu muốn hiểu mô hình nền, xem BERT. Dữ liệu gán nhãn là phần tốn công nhất, nhất là với ý định hiếm.
Mô hình ngôn ngữ lớn dùng câu lệnh
Bạn mô tả danh sách ý định và định dạng đầu ra trong câu lệnh, rồi để mô hình tự phân loại. Cách này khởi động nhanh, nhưng đầu ra có thể lệch định dạng hoặc tự bịa giá trị slot. Vì vậy thường phải thêm bước kiểm tra: giá trị trích ra có thật sự xuất hiện trong câu, mã đơn có tồn tại trong hệ thống hay không.
Làm sao biết NLU hoạt động tốt?
Độ chính xác tổng thể dễ gây hiểu lầm khi một vài ý định chiếm phần lớn lượng câu. Cách đo hữu ích hơn:
- Precision và recall theo từng ý định: ý định “huỷ hợp đồng” bị bỏ sót (recall thấp) gây hậu quả khác hẳn ý định “hỏi giờ mở cửa” bị bỏ sót.
- Ma trận nhầm lẫn (confusion matrix): cho thấy cặp ý định hay bị lẫn, ví dụ “đổi lịch giao” với “khiếu nại giao chậm”. Cặp bị lẫn nhiều thường là dấu hiệu định nghĩa hai ý định chưa rõ.
- Độ chính xác của slot: đo riêng từng loại thực thể. Mô hình có thể đúng ý định nhưng sai mã đơn.
- Ngưỡng tin cậy và tỷ lệ chuyển người: câu dưới ngưỡng nên được hỏi lại hoặc chuyển nhân viên, thay vì trả lời đại.
- Tập kiểm thử tách riêng: gồm câu thật, có cả không dấu, viết tắt, câu ngoài phạm vi. Không dùng lại câu đã huấn luyện để kiểm tra, nếu không sẽ gặp overfitting mà không nhận ra.
Ưu điểm và hạn chế của NLU
| Ưu điểm | Hạn chế |
|---|---|
| Biến câu tự do thành dữ liệu hệ thống dùng được | Chỉ hiểu trong phạm vi ý định đã định nghĩa |
| Chịu được cách diễn đạt khác nhau cho cùng một ý | Câu mỉa mai, câu nhiều ý, câu thiếu chủ ngữ vẫn dễ sai |
| Cho điểm tin cậy để quyết định chuyển người | Dữ liệu gán nhãn lệch sẽ làm mô hình lệch theo |
| Dùng chung được cho chat, email, giọng nói sau khi chuyển chữ | Phương ngữ và tiếng lóng cần dữ liệu riêng |
NLU khác NLP và NLG ở đâu?
| Tiêu chí | NLP | NLU | NLG |
|---|---|---|---|
| Phạm vi | Toàn bộ lĩnh vực xử lý ngôn ngữ | Một nhánh: đọc và hiểu | Một nhánh: viết ra |
| Đầu vào | Văn bản hoặc lời nói | Câu người dùng | Dữ liệu có cấu trúc |
| Đầu ra | Tuỳ tác vụ | Ý định, thực thể, nhãn | Câu chữ tự nhiên |
| Ví dụ | Dịch máy, tóm tắt, sửa lỗi chính tả | Hiểu “huỷ đơn 4821” | Soạn câu “Đơn 4821 đã được huỷ” |
Nói gọn: NLU nằm giữa đầu vào và quyết định; NLG nằm giữa quyết định và đầu ra. Tổng quan về cả lĩnh vực nằm ở bài NLP (đã link ở trên), còn nền tảng AI chung ở bài trí tuệ nhân tạo. Lưu ý một điểm gây nhầm: các mô hình ngôn ngữ lớn hiện nay làm được cả hiểu lẫn viết, nên ranh giới NLU và NLG trong sản phẩm thực tế mờ hơn trong sách giáo khoa. Phân biệt vẫn hữu ích khi bạn cần kiểm soát từng bước.
Khi nào nên và không nên dùng NLU?
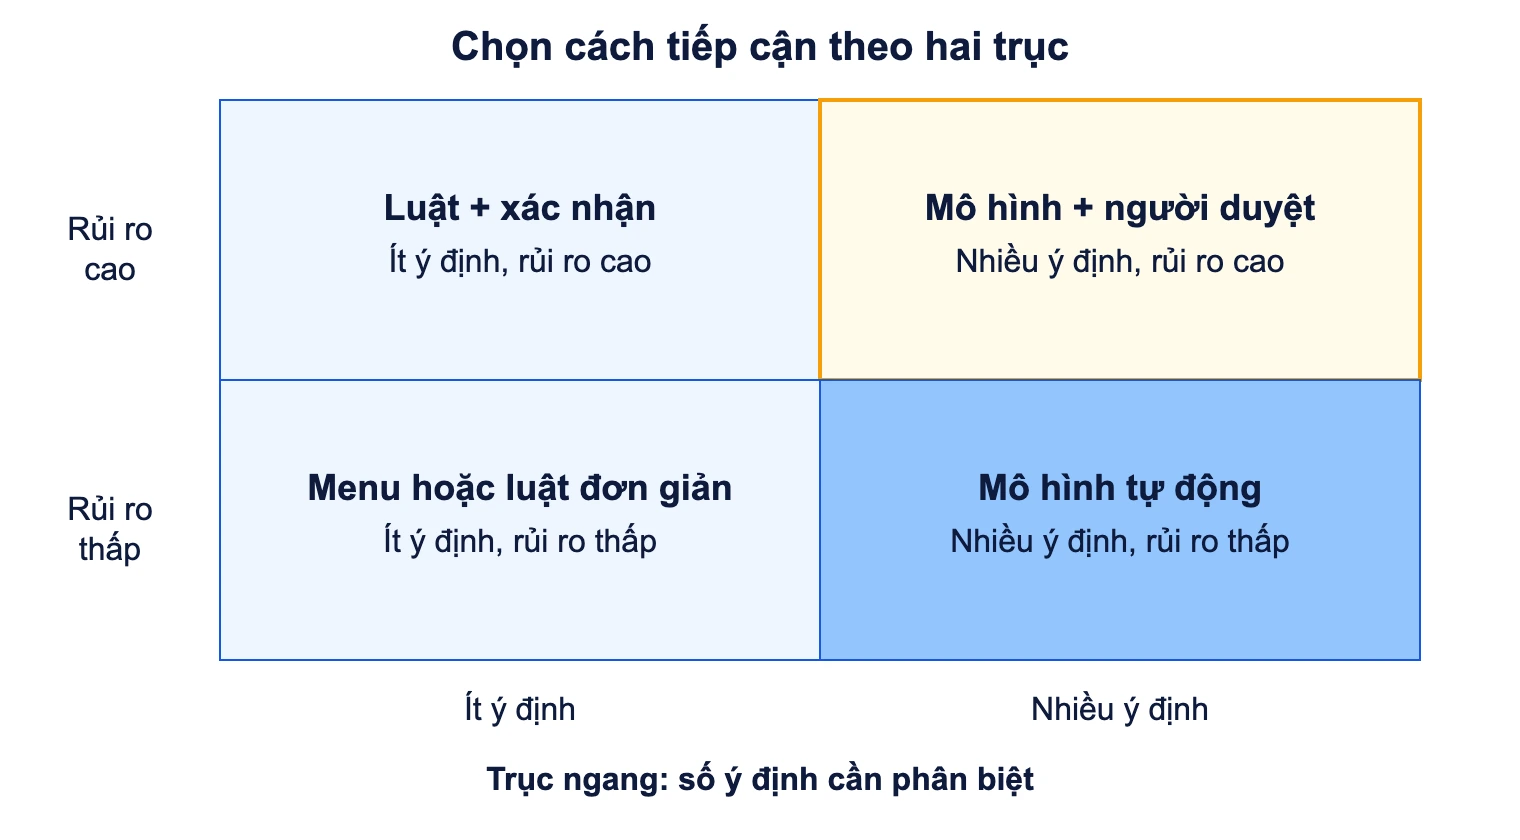
Hợp lý khi bạn có lượng lớn câu chữ tự do lặp lại về một nhóm việc rõ (tra đơn, đặt lịch, xin tài liệu), có nhật ký thật để gán nhãn và có hệ thống phía sau nhận dữ liệu có cấu trúc để xử lý tiếp.
Cần thận trọng khi hậu quả của việc hiểu sai lớn: huỷ hợp đồng, chuyển tiền, xác nhận thông tin y tế. Ở các tình huống này, nên để NLU gợi ý ý định rồi bắt người dùng hoặc nhân viên xác nhận trước khi thực hiện.
Không cần NLU khi chỉ có vài lựa chọn cố định: một menu nút bấm vừa rẻ vừa không sai. Nếu muốn hiểu thêm bức tranh rủi ro khi AI diễn giải sai, xem thiên lệch trong AI, vì dữ liệu gán nhãn lệch sẽ khiến một nhóm khách hàng bị hiểu sai nhiều hơn nhóm khác.
Câu hỏi thường gặp
NLU là gì, nói ngắn gọn?
Là công nghệ giúp máy chuyển câu nói hoặc câu chữ tự do thành ý định và các thực thể có cấu trúc, để phần mềm biết người dùng muốn gì và với thông tin nào.
NLU và NLP khác nhau thế nào?
NLP là lĩnh vực rộng gồm cả dịch máy, tóm tắt, sửa chính tả và nhiều tác vụ khác. NLU là nhánh tập trung vào việc hiểu nghĩa của câu đầu vào. NLG là nhánh còn lại, lo việc viết ra câu chữ.
Intent và slot là gì?
Intent là mục đích của cả câu, ví dụ “đặt vé”. Slot là các chi tiết cần có để làm việc đó, ví dụ điểm đi, điểm đến, ngày bay. Ý định thường được xử lý như bài toán phân loại câu, còn slot như bài toán gán nhãn cho từng token.
NLU có hiểu được tiếng Việt không dấu hoặc viết tắt không?
Có thể, nhưng không tự động. Mô hình cần thấy các cách viết đó trong dữ liệu huấn luyện hoặc đi qua bước chuẩn hoá. Bạn nên đưa câu không dấu và viết tắt thật vào tập kiểm thử để biết mức sai cụ thể.
Có cần dùng mô hình ngôn ngữ lớn để làm NLU không?
Không bắt buộc. Với số ý định ít và câu khá ổn định, luật hoặc mô hình phân loại nhỏ thường rẻ, nhanh và dễ kiểm hơn. Mô hình ngôn ngữ lớn phù hợp khi câu đa dạng, nhưng cần thêm bước kiểm tra đầu ra.
Dữ liệu chat dùng để huấn luyện NLU có bị ràng buộc pháp lý không?
Có, nếu chứa thông tin nhận dạng cá nhân. Bạn nên ẩn danh các trường như số điện thoại, địa chỉ trước khi gán nhãn.
Đọc thêm tin tức, phân tích về AI, blockchain và chuyển đổi số trên blog công nghệ VBPO, hoặc các bài khác trong chuyên mục AI cơ bản.