
Trả lời nhanh: Garbage in, garbage out (GIGO, “rác vào, rác ra”) là nguyên tắc nói rằng kết quả không thể tốt hơn dữ liệu đầu vào. Máy tính, bảng tính hay mô hình AI chỉ xử lý những gì được đưa vào. Dữ liệu sai, thiếu, lệch hoặc gán nhãn sai sẽ cho kết quả sai, dù thuật toán tốt đến đâu.
Điểm chính
- Lần in sớm nhất được biết đến của cụm từ là một bài báo Mỹ ngày 10/11/1957; người đặt ra cụm từ vẫn chưa xác định chắc chắn.
- Dữ liệu rác có 7 dạng chính: sai, thiếu, trùng, không nhất quán, lỗi thời, nhãn sai và thiên lệch.
- Nhãn sai không chỉ làm mô hình học sai mà còn làm sai cả phép đo dùng để chọn mô hình.
- Chất lượng dữ liệu đo theo 6 chiều: chính xác, đầy đủ, nhất quán, kịp thời, hợp lệ, duy nhất.
- Rủi ro lớn hơn là “garbage in, gospel out”: tin kết quả của máy như chân lý dù đầu vào là rác.
Mục lục
- Garbage in, garbage out là gì?
- Cụm từ “garbage in, garbage out” ra đời từ đâu?
- GIGO xuất hiện ở đâu trong công việc?
- Dữ liệu rác gồm những dạng nào?
- Dữ liệu rác đã gây hậu quả gì trong thực tế?
- Vì sao nhãn sai làm hỏng mô hình AI?
- Kiểm soát chất lượng nhãn như thế nào?
- Chất lượng dữ liệu được đo theo những chiều nào?
- Checklist phòng tránh GIGO cho doanh nghiệp
- “Garbage in, gospel out” là gì?
- Hiểu lầm phổ biến về garbage in, garbage out
- Câu hỏi thường gặp
Garbage in, garbage out là gì?
Garbage in, garbage out (GIGO) dịch sát là “rác vào, rác ra”. Một hệ thống xử lý thông tin không tự sửa được dữ liệu đầu vào kém, nên đầu vào kém sẽ cho đầu ra kém.
Ví dụ đời thường: bạn nhập nhầm số điện thoại của khách vào phần mềm bán hàng. Phần mềm vẫn gửi tin nhắn đúng quy trình, đúng giờ, nhưng tới một người lạ. Hệ thống không hỏng, dữ liệu hỏng.
Cụm từ “garbage in, garbage out” ra đời từ đâu?
Nguồn gốc cụm từ hay bị kể sai. Những gì kiểm chứng được:
- Bản in sớm nhất được biết đến (1957): báo Hammond Times (bang Indiana, Mỹ) ngày 10/11/1957 có bài về các nhà toán học của Quân đội Mỹ làm việc với máy tính. Chuyên viên William D. Mellin giải thích máy không tự suy nghĩ, đầu vào cẩu thả thì đầu ra sai. Bài báo gọi “Garbage in, Garbage out” (GIGO) là thuật ngữ mới trong quân đội; Mellin không nhận mình nghĩ ra nó.
- George Fuechsel và IBM: nhiều bài, kể cả tiếng Việt, ghi Fuechsel, giảng viên IBM, là người đặt ra cụm từ. Thực tế, năm 2004 ông chỉ kể mình dùng cụm từ khi giảng dạy khoảng 1958–1959 và tự đặt dấu hỏi liệu mình có phải người đầu tiên. Mốc 1957 có trước đó, nên gọi ông là “cha đẻ” của GIGO là chưa có căn cứ.
- Ý tưởng có từ thế kỷ 19: Charles Babbage, người thiết kế máy tính cơ học lập trình được đầu tiên, kể trong hồi ký “Passages from the Life of a Philosopher” (1864) rằng ông từng bị hỏi: đưa số sai vào máy thì có ra đáp án đúng không.
- Biến thể: tiếng Anh Anh dùng “rubbish in, rubbish out”.
GIGO xuất hiện ở đâu trong công việc?
Trong lập trình
Phần mềm không kiểm tra đầu vào sẽ chạy “đúng” trên dữ liệu sai: ngày sinh 31/02, tuổi âm, ô số tiền chứa chữ. Vì vậy lập trình viên kiểm tra đầu vào (input validation) để chặn rác ngay từ cửa.
Trong phân tích dữ liệu
Mẫu khảo sát lệch thì kết luận lệch. Chỉ hỏi người dùng mạng xã hội rồi suy ra cho toàn dân số, con số đẹp mấy cũng sai.
Trong kế toán và báo cáo
Hoá đơn nhập trùng làm chi phí đội lên. Số định dạng dạng chữ bị bỏ qua khi cộng tổng. Ô trống bị hiểu là số 0. Các lỗi này không báo đỏ, nên báo cáo trông vẫn “sạch”.
Trong AI và học máy
Đây là nơi GIGO nặng ký nhất. Một hệ thống AI (trí tuệ nhân tạo) học quy luật từ dữ liệu huấn luyện. Dữ liệu sai hay lệch thì mô hình học đúng cái sai đó và lặp lại ở quy mô lớn. Lỗi này thường ẩn, chỉ lộ ra khi mô hình đã chạy thật.
Dữ liệu rác gồm những dạng nào?
| Dạng dữ liệu rác | Ví dụ minh hoạ | Hậu quả thường gặp |
|---|---|---|
| Sai (không chính xác) | Số điện thoại khách gõ nhầm một chữ số | Liên hệ thất bại, chăm sóc sai người |
| Thiếu | Hồ sơ khách hàng bỏ trống tỉnh/thành | Báo cáo theo vùng lệch, mô hình bỏ sót nhóm |
| Trùng lặp | “Nguyễn Văn A” và “Nguyen Van A” cùng một số điện thoại | Đếm thừa khách, gửi tin hai lần |
| Không nhất quán | Kho A ghi kg, kho B ghi tấn; ngày 03/04 hay 04/03 | Cộng sai, so sánh sai |
| Lỗi thời | Bảng giá năm trước còn trong hệ thống báo giá | Báo giá sai, quyết định theo bối cảnh cũ |
| Nhãn sai | Email bình thường bị gắn nhãn “spam” | Mô hình học sai, đánh giá mô hình sai |
| Thiên lệch | Dữ liệu giọng nói chủ yếu của một vùng miền | Mô hình kém với nhóm ít dữ liệu, thiếu công bằng |
Dữ liệu đi từ giấy tờ còn một nguồn rác riêng: lỗi nhận dạng. Khi OCR (nhận dạng ký tự quang học) đọc số 0 thành chữ O, một hoá đơn quét có thể mang số tiền sai mà không ai để ý.
Dữ liệu rác đã gây hậu quả gì trong thực tế?
- Không nhất quán đơn vị (1999): theo NASA, tàu Mars Climate Orbiter mất ngày 23/09/1999 vì phần mềm mặt đất dùng hệ đơn vị Anh, còn phần mềm trên tàu dùng hệ mét. Quỹ đạo bị tính sai, đưa tàu tới quá gần sao Hoả.
- Mất dữ liệu khi chuyển định dạng (2020): cơ quan Y tế Công cộng Anh bỏ sót 15.841 ca dương tính COVID-19 từ 25/09 đến 02/10/2020, vì dữ liệu được nạp vào định dạng Excel XLS cũ giới hạn khoảng 65.000 dòng. Khoảng 48.000 người tiếp xúc gần không được báo kịp thời.
- Lỗi bảng tính trong nghiên cứu kinh tế (2013): Thomas Herndon, Michael Ash và Robert Pollin (Đại học Massachusetts Amherst) chỉ ra nghiên cứu về nợ công của Reinhart và Rogoff có lỗi công thức bỏ sót một số quốc gia, cùng cách loại dữ liệu và tính trọng số gây tranh cãi. Sau khi sửa, tăng trưởng trung bình của nhóm nợ trên 90% GDP là khoảng 2,2% thay vì âm 0,1%.
- Dữ liệu lịch sử thiên lệch (2018): theo Reuters, Amazon bỏ một công cụ AI sàng lọc hồ sơ vì nó hạ điểm hồ sơ có từ “women’s” (của nữ). Công cụ học từ hồ sơ 10 năm, phần lớn của nam giới.
- Nhãn sai trong bộ dữ liệu chuẩn (2021): nghiên cứu của Curtis Northcutt và cộng sự tại hội nghị NeurIPS 2021 ước tính trung bình ít nhất 3,3% nhãn sai trong tập kiểm thử của 10 bộ dữ liệu phổ biến; riêng tập kiểm định ImageNet có ít nhất 6%.
Về chi phí, Gartner ước tính dữ liệu kém chất lượng làm mỗi tổ chức tốn trung bình ít nhất 12,9 triệu USD mỗi năm (nghiên cứu năm 2020). Tháng 02/2025, Gartner dự báo đến hết năm 2026, các tổ chức sẽ bỏ 60% dự án AI không có dữ liệu sẵn sàng cho AI.
Vì sao nhãn sai làm hỏng mô hình AI?
Với học có giám sát (supervised learning), nhãn là “đáp án” mô hình học theo. Việc tạo đáp án đó gọi là gán nhãn dữ liệu (data annotation). Đáp án sai thì mô hình học sai một cách tự tin.
Mô hình học thuộc cái sai
Nhãn sai ngẫu nhiên làm mô hình kém chính xác. Nhãn sai có hệ thống, ví dụ một người luôn gọi “xe bán tải” là “xe tải”, làm mô hình sai có định hướng và khó phát hiện hơn nhiều.
Nhãn sai làm sai cả phép đo
Bạn chọn mô hình theo điểm trên tập kiểm thử. Tập kiểm thử có nhãn sai thì điểm cũng sai. Nhóm của Northcutt cho thấy trên ImageNet với nhãn đã sửa, mô hình nhỏ ResNet-18 vượt mô hình lớn ResNet-50 khi tỷ lệ mẫu từng bị gán sai trong tập kiểm thử tăng thêm chỉ 6%. Nhãn sai có thể khiến bạn chọn nhầm mô hình.
Nhãn sai thường đến từ quy trình
Nguyên nhân hay gặp: hướng dẫn mơ hồ, định nghĩa lớp chồng lấn (“khiếu nại” hay “góp ý”?), người gán nhãn thiếu chuyên môn, áp lực năng suất. Nghiên cứu của Google Research tại hội nghị CHI 2021 với 53 người làm AI ở Ấn Độ, Đông Phi, Tây Phi và Mỹ ghi nhận 92% từng gặp “data cascades”: chuỗi hậu quả từ vấn đề dữ liệu, phát sinh sớm nhưng lộ ra muộn.
Kiểm soát chất lượng nhãn như thế nào?
Không bộ dữ liệu nào sạch 100%. Mục tiêu là đưa lỗi xuống mức chấp nhận được và biết lỗi nằm ở đâu, bằng một vòng lặp thay vì một bước kiểm tra cuối.
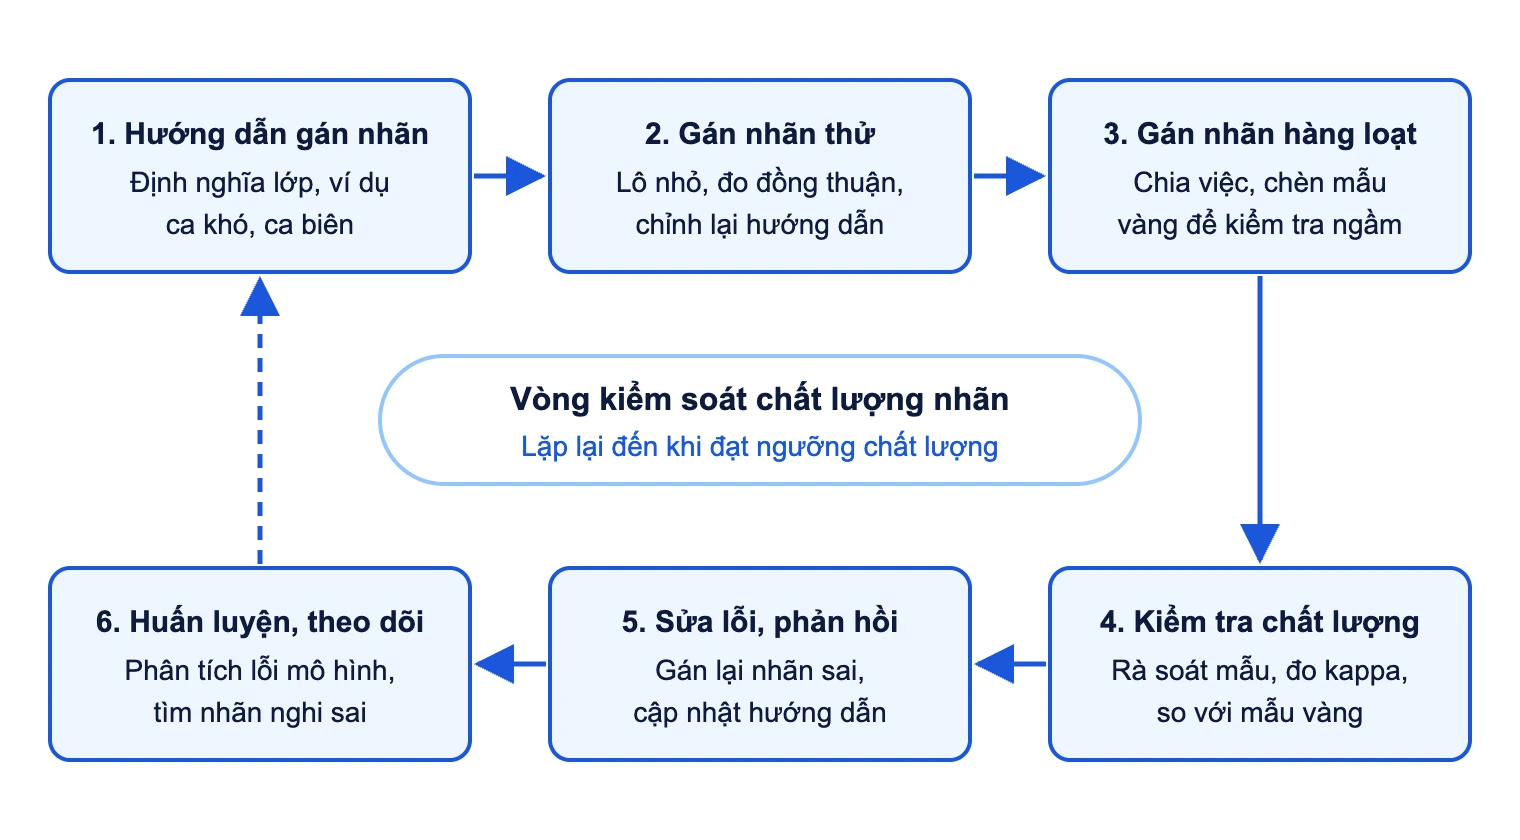
- Hướng dẫn gán nhãn (labeling guideline): mô tả từng lớp, kèm ví dụ đúng, ví dụ sai, cách xử lý ca biên; có đánh số phiên bản.
- Mẫu vàng (gold standard): tập nhỏ do chuyên gia gán chuẩn, chèn ngầm vào luồng việc để đo độ chính xác từng người.
- Gán nhãn chồng và đồng thuận (consensus): hai, ba người cùng gán một mẫu; mẫu bất đồng chuyển cho chuyên gia.
- Chỉ số đồng thuận (inter-annotator agreement): như hệ số Cohen’s kappa, đo mức đồng ý sau khi loại phần trùng hợp ngẫu nhiên. Kappa thấp thường báo hiệu hướng dẫn mơ hồ.
- Dùng mô hình tìm nhãn nghi sai: mẫu mà mô hình rất tự tin nhưng ngược với nhãn được đưa cho người xem lại. Trong nghiên cứu của Northcutt, khoảng 51% ứng viên do thuật toán đánh dấu được xác nhận là sai thật.
Đừng chỉ sửa nhãn sai rồi bỏ qua. Lỗi lặp lại là dấu hiệu hướng dẫn hoặc định nghĩa lớp có vấn đề. Sửa ở gốc thì lỗi không quay lại ở lô sau.
Chất lượng dữ liệu được đo theo những chiều nào?
Hiệp hội Quản lý Dữ liệu Anh (DAMA UK) đưa ra 6 chiều chất lượng dữ liệu, được Chính phủ Anh giới thiệu lại năm 2021. Tại Việt Nam, Điều 12 Luật Dữ liệu số 60/2024/QH15 (thông qua ngày 30/11/2024, hiệu lực từ 01/07/2025) quy định bảo đảm chất lượng dữ liệu là bảo đảm tính chính xác, hợp lệ, toàn vẹn, đầy đủ, cập nhật kịp thời, thống nhất.
| Chiều chất lượng | Câu hỏi cần trả lời | Cách đo gợi ý |
|---|---|---|
| Chính xác (accuracy) | Dữ liệu có đúng thực tế không? | Đối chiếu một mẫu với chứng từ gốc |
| Đầy đủ (completeness) | Có đủ dữ liệu cho mục đích dùng không? | Tỷ lệ ô trống ở trường bắt buộc |
| Nhất quán (consistency) | Giá trị có mâu thuẫn giữa các hệ thống không? | Số bản ghi lệch giữa CRM và kế toán |
| Kịp thời (timeliness) | Dữ liệu có sẵn và còn đúng khi cần không? | Độ trễ từ lúc phát sinh tới lúc vào hệ thống |
| Hợp lệ (validity) | Có đúng định dạng, kiểu, miền giá trị không? | Tỷ lệ vi phạm quy tắc ngày, mã số thuế, email |
| Duy nhất (uniqueness) | Mỗi thực thể có xuất hiện đúng một lần không? | Tỷ lệ bản ghi trùng sau chuẩn hoá |
Với dữ liệu huấn luyện AI, nên đo thêm tỷ lệ nhãn sai và độ đại diện: dữ liệu có phủ đủ các nhóm người dùng và tình huống mô hình sẽ gặp không.
Checklist phòng tránh GIGO cho doanh nghiệp
- Xác định dữ liệu quan trọng (doanh thu, công nợ, khách hàng, tồn kho) và giao người chịu trách nhiệm cho từng nhóm.
- Chặn rác ở đầu vào: danh sách chọn thay ô gõ tự do, kiểm tra định dạng ngay khi nhập.
- Chuẩn hoá đơn vị, định dạng ngày, bộ mã sản phẩm trên mọi hệ thống.
- Mỗi khách hàng, sản phẩm, nhà cung cấp có một mã định danh; định kỳ kiểm tra trùng.
- Kiểm tra mỗi lần chuyển dữ liệu: so số dòng và tổng giữa nguồn và đích. Vụ bỏ sót ca bệnh ở Anh cho thấy dữ liệu có thể mất lặng lẽ ở bước này.
- Theo dõi chỉ số chất lượng tự động và cảnh báo khi vượt ngưỡng; đây là một phần của DataOps.
- Với dữ liệu AI: có hướng dẫn gán nhãn, mẫu vàng, đo đồng thuận và một tập kiểm thử được rà soát kỹ.
- Đối chiếu kết quả với nguồn độc lập: doanh thu báo cáo so với sao kê ngân hàng, dự báo so với thực tế.
- Ghi nguồn gốc dữ liệu (data lineage) để khi sai thì truy được gốc.
“Garbage in, gospel out” là gì?
Từ điển thuật ngữ tin học Jargon File ghi nhận nghĩa châm biếm thứ hai của GIGO: “garbage in, gospel out”, rác vào, “chân lý” ra. Nó chỉ thói quen tin tuyệt đối vào thông tin do máy tạo ra, bất kể đầu vào.
GIGO là lỗi dữ liệu. “Gospel out” là lỗi con người, và thường gây hại hơn. Con số trên dashboard hay câu trả lời trôi chảy của chatbot đều tạo cảm giác khách quan. Khi không ai hỏi “dữ liệu này từ đâu ra”, rác thành căn cứ ra quyết định.
Với AI tạo sinh còn một tầng nữa. Nghiên cứu của Ilia Shumailov và cộng sự trên tạp chí Nature ngày 24/07/2024 cho thấy huấn luyện tràn lan bằng nội dung do mô hình tạo ra gây khiếm khuyết không đảo ngược: các trường hợp hiếm trong dữ liệu gốc dần biến mất.
Cách phòng: giữ con người trong vòng kiểm soát (human-in-the-loop) với quyết định quan trọng, yêu cầu báo cáo ghi rõ nguồn và thời điểm cập nhật dữ liệu, kiểm tra chéo kết quả “quá đẹp” hoặc “quá lạ”.
Hiểu lầm phổ biến về garbage in, garbage out
- “Thuật toán mạnh sẽ tự lọc rác”: sai. Mô hình mạnh học dữ liệu rác càng giỏi, và không biến dữ liệu lệch thành dữ liệu công bằng.
- “Càng nhiều dữ liệu càng tốt”: thêm một triệu bản ghi lệch chỉ làm độ lệch chắc chắn hơn.
- “Dữ liệu sạch là việc của IT”: người tạo dữ liệu là bán hàng, kế toán, kho. IT cung cấp công cụ, nghiệp vụ chịu trách nhiệm chất lượng.
- “Đầu ra sai thì do đầu vào sai”: không luôn đúng. Dữ liệu tốt vẫn cho kết quả sai nếu xử lý sai, như lỗi công thức bảng tính kể trên.
Câu hỏi thường gặp
GIGO là gì?
GIGO là viết tắt của “garbage in, garbage out”, nghĩa là “rác vào, rác ra”: kết quả của một hệ thống không thể tốt hơn chất lượng dữ liệu đưa vào nó.
Ai đặt ra cụm từ garbage in, garbage out?
Chưa xác định chắc chắn. Bản in sớm nhất được biết đến là bài trên Hammond Times ngày 10/11/1957. George Fuechsel của IBM hay được nhắc tới, nhưng mốc ông dùng cụm từ (khoảng 1958–1959) muộn hơn.
Dữ liệu rác là gì?
Là dữ liệu không đủ chất lượng cho mục đích sử dụng: sai, thiếu, trùng, không nhất quán, lỗi thời, nhãn sai hoặc thiên lệch.
Bao nhiêu phần trăm nhãn sai là chấp nhận được?
Không có con số chung. Ngưỡng tuỳ rủi ro: mô hình gợi ý sản phẩm chịu lỗi tốt hơn mô hình hỗ trợ chẩn đoán y khoa. Hãy đo tỷ lệ lỗi bằng mẫu vàng rồi thử độ nhạy của mô hình với mức lỗi đó.
Làm sạch dữ liệu có loại bỏ được GIGO không?
Làm sạch xử lý tốt lỗi sai, trùng, sai định dạng. Nhưng nó khó sửa dữ liệu thiên lệch hay thiếu cả một nhóm đối tượng, vì phần thiếu không có trong dữ liệu. Chặn rác từ khâu thu thập vẫn hiệu quả nhất.
GIGO có đúng với AI tạo sinh không?
Có. Mô hình ngôn ngữ lớn học từ dữ liệu, nên sai lệch trong dữ liệu hiện ra trong câu trả lời. Đưa tài liệu sai làm ngữ cảnh cho chatbot, nó sẽ trả lời trôi chảy dựa trên tài liệu sai đó.