
Trả lời nhanh: Data annotation (gán nhãn dữ liệu, ghi nhãn dữ liệu) là việc gắn thông tin mô tả lên dữ liệu thô như ảnh, văn bản, âm thanh, video để mô hình AI học được. Nhãn là “đáp án” mà máy dùng để học cách tự đưa ra câu trả lời đúng với dữ liệu mới.
Điểm chính
- Nhãn tạo ra “đáp án chuẩn” (ground truth) cho học có giám sát, cách phần lớn mô hình AI được huấn luyện.
- Data annotation và data labeling thường được dùng thay cho nhau.
- Mỗi loại dữ liệu có kỹ thuật riêng: bounding box, polygon cho ảnh; NER, cảm xúc cho văn bản; phiên âm cho giọng nói; cuboid cho LiDAR.
- Chất lượng nhãn đo bằng độ đồng thuận giữa người gán, IoU và bộ mẫu chuẩn.
- Data annotator là nghề có lộ trình: người gán nhãn, kiểm duyệt, trưởng nhóm, chuyên gia đánh giá mô hình ngôn ngữ.
Mục lục
- Data annotation là gì?
- Vì sao AI cần dữ liệu được gán nhãn?
- Data annotation và data labeling có khác nhau không?
- Các loại gán nhãn dữ liệu phổ biến
- Quy trình gán nhãn dữ liệu gồm những bước nào?
- Làm sao đo chất lượng nhãn?
- Gán nhãn thủ công, bán tự động, human-in-the-loop và RLHF khác nhau thế nào?
- Công cụ gán nhãn dữ liệu nào phổ biến?
- Nên tự gán nhãn hay thuê ngoài?
- Data annotator là gì? Công việc, kỹ năng và lộ trình nghề
- Bảo mật và quyền riêng tư khi gán nhãn dữ liệu
- Những hiểu lầm phổ biến về gán nhãn dữ liệu
- Câu hỏi thường gặp
Data annotation là gì?
Data annotation, tiếng Việt gọi là gán nhãn dữ liệu, ghi nhãn dữ liệu hay chú thích dữ liệu, là quá trình gắn thông tin có ý nghĩa vào dữ liệu thô để máy tính hiểu dữ liệu đó “là gì”. Thông tin được gắn vào gọi là nhãn (label). Bảng thuật ngữ học máy của Google định nghĩa nhãn là phần “đáp án” của một mẫu trong học có giám sát.
Ví dụ đời thường: bạn dạy trẻ nhận biết con vật bằng sách tranh. Mỗi trang có hình con mèo và chữ “mèo”. Hình là dữ liệu, chữ là nhãn. Xem đủ nhiều trang, trẻ tự nhận ra con mèo trong ảnh mới. Gán nhãn dữ liệu làm đúng việc đó, chỉ khác “học sinh” là mô hình AI và “sách tranh” có thể lên tới hàng trăm nghìn ảnh.
Vì sao AI cần dữ liệu được gán nhãn?
Phần lớn ứng dụng trí tuệ nhân tạo (AI) quen thuộc, từ lọc thư rác đến nhận diện khuôn mặt, dựa trên học có giám sát (supervised learning): huấn luyện mô hình từ các mẫu đã có nhãn. Mô hình so dự đoán của nó với nhãn rồi tự điều chỉnh cho tới khi khớp ở mức chấp nhận được.
IBM xếp gán nhãn vào giai đoạn tiền xử lý khi phát triển mô hình học máy. Bộ nhãn đúng vừa là chuẩn để huấn luyện, vừa là thước đo kiểm tra mô hình. Nhãn sai thì mô hình học sai, dù thuật toán tốt đến đâu. Hiện tượng này được tóm gọn bằng câu garbage in, garbage out (rác vào, rác ra).
Data annotation và data labeling có khác nhau không?
Trong hầu hết tài liệu và tin tuyển dụng, hai từ được dùng như nhau. IBM viết “data labeling, or data annotation”, tức coi là một. Một số đội kỹ thuật vẫn tách nhẹ theo mức độ chi tiết:
| Tiêu chí | Data labeling | Data annotation |
|---|---|---|
| Trọng tâm | Gắn thẻ phân loại cho cả mẫu | Mô tả chi tiết bên trong mẫu: vị trí, đường viền, thuộc tính |
| Ví dụ ảnh | Ảnh “có xe máy” | Vẽ khung quanh từng xe máy, ghi màu, bị che hay không |
| Đầu ra | Bảng tên tệp kèm nhãn | Tệp JSON, XML theo định dạng COCO, YOLO, Pascal VOC |
Khi đọc yêu cầu dự án, bạn nên xem họ cần loại nhãn gì cụ thể thay vì dựa vào chữ “labeling” hay “annotation”.
Các loại gán nhãn dữ liệu phổ biến
Gán nhãn hình ảnh
- Phân loại ảnh: một nhãn cho cả ảnh, ví dụ “có khói” hoặc “không có khói”.
- Khung chữ nhật (bounding box): bao quanh từng đối tượng. Nhanh, phù hợp bài toán phát hiện vật thể như đếm xe.
- Đa giác (polygon): chấm điểm theo đường viền, chính xác hơn với vật hình dạng bất thường như vết nứt, mái nhà.
- Phân vùng (segmentation): gán nhãn tới từng điểm ảnh. Phân vùng ngữ nghĩa gom mọi điểm “đường” thành một vùng; phân vùng thực thể tách riêng từng chiếc xe.
- Điểm mốc, khung xương (keypoint, skeleton): đánh dấu khớp, mắt, mũi để nhận diện tư thế, khuôn mặt.
Gán nhãn video
Ngoài vẽ khung từng khung hình, người gán nhãn phải theo dõi đối tượng (object tracking), giữ nguyên mã định danh của cùng một xe từ đầu đến cuối, và đánh dấu sự kiện theo thời gian như thời điểm va chạm.
Gán nhãn văn bản
- Phân loại văn bản: thư rác hay không, yêu cầu thuộc phòng ban nào.
- Nhận dạng thực thể có tên (NER): đánh dấu tên người, tổ chức, địa điểm, ngày tháng, số tiền.
- Cảm xúc (sentiment) và ý định (intent): tích cực hay tiêu cực; “đổi giúp mình gói cước” có ý định “đổi dịch vụ”.
- Hiệu đính kết quả nhận dạng chữ: so văn bản do OCR (nhận dạng ký tự quang học) đọc ra với ảnh gốc, sửa lỗi dấu tiếng Việt.
Gán nhãn âm thanh, giọng nói
Gồm phiên âm lời nói thành chữ, đánh dấu ai nói đoạn nào (speaker diarization) và phân loại âm thanh như còi xe, kính vỡ. Với tiếng Việt, người gán còn xử lý giọng vùng miền và lời nói xen tiếng Anh.
Gán nhãn dữ liệu 3D, LiDAR
Cảm biến LiDAR tạo đám mây điểm (point cloud) mô tả không gian ba chiều. Người gán vẽ khối hộp 3D (cuboid) quanh ô tô, người đi bộ, hoặc phân vùng từng điểm thuộc mặt đường, vỉa hè. Khi kết hợp camera và LiDAR, nhãn 2D và 3D phải khớp nhau.
| Loại dữ liệu | Kỹ thuật chính | Ứng dụng ví dụ |
|---|---|---|
| Hình ảnh | Phân loại, bounding box, polygon, segmentation, keypoint | Phát hiện lỗi sản phẩm, đọc ảnh y khoa, đếm hàng trên kệ |
| Video | Theo dõi đối tượng, gán nhãn sự kiện | Camera an ninh, giám sát giao thông |
| Văn bản | Phân loại, NER, cảm xúc, ý định | Chatbot chăm sóc khách hàng, phân tích đánh giá |
| Âm thanh | Phiên âm, tách người nói, phân loại âm | Trợ lý giọng nói, tổng đài tự động |
| 3D, LiDAR | Cuboid 3D, phân vùng đám mây điểm | Xe tự hành, robot kho, bản đồ số |
Quy trình gán nhãn dữ liệu gồm những bước nào?
Phần lớn chất lượng được quyết định trước khi ai đó bắt đầu vẽ khung đầu tiên.
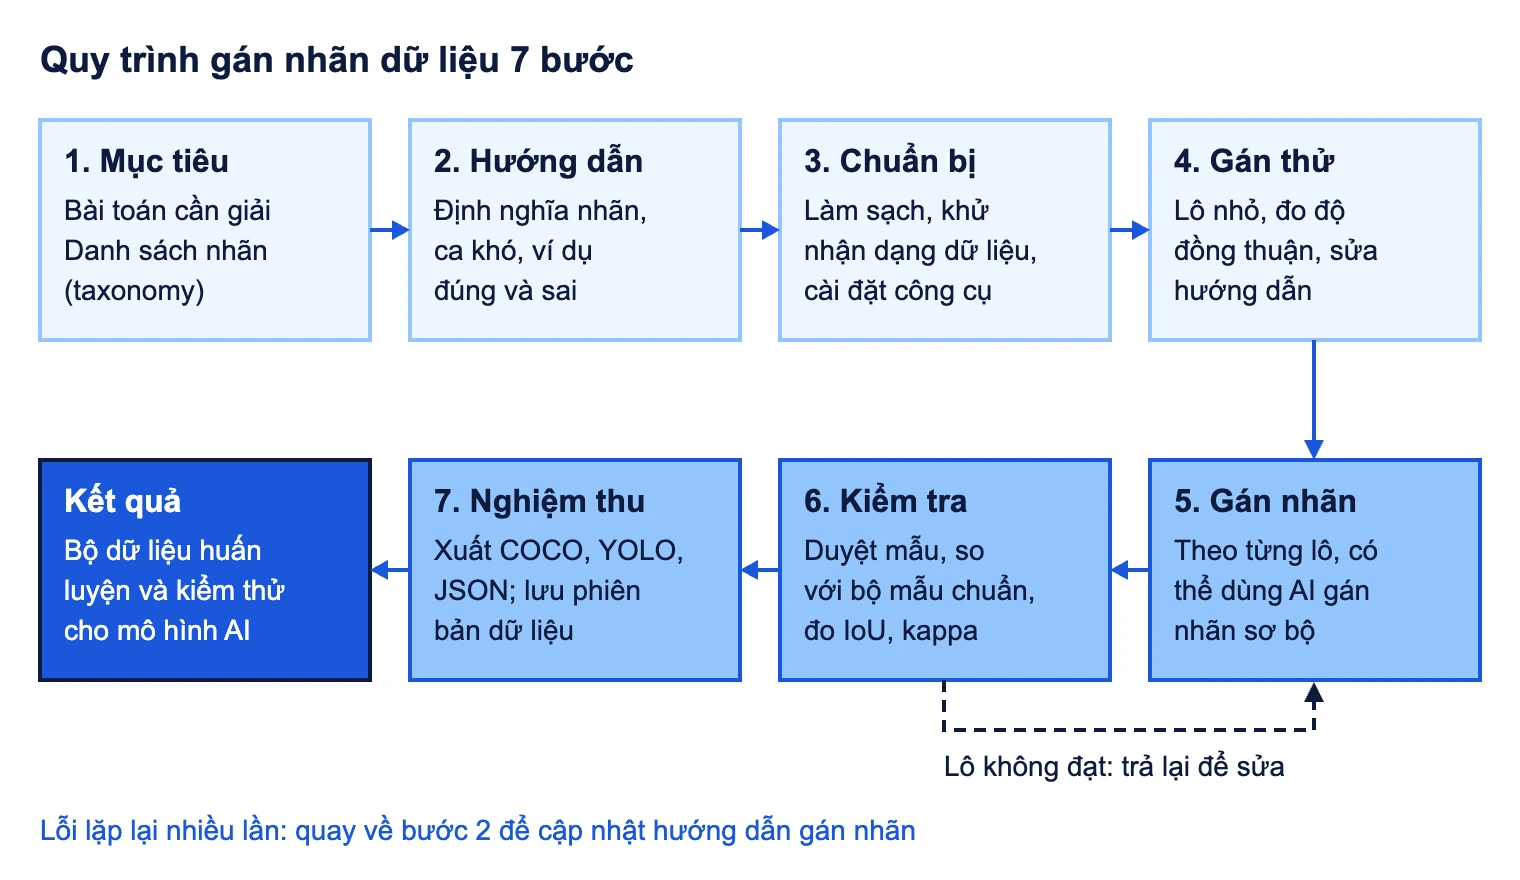
- Xác định mục tiêu và bộ nhãn. Mô hình cần phát hiện, phân loại hay trích xuất? Từ đó chốt danh sách nhãn (taxonomy), loại hình vẽ và thuộc tính.
- Viết hướng dẫn gán nhãn (guideline). Tài liệu quan trọng nhất của dự án: định nghĩa từng nhãn, ví dụ đúng, ví dụ sai, cách xử lý ca khó như vật bị che một nửa hay câu mỉa mai.
- Chuẩn bị dữ liệu và công cụ. Loại mẫu trùng, hỏng; khử nhận dạng thông tin cá nhân không cần thiết; cấu hình công cụ và phân quyền.
- Gán thử. Vài người cùng gán một lô nhỏ, đo độ đồng thuận, sửa chỗ hướng dẫn còn mơ hồ. Bỏ qua bước này là lý do phổ biến khiến dự án phải làm lại.
- Gán nhãn hàng loạt theo lô, theo dõi năng suất và tỷ lệ lỗi; có thể cho mô hình gán sơ bộ để người chỉnh sửa.
- Kiểm tra chất lượng. Người kiểm duyệt (reviewer) xem lại mẫu, so với bộ mẫu chuẩn (gold set); lô không đạt bị trả lại.
- Nghiệm thu, bàn giao. Xuất nhãn theo định dạng mô hình cần, ghi phiên bản bộ dữ liệu và hướng dẫn đã dùng.
Quản lý phiên bản dữ liệu và tự động hoá luồng giữa các bước thuộc phạm vi của DataOps.
Làm sao đo chất lượng nhãn?
Chất lượng phải đo được bằng con số. Phần này chỉ giải thích khái niệm; ngưỡng cụ thể do từng dự án đặt.
Độ chính xác so với bộ mẫu chuẩn
Chuyên gia gán trước một tập mẫu làm đáp án, trộn ngẫu nhiên vào việc hằng ngày. Tỷ lệ khớp đáp án cho biết độ chính xác của từng người, từng lô.
Độ đồng thuận giữa người gán nhãn
Google gọi là inter-rater agreement: mức độ các người đánh giá đồng ý với nhau khi gán cùng một mẫu. Tỷ lệ trùng khớp đơn thuần dễ “đẹp giả” khi một nhãn chiếm đa số. Vì vậy người ta dùng Cohen’s kappa cho hai người gán. Theo tài liệu thư viện scikit-learn, kappa so mức đồng thuận quan sát được với mức kỳ vọng do ngẫu nhiên, cho giá trị từ -1 đến 1: bằng 1 là đồng thuận hoàn toàn, bằng 0 là không hơn đoán bừa. Với nhiều người gán, có Fleiss’ kappa hoặc Krippendorff’s alpha.
Đồng thuận thấp thường do hướng dẫn mơ hồ chứ không chỉ do người gán kém. Đó là tín hiệu quay lại bước 2.
IoU cho nhãn hình ảnh
Với khung và vùng phân đoạn, vị trí cũng phải đúng. IoU (Intersection over Union) bằng diện tích phần giao chia diện tích phần hợp của hai khung. Tài liệu của Ultralytics mô tả IoU từ 0 đến 1, trong đó 1 là trùng khớp hoàn toàn.
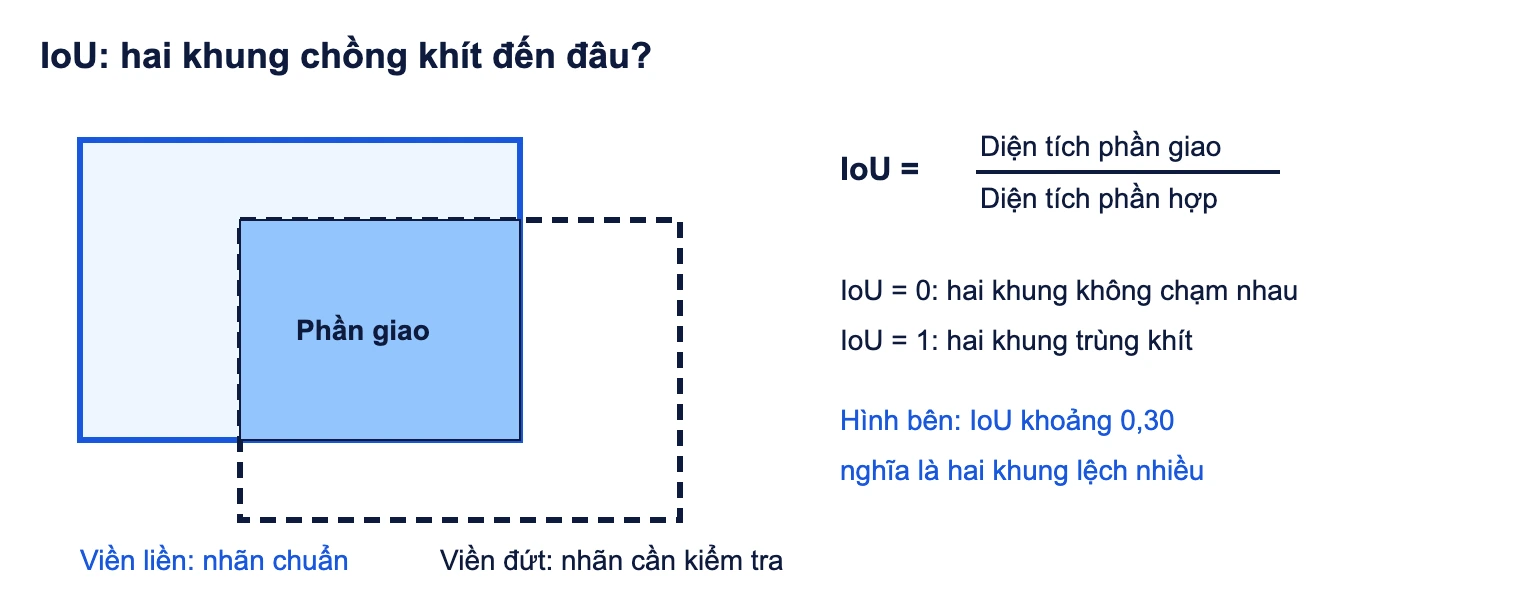
Ngưỡng IoU 0,5 thường dùng để coi một khung là “khớp” khi tính chỉ số mAP. Để tham khảo, tài liệu Amazon SageMaker Ground Truth cho biết tính năng gán nhãn tự động của dịch vụ này nhắm tới IoU trung bình 0,6 với bounding box và 0,7 với phân vùng ngữ nghĩa.
Gán nhãn thủ công, bán tự động, human-in-the-loop và RLHF khác nhau thế nào?
Thủ công và bán tự động
Gán nhãn thủ công: con người làm toàn bộ, cần khi dữ liệu đặc thù hoặc khi xây bộ mẫu chuẩn. Gán nhãn bán tự động (pre-labeling): mô hình có sẵn gán trước, người kiểm tra và sửa. Ví dụ, dự án Segment Anything của Meta AI công bố tháng 4/2023 đưa mô hình vào vòng thu thập dữ liệu để hỗ trợ người gán, tạo bộ dữ liệu hơn 1 tỷ mặt nạ phân vùng trên 11 triệu ảnh.
Human-in-the-loop
Con người trong vòng lặp: máy và người luân phiên làm phần mình giỏi. Tài liệu SageMaker Ground Truth mô tả cơ chế: mô hình học từ phần dữ liệu do người gán, tự gán mẫu nó đủ tự tin, chuyển mẫu có điểm tin cậy thấp cho người. Kỹ thuật chọn mẫu khó để người làm gọi là học chủ động (active learning).
RLHF cho mô hình ngôn ngữ lớn
Với chatbot, “nhãn” là đánh giá của con người về câu trả lời. Kỹ thuật này gọi là học tăng cường từ phản hồi của con người (RLHF). Bài báo InstructGPT của OpenAI (3/2022) mô tả: người gán nhãn viết câu trả lời mẫu để tinh chỉnh mô hình, rồi xếp hạng các câu trả lời của mô hình; dữ liệu xếp hạng dùng để tối ưu tiếp bằng học tăng cường. Theo bài báo, mô hình 1,3 tỷ tham số huấn luyện cách này được người đánh giá ưa chuộng hơn GPT-3 175 tỷ tham số.
| Cách làm | Vai trò con người | Rủi ro cần lưu ý |
|---|---|---|
| Thủ công | Làm toàn bộ | Chậm, mệt mỏi dẫn tới sai sót |
| Bán tự động | Sửa nhãn máy gợi ý | Dễ “chấp nhận cho nhanh” lỗi của máy |
| Human-in-the-loop | Xử lý ca máy không chắc | Ngưỡng tin cậy đặt sai làm lọt nhãn kém |
| RLHF | Viết mẫu, xếp hạng câu trả lời | Đánh giá chủ quan, cần kiểm duyệt chặt |
Công cụ gán nhãn dữ liệu nào phổ biến?
Tóm tắt từ tài liệu chính thức của từng công cụ, không phải xếp hạng hay khuyến nghị.
| Công cụ | Loại dữ liệu | Điểm đáng chú ý |
|---|---|---|
| CVAT | Ảnh, video, đám mây điểm 3D | Khung, đa giác, điểm, cuboid, khung xương, mặt nạ; có công cụ AI; xuất hơn 20 định dạng như COCO, YOLO. Bản Community mã nguồn mở (MIT), có bản trực tuyến và Enterprise. |
| Label Studio | Ảnh, âm thanh, văn bản, HTML, chuỗi thời gian, video | Kết nối mô hình để gán nhãn sơ bộ và học chủ động. Mã nguồn mở (Apache 2.0), có bản doanh nghiệp. |
| Amazon SageMaker Ground Truth | Ảnh, văn bản, video, đám mây điểm 3D | Gán nhãn tự động bằng học chủ động cho một số tác vụ; cần tối thiểu 1.250 mẫu, khuyến nghị từ 5.000. Dịch vụ đám mây có tính phí. |
Khi chọn, hãy hỏi: công cụ có đúng loại hình vẽ cần dùng; dữ liệu được phép lên đám mây hay phải lưu nội bộ; có kiểm duyệt nhiều cấp; xuất được định dạng mô hình cần; có nhật ký ai sửa nhãn nào không.
Nên tự gán nhãn hay thuê ngoài?
IBM liệt kê các cách tổ chức gán nhãn: nội bộ, thuê ngoài, crowdsourcing (chia việc nhỏ cho đông cộng tác viên), gán bằng chương trình và dữ liệu tổng hợp. Ba cách phổ biến nhất:
| Tiêu chí | Đội nội bộ | Thuê đơn vị chuyên | Crowdsourcing |
|---|---|---|---|
| Hiểu nghiệp vụ | Cao nhất | Cần thời gian đào tạo | Thấp, hợp việc đơn giản |
| Kiểm soát bảo mật | Dễ nhất | Phụ thuộc hợp đồng, quy trình | Khó, hạn chế với dữ liệu cá nhân |
| Mở rộng quy mô | Chậm | Nhanh, theo dự án | Rất nhanh |
| Chi phí cố định | Cao | Thấp | Thấp nhất |
Nhiều tổ chức kết hợp: đội nội bộ giữ hướng dẫn, bộ mẫu chuẩn và khâu nghiệm thu, phần khối lượng lớn giao đối tác theo mô hình thuê ngoài quy trình kinh doanh (BPO). Dù chọn cách nào, hướng dẫn và bộ mẫu chuẩn nên thuộc quyền của bạn.
Data annotator là gì? Công việc, kỹ năng và lộ trình nghề
Data annotator là người trực tiếp gán nhãn dữ liệu theo hướng dẫn dự án để tạo dữ liệu huấn luyện và kiểm thử cho AI. Tên gọi khác: data labeler, nhân viên gán nhãn dữ liệu. Với mô hình ngôn ngữ, vị trí tương tự thường gọi là AI trainer hoặc rater.
Công việc hằng ngày
- Đọc hướng dẫn và các cập nhật mới.
- Gán nhãn từng lô: vẽ khung, tô vùng, đánh dấu thực thể, phiên âm, xếp hạng câu trả lời.
- Đánh dấu ca không chắc để hỏi trưởng nhóm thay vì đoán.
- Sửa mẫu bị trả lại, ghi nhận loại lỗi của mình.
Kỹ năng cần có
- Tỉ mỉ, kiên trì: giữ độ chính xác qua hàng trăm mẫu giống nhau.
- Tuân thủ hướng dẫn: làm đúng định nghĩa dự án, kể cả khi trái cảm nhận cá nhân.
- Thành thạo máy tính: phím tắt, công cụ gán nhãn, bảng tính.
- Ngôn ngữ: tiếng Việt chuẩn chính tả; tiếng Anh đọc hiểu vì nhiều hướng dẫn viết bằng tiếng Anh.
- Chuyên môn (lợi thế): y khoa, luật, tài chính, lập trình, nhất là với dự án đánh giá mô hình ngôn ngữ.
- Ý thức bảo mật: không chụp màn hình, không sao chép dữ liệu ra ngoài.
Lộ trình phát triển
- Data annotator: đạt độ chính xác ổn định trên nhiều loại tác vụ.
- Reviewer, QA: kiểm duyệt nhãn, phân loại lỗi, đo chỉ số chất lượng.
- Trưởng nhóm, điều phối: chia việc, đào tạo người mới, làm việc với đội kỹ thuật.
- Thiết kế hướng dẫn và bộ nhãn: xây taxonomy, guideline, bộ mẫu chuẩn.
- Nhánh chuyên sâu: gán nhãn theo lĩnh vực, đánh giá mô hình ngôn ngữ, hoặc học thêm SQL, Python để chuyển sang vận hành, phân tích dữ liệu.
Ưu điểm: không bắt buộc bằng cấp công nghệ để bắt đầu, hiểu cách AI vận hành từ bên trong, nhiều dự án làm theo ca hoặc từ xa. Hạn chế: việc lặp lại, dễ mỏi mắt, khối lượng phụ thuộc dự án, tác vụ đơn giản đang được tự động hoá dần.
Lưu ý: bài không nêu mức lương vì chưa có thống kê đáng tin cậy về thu nhập nghề này tại Việt Nam. Hãy cảnh giác với tin tuyển “gán nhãn tại nhà” yêu cầu đặt cọc, mua khoá học hoặc nạp tiền để nhận việc.
Bảo mật và quyền riêng tư khi gán nhãn dữ liệu
Dữ liệu cần gán nhãn thường chứa thông tin cá nhân: khuôn mặt trong ảnh camera, giọng nói trong ghi âm tổng đài, họ tên trong văn bản. Gán nhãn vì thế là hoạt động xử lý dữ liệu cá nhân.
| Văn bản | Nội dung liên quan |
|---|---|
| Luật Bảo vệ dữ liệu cá nhân số 91/2025/QH15, thông qua ngày 26/06/2025, hiệu lực từ 01/01/2026 | Khoản 2 Điều 3: chỉ thu thập, xử lý dữ liệu cá nhân đúng phạm vi, mục đích cụ thể, rõ ràng. Điều 30: xử lý dữ liệu cá nhân trong dữ liệu lớn, trí tuệ nhân tạo, điện toán đám mây phải đúng mục đích, phạm vi cần thiết, có biện pháp bảo mật, xác thực, phân quyền; xử lý bằng AI phải phân loại theo mức độ rủi ro. Bên xử lý chỉ nhận dữ liệu sau khi có thoả thuận, hợp đồng với bên kiểm soát. |
| Nghị định 356/2025/NĐ-CP ngày 31/12/2025, hiệu lực từ 01/01/2026 | Hướng dẫn chi tiết luật, thay thế Nghị định 13/2023/NĐ-CP. Thoả thuận chuyển giao dữ liệu phải nêu mục đích, loại dữ liệu, thời hạn xử lý, trách nhiệm bảo vệ. |
Theo tài liệu giới thiệu luật, dữ liệu nhạy cảm gồm các nhóm như sức khoẻ, sinh trắc học, tài chính, vị trí. Vi phạm quy định chuyển dữ liệu xuyên biên giới có thể bị phạt tới 5% doanh thu năm trước liền kề; nhiều vi phạm khác tối đa 3 tỷ đồng với tổ chức. Điều này cần cân nhắc khi gửi dữ liệu cho đối tác nước ngoài hoặc dùng công cụ đặt máy chủ ở nước ngoài.
Biện pháp thực tế:
- Tối thiểu hoá: chỉ gửi phần dữ liệu cần cho nhiệm vụ.
- Khử nhận dạng: làm mờ khuôn mặt, biển số không cần gán; thay tên, số điện thoại bằng mã giả.
- Hợp đồng rõ ràng: mục đích, thời hạn lưu, nghĩa vụ xoá dữ liệu, quyền kiểm tra.
- Kiểm soát môi trường: phân quyền, chặn tải xuống, ghi nhật ký truy cập, cam kết bảo mật từng người.
Lưu ý: phần trên chỉ để định hướng. Với dữ liệu y tế, tài chính, sinh trắc học hoặc khi chuyển dữ liệu ra nước ngoài, hãy đối chiếu toàn văn luật, nghị định và hỏi bộ phận pháp chế.
Những hiểu lầm phổ biến về gán nhãn dữ liệu
- “Việc tay chân, ai cũng làm được”: thao tác dễ học, nhưng giữ độ chính xác trên khối lượng lớn hay đánh giá câu trả lời chuyên ngành cần kỹ năng thật.
- “AI sẽ tự gán nhãn hết”: AI gánh phần dễ; con người vẫn kiểm tra, xử lý ca khó, xây bộ mẫu chuẩn.
- “Càng nhiều dữ liệu càng tốt”: nhiều mà nhãn bẩn có thể tệ hơn ít mà nhãn sạch.
- “Kiểm tra ở cuối là đủ”: phát hiện lỗi hệ thống sau hàng chục nghìn mẫu nghĩa là làm lại hàng chục nghìn mẫu.
Câu hỏi thường gặp
Gán nhãn dữ liệu và ghi nhãn dữ liệu có phải là một?
Có. “Gán nhãn”, “gắn nhãn”, “ghi nhãn”, “chú thích dữ liệu” đều là cách dịch của data annotation hoặc data labeling.
Data annotator là gì?
Là người gán nhãn dữ liệu theo hướng dẫn dự án để tạo dữ liệu huấn luyện cho AI: vẽ khung trong ảnh, đánh dấu thực thể trong văn bản, phiên âm giọng nói, xếp hạng câu trả lời của chatbot.
Làm data annotator có cần biết lập trình không?
Không bắt buộc với vị trí khởi đầu. Biết thêm SQL, Python hoặc có chuyên môn giúp bạn nhận dự án khó hơn và mở đường sang mảng dữ liệu.
Data labeling dùng trong lĩnh vực nào?
Hầu hết lĩnh vực dùng AI: bán lẻ, sản xuất, y tế, giao thông, tài chính, chăm sóc khách hàng.
IoU trong gán nhãn dữ liệu là gì?
Là tỷ lệ diện tích phần giao trên phần hợp của hai khung, từ 0 đến 1, dùng để so khung người vẽ với khung chuẩn.
RLHF có phải là gán nhãn dữ liệu không?
Có thể xem là một dạng gán nhãn: con người viết câu trả lời mẫu và xếp hạng câu trả lời của mô hình ngôn ngữ để huấn luyện mô hình trả lời đúng ý hơn.
Gán nhãn dữ liệu có thông tin cá nhân cần lưu ý gì?
Tuân thủ Luật Bảo vệ dữ liệu cá nhân số 91/2025/QH15 và Nghị định 356/2025/NĐ-CP: xử lý đúng mục đích, khử nhận dạng khi có thể, ký thoả thuận với bên gán nhãn, kiểm soát truy cập.
Doanh nghiệp nhỏ nên bắt đầu thế nào?
Chốt một bài toán cụ thể, viết hướng dẫn một đến hai trang, dùng công cụ mã nguồn mở, cho hai người gán thử vài trăm mẫu để đo đồng thuận, sửa hướng dẫn rồi mới mở rộng.