
Trả lời nhanh: Quantization (lượng tử hoá mô hình) là kỹ thuật lưu trọng số của mô hình AI bằng ít bit hơn, ví dụ đổi số thực 16 bit thành số nguyên 8 hoặc 4 bit. Mô hình nhỏ hơn 2 đến 4 lần, cần ít VRAM hơn và thường chạy rẻ hơn, đổi lại có thể giảm nhẹ độ chính xác.
Điểm chính
- Quantization ánh xạ các số thực có độ chính xác cao sang tập giá trị rời rạc nhỏ hơn, kèm hệ số tỉ lệ (scale) để khôi phục gần đúng.
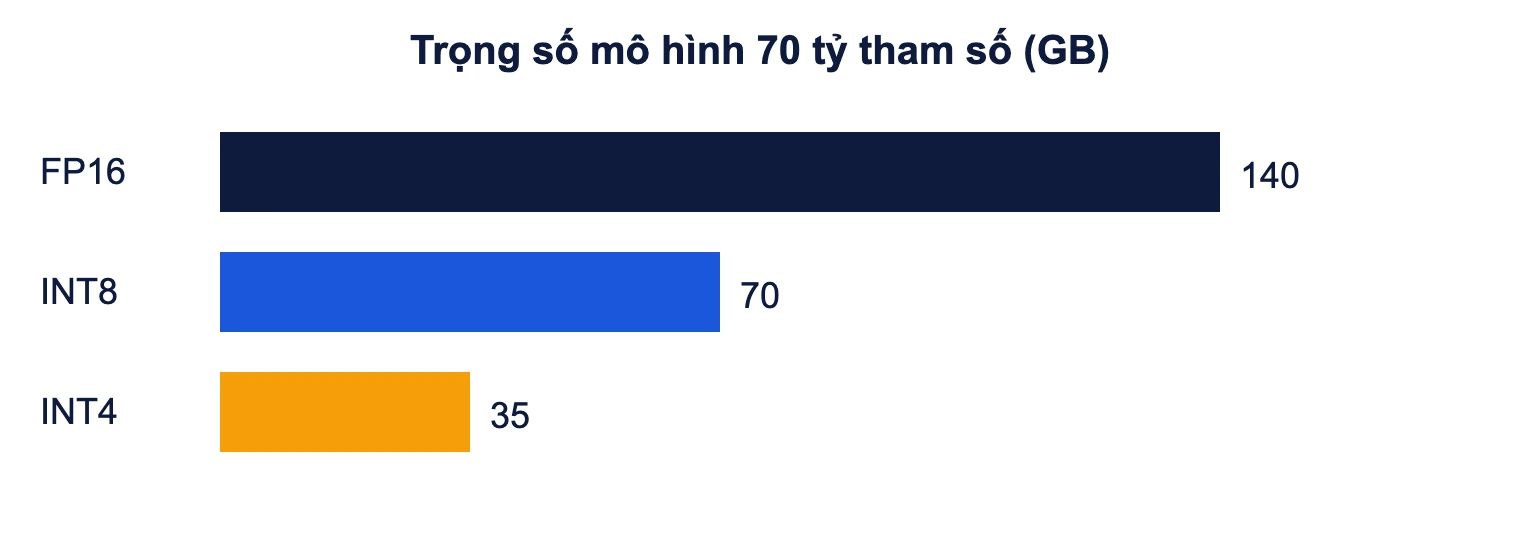
- Một mô hình 70 tỷ tham số cần khoảng 140 GB ở FP16, khoảng 70 GB ở INT8 và khoảng 35 GB ở INT4 (chỉ tính trọng số).
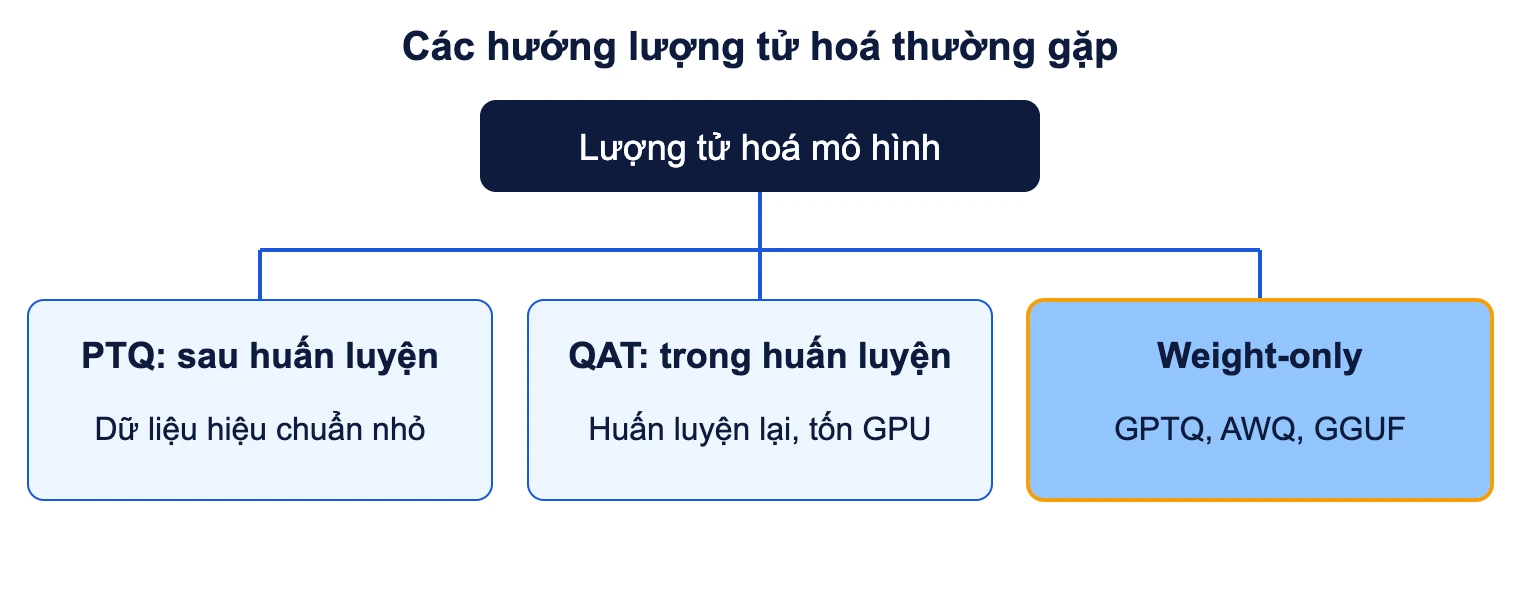
- PTQ làm sau huấn luyện, QAT đưa lượng tử hoá vào lúc huấn luyện. GPTQ, AWQ và GGUF là các cách làm PTQ phổ biến cho LLM.
- Chất lượng giảm không đều: tác vụ suy luận và toán thường nhạy hơn tóm tắt hay phân loại, nên phải kiểm trên dữ liệu của bạn.
Mục lục
- Quantization là gì?
- Quantization hoạt động thế nào?
- Lượng tử hoá giúp tiết kiệm bao nhiêu bộ nhớ?
- Các loại và định dạng lượng tử hoá thường gặp
- Ứng dụng của quantization cho doanh nghiệp Việt Nam
- Ưu điểm và nhược điểm
- Quantization khác gì distillation, pruning và fine-tuning?
- Khi nào nên và không nên lượng tử hoá?
- Cách chọn mức lượng tử hoá cho một dự án
- Lỗi thường gặp khi dùng mô hình đã lượng tử hoá
- Câu hỏi thường gặp
Quantization là gì?
Quantization, tiếng Việt gọi là lượng tử hoá (hoặc lượng tử hóa) mô hình, là quá trình ánh xạ các giá trị từ một tập số thực lớn sang một tập nhỏ hơn và rời rạc. Cách hiểu này xuất phát từ định nghĩa chung của lượng tử hoá trong xử lý tín hiệu. Với mô hình AI, đối tượng bị làm tròn là các tham số (trọng số, weight) và đôi khi cả giá trị trung gian khi tính toán (kích hoạt, activation).
Mô hình sau huấn luyện thường lưu trọng số ở BF16 hoặc FP16, tức 2 byte mỗi tham số. INT8 dùng 1 byte mỗi tham số nên giảm một nửa VRAM, còn INT4 dùng nửa byte nên giảm còn một phần tư. Kết quả là cùng một mô hình ngôn ngữ lớn (LLM) có thể nằm vừa trên GPU nhỏ hơn, hoặc chạy trên máy tính cá nhân.
Lưu ý tên gọi: “quantization” ở đây không liên quan đến máy tính lượng tử (quantum computing). Hai khái niệm chỉ trùng từ “lượng tử” khi dịch sang tiếng Việt.
Quantization hoạt động thế nào?
Ý tưởng cốt lõi là thay một số thực bằng một số nguyên nhỏ cộng với một hệ số tỉ lệ dùng chung cho cả nhóm số. Khi cần tính, hệ thống nhân ngược lại để lấy giá trị xấp xỉ, bước này gọi là giải lượng tử hoá (dequantization).
Ví dụ minh hoạ bằng số
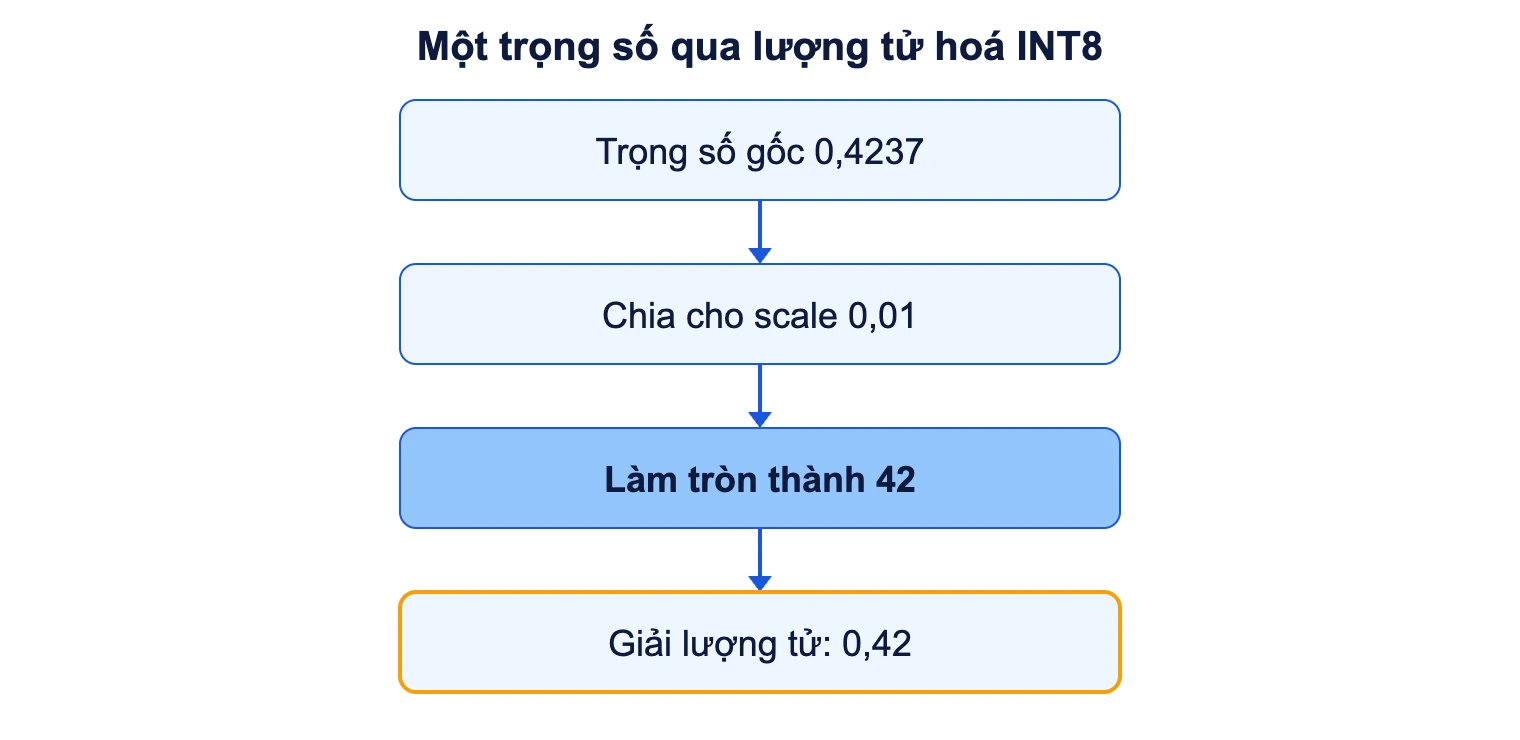
Giả sử một nhóm trọng số có giá trị tuyệt đối lớn nhất là 1,27 và bạn lượng tử hoá đối xứng sang INT8 (khoảng -128 đến 127). Hệ số tỉ lệ là 1,27 chia 127, bằng 0,01. Trọng số 0,4237 chia 0,01 được 42,37, làm tròn thành 42. Khi dùng, 42 nhân 0,01 ra 0,42. Sai lệch là 0,0037, rất nhỏ so với giá trị gốc. (Đây là ví dụ minh hoạ, không phải số đo từ một mô hình thật.)
Vì sao phải chia nhóm (block, group)
Nếu một nhóm có một giá trị ngoại lai lớn, hệ số tỉ lệ bị kéo lên và các giá trị nhỏ còn lại mất độ phân giải. Ví dụ minh hoạ: nhóm có một trọng số 12,7 thì scale INT8 là 0,1, và trọng số 0,4237 bị làm tròn thành 4 rồi trở về 0,4, sai lệch gấp hơn sáu lần ví dụ trên. Vì vậy các phương pháp thực tế chia trọng số thành khối nhỏ. Chẳng hạn mỗi khối khoảng 64 phần tử được chuẩn hoá độc lập bằng cách chia cho giá trị tuyệt đối lớn nhất của khối. Cách này hạn chế ảnh hưởng của ngoại lai, nhưng mỗi khối phải lưu thêm một hệ số, nên mô hình “4-bit” thực tế nặng hơn 0,5 byte mỗi tham số một chút.
Lượng tử hoá giúp tiết kiệm bao nhiêu bộ nhớ?
Phép tính cơ bản: dung lượng trọng số bằng số tham số nhân số byte mỗi tham số. Mô hình 70 tỷ tham số ở BF16 chiếm khoảng 140 GB. Từ đó suy ra INT8 khoảng 70 GB và INT4 khoảng 35 GB, chưa tính phần hệ số tỉ lệ. Các nguồn thực hành thường ghi INT4 trong khoảng 35 đến 45 GB cho mô hình cỡ này, tuỳ định dạng và cách tính phụ phí.
Với mô hình nhỏ hơn, một tài liệu thực hành của Cast AI cho thấy mô hình 7B cần khoảng 14 GB ở fp16, khoảng 7 GB ở int8 và khoảng 4 GB ở Q4. Nhờ đó mô hình 7B có thể chạy trên laptop có GPU phổ thông hoặc thậm chí chỉ bằng CPU, chậm hơn nhưng dùng được.
Con số trên chỉ là trọng số. Khi chạy thật bạn còn cần bộ nhớ cho KV cache (bộ nhớ đệm của cơ chế attention, tăng theo độ dài hội thoại và số yêu cầu chạy song song) và bộ nhớ làm việc. Nguồn của Cast AI cũng lưu ý mô hình 70B ở fp16 cần thêm dư địa cho KV cache và batching khi chạy production. Muốn biết phần này, hãy xem cửa sổ ngữ cảnh bạn định dùng.
Các loại và định dạng lượng tử hoá thường gặp
Theo thời điểm: PTQ và QAT
Lượng tử hoá sau huấn luyện (post-training quantization, PTQ) áp dụng lên mô hình đã huấn luyện xong, thường chỉ cần một tập dữ liệu hiệu chuẩn nhỏ để ước lượng phân bố giá trị. Lượng tử hoá có nhận biết khi huấn luyện (quantization-aware training, QAT) mô phỏng sai số làm tròn ngay trong lúc huấn luyện. QAT giúp mô hình thích nghi tốt hơn với mất mát độ chính xác. Cái giá là phải huấn luyện lại, cần dữ liệu và GPU. Với LLM mã nguồn mở có sẵn, PTQ là lựa chọn gần như mặc định.
Theo đối tượng: chỉ trọng số hay cả kích hoạt
Nhiều bộ máy suy luận ưu tiên lượng tử hoá riêng trọng số. Lý do là trọng số chiếm phần lớn bộ nhớ của mô hình, còn kích hoạt được giữ ở độ chính xác cao hơn như FP16 hoặc BF16 khi tính toán để hạn chế mất chất lượng. Cách lượng tử hoá cả trọng số và kích hoạt (ví dụ W8A8) khó hơn nhưng tận dụng được phép nhân số nguyên trên phần cứng, nên có thể tăng tốc tính toán chứ không chỉ tiết kiệm bộ nhớ.
GPTQ, AWQ, GGUF khác nhau thế nào
| Tiêu chí | GPTQ | AWQ | GGUF (llama.cpp) |
|---|---|---|---|
| Bản chất | PTQ một lượt, tinh chỉnh từng lớp dựa trên dữ liệu hiệu chuẩn | PTQ nhận biết kích hoạt, bảo vệ nhóm trọng số quan trọng | Định dạng tệp kèm nhiều mức lượng tử hoá (Q4_K_M, Q5_K_M, Q8_0…) |
| Hướng dùng chính | Mô hình đã lượng tử hoá có sẵn, chạy trên GPU | Phục vụ GPU qua vLLM, SGLang | Máy cá nhân, CPU hoặc CPU kết hợp GPU, Ollama |
| Độ linh hoạt | Cố định theo cấu hình lúc tạo | Cố định theo cấu hình lúc tạo | Có thể đẩy bớt lớp sang RAM |
| Cần dữ liệu hiệu chuẩn | Có | Có, ít | Tuỳ biến thể |
Về chất lượng, một hướng dẫn triển khai năm 2026 báo cáo AWQ INT4 giảm chất lượng khoảng 1 đến 3% so với BF16, còn GPTQ INT4 khoảng 2 đến 5%. Các bảng so sánh của những trang khác nhau cho số khác nhau vì chọn mô hình, bộ đo và cách tính khác nhau. Bạn nên coi đó là thứ tự tương đối, không phải cam kết cho mô hình của mình. Về nguồn gốc, AWQ dựa trên quan sát rằng chỉ cần bảo vệ khoảng 1% trọng số quan trọng là có thể lượng tử hoá 4-bit gần như không mất chất lượng.
Ứng dụng của quantization cho doanh nghiệp Việt Nam
- Chạy mô hình tại chỗ (on-premise). Doanh nghiệp không muốn gửi hợp đồng, hồ sơ nhân sự hay dữ liệu khách hàng ra dịch vụ đám mây có thể chạy mô hình LLM mã nguồn mở bản đã lượng tử hoá trên một máy chủ GPU duy nhất. Việc giữ dữ liệu trong hệ thống của mình giúp bạn kiểm soát nơi lưu trữ dễ hơn.
- Giảm số GPU khi phục vụ nội bộ. Theo phép tính ở trên, mô hình 70B ở FP16 cần nhiều GPU 40 GB, trong khi bản INT4 có thể vừa một GPU 80 GB. Một chatbot hỏi đáp nội bộ có tải thấp thường không cần nhiều hơn.
- Thiết bị biên và máy cá nhân. Mô hình nhỏ đã lượng tử hoá chạy trên laptop nhân viên hoặc máy tại cửa hàng, hữu ích khi mạng chập chờn hoặc cần độ trễ thấp.
- Thử nghiệm nhanh nhiều mô hình. Bản lượng tử hoá tải về nhanh hơn, cho phép đội kỹ thuật so sánh vài mô hình trước khi chọn.
Ví dụ minh hoạ: một công ty luật muốn trợ lý nội bộ tóm tắt hồ sơ vụ việc mà không đưa dữ liệu ra ngoài. Đội IT tải cùng một mô hình ở INT8 và INT4, cho cả hai tóm tắt 50 hồ sơ cũ đã có bản tóm tắt chuẩn của luật sư, rồi chấm sai sót về tên, số tiền và ngày tháng. Nếu INT4 chỉ sai ở văn phong mà không sai dữ kiện thì phương án rẻ hơn dùng được. Nếu sai dữ kiện nhiều hơn, họ dùng INT8 hoặc mô hình nhỏ hơn ở độ chính xác cao.
Ưu điểm và nhược điểm
| Ưu điểm | Nhược điểm |
|---|---|
| Giảm VRAM và dung lượng lưu trữ 2 đến 4 lần cho phần trọng số | Có thể giảm chất lượng, rõ nhất ở suy luận nhiều bước, toán và mã nguồn |
| Chạy được trên phần cứng rẻ hơn hoặc ít GPU hơn | Không giảm KV cache nếu chỉ lượng tử hoá trọng số |
| Giảm băng thông bộ nhớ, thường giúp sinh token nhanh hơn | Tốc độ thực tế phụ thuộc kernel và phần cứng hỗ trợ, có thể không nhanh hơn |
| Không cần huấn luyện lại với PTQ | Khó tái tạo kết quả nếu đổi công cụ, phiên bản hoặc dữ liệu hiệu chuẩn |
Một nguồn thực hành nhận xét INT4 làm giảm chất lượng rõ ở tác vụ suy luận phức tạp và toán, nhưng vẫn chấp nhận được với tóm tắt, phân loại và hoàn thiện mã. Nhận định này khớp với kinh nghiệm chung, song bạn vẫn phải thử trên dữ liệu thật. Tên đẹp của một định dạng không bảo đảm đạt yêu cầu của bạn.
Lượng tử hoá cũng không sửa lỗi bịa thông tin của mô hình, và có thể làm vấn đề này tệ hơn một chút ở tác vụ khó. Nếu bạn lo về điều này, hãy đọc thêm về ảo giác AI và cách giảm.
Quantization khác gì distillation, pruning và fine-tuning?
Bốn kỹ thuật dễ bị nhầm vì đều nhằm làm mô hình gọn hơn hoặc phù hợp hơn.
| Kỹ thuật | Thay đổi gì | Cần huấn luyện | Kết quả chính |
|---|---|---|---|
| Quantization | Số bit của tham số | Không với PTQ, có với QAT | Cùng kiến trúc, ít bộ nhớ hơn |
| Distillation | Tạo mô hình nhỏ học theo mô hình lớn | Có | Kiến trúc mới, ít tham số hơn |
| Pruning (cắt tỉa) | Loại bớt trọng số hoặc cấu trúc ít quan trọng | Thường cần tinh chỉnh lại | Mô hình thưa hoặc nhỏ hơn |
| Fine-tuning | Cập nhật trọng số cho nhiệm vụ cụ thể | Có | Đổi hành vi, không nhằm giảm kích thước |
Cách làm gọn bằng chưng cất mô hình cho ra một mô hình mới, còn quantization giữ nguyên kiến trúc. Hai cách có thể kết hợp: chưng cất xuống mô hình nhỏ, rồi lượng tử hoá bản đó. Nếu mục tiêu là có sẵn mô hình gọn từ đầu, hãy xem thêm về mô hình ngôn ngữ nhỏ.
Quantization còn xuất hiện trong tinh chỉnh. Trong QLoRA, trọng số nền được lượng tử hoá theo khối xuống 4-bit để tiết kiệm bộ nhớ khi huấn luyện, còn phần bổ sung nhỏ vẫn được huấn luyện ở độ chính xác cao hơn. Chi tiết nằm ở bài QLoRA. Nếu bạn muốn hiểu bức tranh tinh chỉnh nói chung, xem bài fine-tuning.
Khi nào nên và không nên lượng tử hoá?
Nên cân nhắc khi
- Mô hình không vừa GPU hiện có ở FP16 nhưng vừa ở INT8 hoặc INT4.
- Tác vụ có đáp án kiểm được, như phân loại phiếu hỗ trợ, trích xuất trường từ hoá đơn, tóm tắt, nên bạn đo được chênh lệch giữa bản gốc và bản lượng tử hoá.
- Cần chạy trên máy cá nhân hoặc thiết bị biên.
Nên thận trọng hoặc tránh khi
- Tác vụ cần suy luận nhiều bước, tính toán số học hoặc sinh mã quan trọng mà chưa có bộ kiểm thử.
- Bạn có đủ ngân sách GPU. Nguồn của VRLA Tech chẳng hạn ghi rằng với hai GPU 96 GB, nhiều tải công việc 70B không cần lượng tử hoá. Khi đó dùng độ chính xác cao hơn loại bỏ một biến số rủi ro.
- Nút thắt thật nằm ở KV cache, tức hội thoại dài hoặc nhiều người dùng đồng thời. Lượng tử hoá trọng số một mình không giải quyết được.
Chạy lại cùng một bộ câu hỏi nội bộ trên bản gốc và bản lượng tử hoá cho kết quả sát hơn các bảng điểm công khai. Về cách đọc điểm công khai, xem bài benchmark LLM.
Cách chọn mức lượng tử hoá cho một dự án
- Tính bộ nhớ trước. Lấy số tham số nhân số byte (2, 1, 0,5), cộng khoảng dư cho hệ số tỉ lệ, KV cache và bộ nhớ làm việc. Với mô hình 70B INT4, dư địa trên GPU 80 GB còn lại rất khác so với GPU 48 GB.
- Chọn định dạng theo nơi chạy. GGUF hợp với Ollama hoặc llama.cpp trên máy cá nhân. AWQ hoặc GPTQ hợp với phục vụ trên GPU qua các engine như vLLM. FP8 hoặc INT8 là lựa chọn an toàn hơn khi phần cứng hỗ trợ tốt.
- Dùng dữ liệu hiệu chuẩn giống dữ liệu thật. PTQ như GPTQ và AWQ dựa vào mẫu hiệu chuẩn. Nếu bạn dùng văn bản tiếng Việt chuyên ngành, mẫu hiệu chuẩn toàn tiếng Anh chung chung có thể làm chất lượng tiếng Việt kém hơn mức công bố. Đây là rủi ro hợp lý cần kiểm, không phải kết luận đã đo.
- Kiểm riêng tiếng Việt và định dạng đầu ra. Nhiều thử nghiệm công khai tập trung vào tiếng Anh. Hãy kiểm lỗi dấu, tên riêng, đầu ra JSON và độ dài câu trả lời.
- So sánh ít nhất hai mức. Ví dụ INT8 và INT4 trên cùng bộ câu hỏi, cùng nhiệt độ sinh (xem bài temperature) để chênh lệch đến từ độ chính xác, không phải từ ngẫu nhiên.
- Ghi lại phiên bản. Lưu tên mô hình gốc, công cụ lượng tử hoá, phiên bản, cấu hình bit và nhóm, cùng tập hiệu chuẩn để tái tạo được khi nâng cấp.
Lỗi thường gặp khi dùng mô hình đã lượng tử hoá
- Nhầm kích thước tệp với nhu cầu VRAM. Tệp 40 GB không có nghĩa chạy được trong 40 GB VRAM, vì còn KV cache và bộ nhớ đệm của engine.
- Kỳ vọng nhanh hơn tự động. Lượng tử hoá giảm băng thông bộ nhớ, nhưng nếu kernel phần cứng không hỗ trợ định dạng đó, bước giải lượng tử hoá có thể làm chậm. Hãy đo tốc độ trên máy của bạn.
- Tải bản lượng tử hoá không rõ nguồn. Mô hình cộng đồng đã lượng tử hoá có thể bị cấu hình sai hoặc chỉnh sửa. Ưu tiên nguồn chính thức hoặc tự lượng tử hoá từ bản gốc có kiểm tra giá trị băm (hash), và quét tệp trước khi chạy trong môi trường có dữ liệu nhạy cảm.
- So sánh khác điều kiện. Đổi cả định dạng lẫn tham số sinh cùng lúc làm bạn không biết sai lệch đến từ đâu.
- Lượng tử hoá quá thấp cho mô hình nhỏ. Mô hình càng ít tham số càng ít dư thừa, nên 3-bit hoặc 2-bit thường gây giảm chất lượng rõ rệt hơn so với mô hình lớn.
Câu hỏi thường gặp
Quantization là gì, nói ngắn gọn?
Đó là kỹ thuật dùng ít bit hơn để lưu các tham số của mô hình AI, như đổi FP16 thành INT8 hoặc INT4. Mô hình nhỏ hơn và cần ít bộ nhớ hơn, đổi lại có thể mất một phần độ chính xác.
Lượng tử hoá có làm mô hình kém đi nhiều không?
Không có con số chung. Mức mất chất lượng phụ thuộc vào mô hình, số bit, phương pháp và tác vụ. INT8 thường được xem là gần với bản gốc, còn INT4 dễ lộ yếu ở suy luận và toán hơn. Hãy đo trên dữ liệu và tác vụ của bạn, nhất là tiếng Việt.
Lượng tử hoá khác fine-tuning thế nào?
Quantization đổi cách lưu số của mô hình để nhẹ hơn, không dạy mô hình điều mới. Fine-tuning cập nhật trọng số để mô hình làm tốt một nhiệm vụ hay phong cách cụ thể. Hai kỹ thuật có thể kết hợp, ví dụ trong QLoRA.
Quantization có giảm KV cache không?
Lượng tử hoá chỉ trọng số không làm KV cache nhỏ đi. Một số engine hỗ trợ lượng tử hoá riêng KV cache, nhưng đó là cấu hình khác và cần kiểm tra chất lượng riêng, đặc biệt với ngữ cảnh dài.
Chạy mô hình 70B trên một GPU có được không?
Về bộ nhớ trọng số thì có thể: INT4 khoảng 35 đến 45 GB, vừa GPU 80 GB, và một số bản cấu hình cho GPU 24 GB còn phải đẩy bớt lớp sang RAM, làm chậm đáng kể. Khả năng thực tế còn phụ thuộc KV cache, số người dùng cùng lúc và yêu cầu tốc độ.
Nên lượng tử hoá bằng PTQ hay QAT?
Với phần lớn doanh nghiệp dùng mô hình có sẵn, PTQ là lựa chọn thực tế vì không cần huấn luyện lại. QAT phù hợp khi bạn tự huấn luyện hoặc tinh chỉnh mô hình, có hạ tầng GPU, và cần giữ chất lượng ở mức bit rất thấp.
VBPO cập nhật tin tức và kiến thức công nghệ cho doanh nghiệp Việt Nam. Xem thêm các bài cùng chuyên mục AI tạo sinh & LLM.