
Trả lời nhanh: QLoRA (Quantized Low-Rank Adaptation) là kỹ thuật tinh chỉnh mô hình ngôn ngữ lớn bằng cách nén mô hình gốc xuống 4-bit, đóng băng nó, rồi chỉ huấn luyện các adapter LoRA nhỏ. Nhờ vậy, bộ nhớ GPU cần dùng giảm mạnh mà chất lượng vẫn gần với tinh chỉnh 16-bit.
Điểm chính
- QLoRA do Tim Dettmers và cộng sự công bố năm 2023, là LoRA chạy trên mô hình gốc đã lượng tử hoá 4-bit.
- Ba cải tiến cốt lõi: kiểu dữ liệu NF4, Double Quantization và Paged Optimizers.
- Bài báo gốc tinh chỉnh được mô hình 65 tỷ tham số trên một GPU 48GB.
- QLoRA tiết kiệm VRAM, không tiết kiệm công chuẩn bị dữ liệu và đánh giá.
- Phù hợp khi muốn đổi phong cách, định dạng, hành vi của mô hình; không thay cho RAG khi cần tra cứu kiến thức mới.
Mục lục
- QLoRA là gì?
- QLoRA hoạt động thế nào?
- Ba cải tiến kỹ thuật của QLoRA là gì?
- QLoRA tiết kiệm bao nhiêu bộ nhớ GPU?
- QLoRA khác LoRA và tinh chỉnh đầy đủ ở đâu?
- Ví dụ thực tế về QLoRA
- Doanh nghiệp Việt Nam áp dụng QLoRA vào đâu?
- Cần chuẩn bị gì để chạy QLoRA?
- Ưu điểm và nhược điểm của QLoRA
- Khi nào nên và không nên dùng QLoRA?
- Câu hỏi thường gặp
QLoRA là gì?
QLoRA là phương pháp tinh chỉnh hiệu quả tham số (parameter-efficient fine-tuning, PEFT) cho mô hình ngôn ngữ lớn. Tên đầy đủ là Quantized Low-Rank Adaptation. Theo bài báo “QLoRA: Efficient Finetuning of Quantized LLMs” (Dettmers, Pagnoni, Holtzman, Zettlemoyer; arXiv 2305.14314, trình bày tại NeurIPS 2023), QLoRA lan truyền ngược gradient qua một mô hình đã lượng tử hoá 4-bit và bị đóng băng, vào các Low Rank Adapter (LoRA).
Nói đơn giản, có hai nửa ghép lại:
- Nửa lưu trữ: trọng số mô hình gốc được nén xuống 4-bit để chiếm ít VRAM, và không bị thay đổi trong quá trình huấn luyện.
- Nửa học: chỉ các ma trận adapter nhỏ gắn vào từng lớp được cập nhật, với độ chính xác cao hơn (thường là bfloat16).
Vì vậy QLoRA không phải là một mô hình hay một sản phẩm. Đó là một công thức huấn luyện. Kết quả cuối cùng là một tệp adapter đi kèm mô hình gốc.
Nếu bạn chưa rõ LoRA, hãy đọc trước bài LoRA là gì. Nếu cần bức tranh rộng hơn về việc dạy lại mô hình, xem bài tinh chỉnh mô hình AI. Bài này chỉ tập trung vào phần QLoRA bổ sung.
QLoRA hoạt động thế nào?
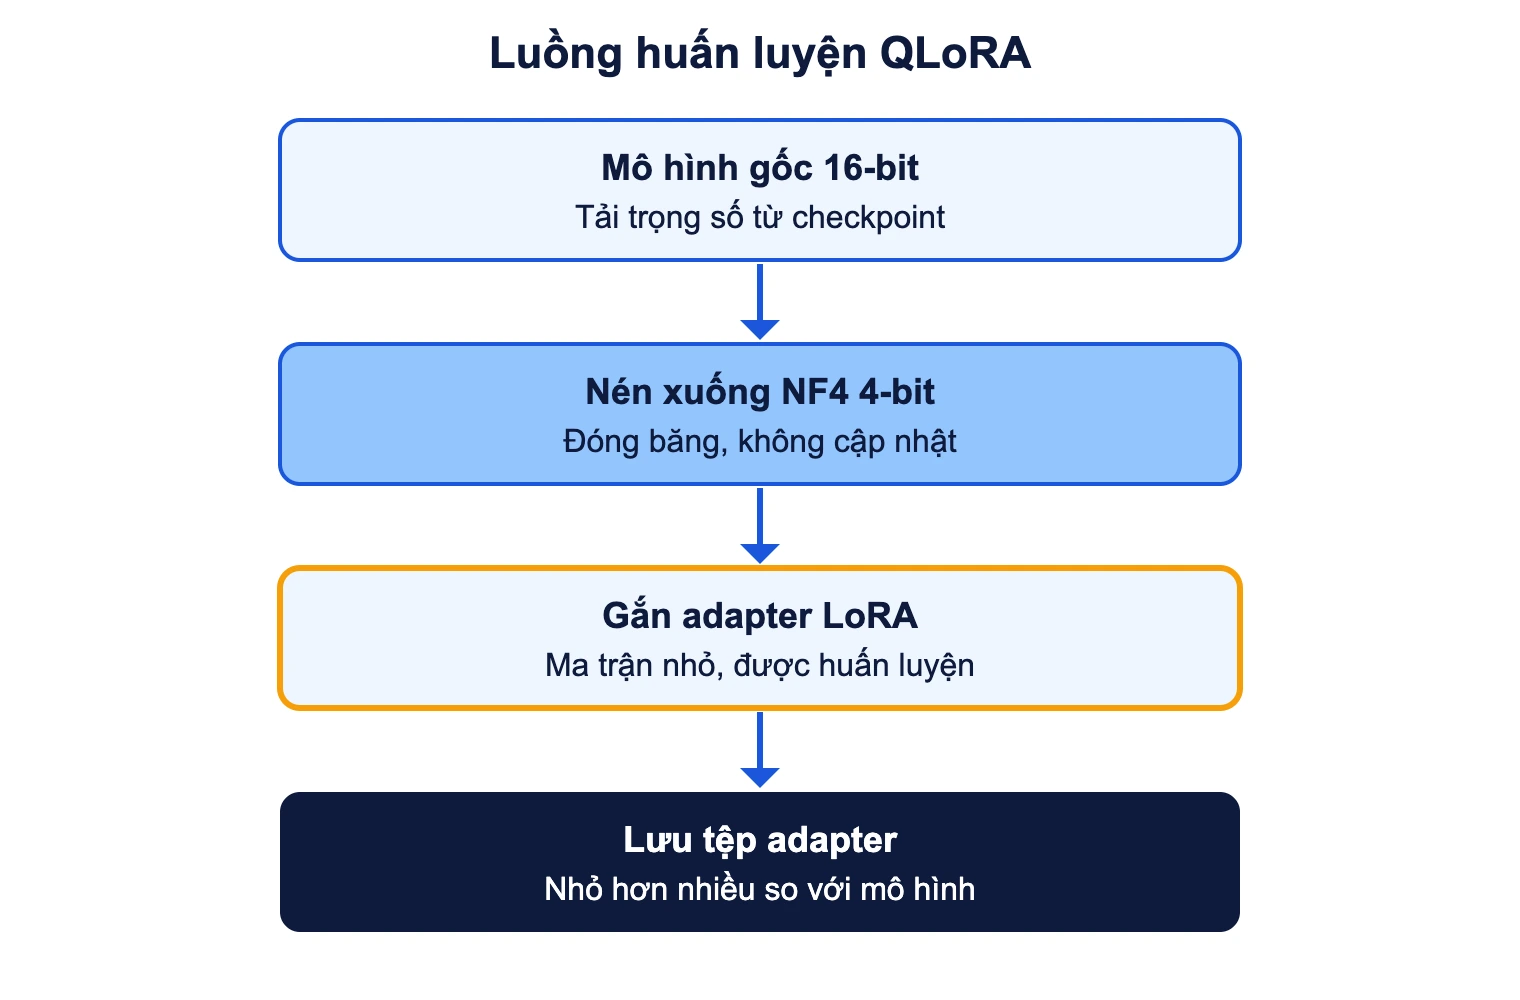
Quy trình một lần huấn luyện QLoRA gồm bốn bước: tải mô hình, nén, gắn adapter, huấn luyện. Điểm mấu chốt là hai loại độ chính xác cùng tồn tại. Trọng số gốc được lưu ở 4-bit. Khi tính toán, từng khối được giải nén tạm thời sang độ chính xác cao hơn để chạy qua lớp, còn gradient chỉ được dùng để cập nhật adapter.
Ba cải tiến kỹ thuật của QLoRA là gì?
Nén 4-bit đơn thuần đã có từ trước. Đóng góp của bài báo là làm cho việc huấn luyện trên nền 4-bit không làm hỏng chất lượng. Có ba thành phần.
4-bit NormalFloat (NF4)
Trọng số mạng nơ-ron thường phân bố gần dạng chuẩn (hình chuông). NF4 chọn 16 mức giá trị 4-bit sao cho khớp phân bố đó, thay vì chia đều như Int4 hay FP4. Các tác giả mô tả đây là kiểu dữ liệu tối ưu theo lý thuyết thông tin cho trọng số phân bố chuẩn. Trong thí nghiệm của họ, NF4 kèm double quantization cho kết quả MMLU ngang BFloat16, còn FP4 luôn kém khoảng một điểm phần trăm.
Double Quantization (DQ)
Lượng tử hoá theo khối cần lưu thêm các hằng số tỷ lệ (quantization constants) cho mỗi khối. Double Quantization nén luôn các hằng số này. Theo một bản tóm tắt bài báo, cách này tiết kiệm khoảng 0,37 bit mỗi tham số, tương đương khoảng 3 GB với mô hình 65B. Bài báo gốc nhận xét mức cải thiện chất lượng chỉ nhỏ, nhưng DQ giúp kiểm soát chi tiết dung lượng bộ nhớ để mô hình cỡ 33B và 65B vừa với GPU 24GB và 48GB.
Paged Optimizers
Khi dùng gradient checkpointing với lô dữ liệu có chuỗi dài, bộ nhớ có thể tăng vọt và gây lỗi hết bộ nhớ (out-of-memory). Paged Optimizers dùng bộ nhớ hợp nhất (unified memory) của NVIDIA để đẩy trạng thái bộ tối ưu sang RAM CPU khi VRAM sắp đầy, rồi nạp lại khi cần. Các tác giả cho biết với mô hình 65B trên GPU 48GB và batch size 16, tốc độ huấn luyện tương đương bộ tối ưu thông thường.
Bài báo cũng ghi nhận việc gắn LoRA vào tất cả các lớp transformer là yếu tố quan trọng để đạt chất lượng ngang 16-bit. Chỉ gắn vào một số ma trận attention thường cho kết quả kém hơn.
QLoRA tiết kiệm bao nhiêu bộ nhớ GPU?
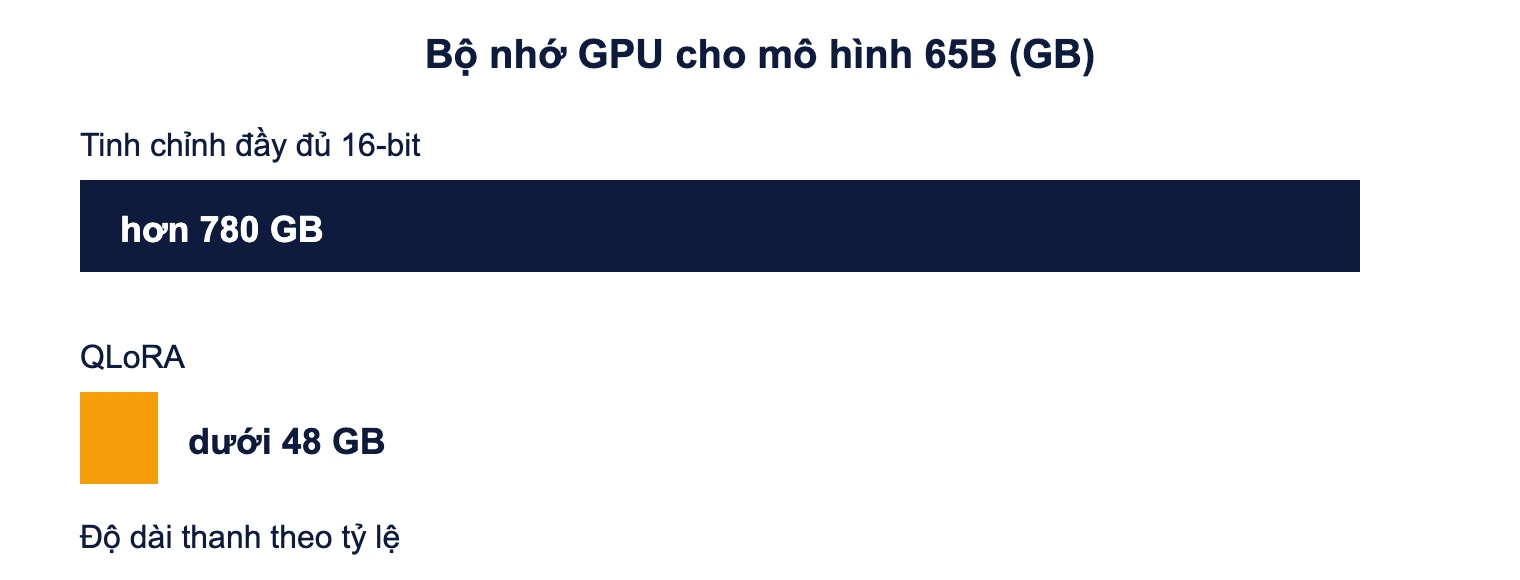
Con số được trích nhiều nhất đến từ chính bài báo: yêu cầu bộ nhớ trung bình để tinh chỉnh mô hình 65B giảm từ hơn 780GB xuống dưới 48GB, mà không làm giảm tốc độ hay chất lượng so với bản tinh chỉnh đầy đủ 16-bit.
Để tự ước lượng, bạn có thể tính phần trọng số theo công thức: số tham số nhân với số byte mỗi tham số. Đây là phép tính minh hoạ, chỉ tính trọng số, chưa tính activation, trạng thái bộ tối ưu và adapter:
- Mô hình 7B ở 16-bit (2 byte/tham số): khoảng 14GB. Ở 4-bit (0,5 byte): khoảng 3,5GB.
- Mô hình 65B ở 4-bit: khoảng 32,5GB, nên vừa với GPU 48GB nhưng còn ít chỗ cho activation. Đó là lý do cần Paged Optimizers.
Mức thực tế luôn cao hơn phép tính này, và phụ thuộc độ dài chuỗi, batch size và việc bật gradient checkpointing. Hãy đo trên đúng cấu hình của bạn thay vì tin vào ước lượng.
QLoRA khác LoRA và tinh chỉnh đầy đủ ở đâu?
| Tiêu chí | Tinh chỉnh đầy đủ | LoRA | QLoRA |
|---|---|---|---|
| Phần được cập nhật | Toàn bộ trọng số | Adapter hạng thấp | Adapter hạng thấp |
| Trọng số gốc khi huấn luyện | 16/32-bit, cập nhật | 16-bit, đóng băng | 4-bit (NF4), đóng băng |
| Nhu cầu VRAM | Cao nhất | Thấp hơn nhiều | Thấp nhất |
| Tốc độ mỗi bước | Cơ sở | Nhanh hơn đầy đủ | Thường chậm hơn LoRA do bước giải nén |
| Rủi ro mất chất lượng do nén | Không | Không | Có, cần kiểm tra |
| Đầu ra | Mô hình mới hoàn chỉnh | Tệp adapter | Tệp adapter |
Hàng về tốc độ là quy luật chung: giải nén 4-bit trong lúc tính toán thêm việc cho GPU, nên QLoRA thường đổi thời gian lấy bộ nhớ. Nếu GPU của bạn đủ chứa mô hình 16-bit, LoRA thường là lựa chọn đơn giản hơn. QLoRA có giá trị nhất khi VRAM là điểm nghẽn.
Cũng đừng nhầm QLoRA với việc lượng tử hoá mô hình để chạy suy luận. Hai việc dùng chung ý tưởng nén, nhưng QLoRA nén để huấn luyện adapter, còn lượng tử hoá cho suy luận nhằm phục vụ mô hình đã huấn luyện xong.
Ví dụ thực tế về QLoRA
Ví dụ công khai nổi tiếng nhất là họ mô hình Guanaco do chính nhóm tác giả tạo ra bằng QLoRA. Theo bài báo, Guanaco đạt 99,3% hiệu năng của ChatGPT trên bộ đánh giá Vicuna, chỉ cần 24 giờ tinh chỉnh trên một GPU. Cần đọc con số này đúng bối cảnh: đó là đánh giá hội thoại dùng mô hình chấm điểm, không đảm bảo chất lượng trên tác vụ riêng của doanh nghiệp bạn. Về phương pháp tiếp cận đánh giá, bài benchmark LLM giải thích vì sao điểm chuẩn chung dễ gây hiểu nhầm.
Ví dụ minh hoạ (giả định) cho doanh nghiệp: một công ty logistics muốn mô hình mã nguồn mở cỡ 7–8B trả lời email khách hàng theo đúng giọng điệu và biểu mẫu nội bộ. Họ có vài nghìn email đã được nhân viên duyệt và ẩn thông tin cá nhân. Mục tiêu không phải dạy mô hình thêm kiến thức, mà dạy cách trả lời: câu mở đầu, cấu trúc, cách từ chối lịch sự. Đây đúng là loại việc QLoRA làm tốt trên một GPU đơn.
Doanh nghiệp Việt Nam áp dụng QLoRA vào đâu?
QLoRA phù hợp với các việc mà hành vi của mô hình cần thay đổi, chứ không phải kho tài liệu cần được tra cứu:
- Ép đầu ra theo định dạng cố định, như JSON hoặc mẫu biên bản, để hệ thống phía sau đọc được.
- Điều chỉnh văn phong tiếng Việt theo ngành, như thư hành chính, tư vấn chăm sóc khách hàng.
- Phân loại, trích xuất thông tin từ văn bản đặc thù (hợp đồng, phiếu yêu cầu) khi mô hình gốc làm chưa ổn.
- Thu nhỏ chi phí bằng cách đưa một mô hình cỡ vừa lên đủ tốt cho một tác vụ hẹp, thay vì gọi mô hình lớn trả phí theo lượt. Bạn có thể xem thêm bài mô hình ngôn ngữ mã nguồn mở để chọn mô hình nền, nhớ kiểm tra giấy phép sử dụng thương mại.
Nếu nhu cầu thật là hỏi đáp trên tài liệu nội bộ thay đổi hằng tuần, hãy cân nhắc RAG trước. Tinh chỉnh dạy mô hình thói quen, RAG đưa tài liệu đúng lúc vào câu hỏi. Kiến thức nhúng vào trọng số khó cập nhật và khó chỉ ra nguồn. Nhiều hệ thống kết hợp cả hai: QLoRA cho giọng điệu và định dạng, RAG cho nội dung.
Về dữ liệu huấn luyện: nếu tập dữ liệu chứa thông tin khách hàng, bạn nên ẩn danh hoá trước khi đưa vào huấn luyện, vì mô hình có thể ghi nhớ và lặp lại đoạn văn bản đã thấy.
Cần chuẩn bị gì để chạy QLoRA?
Dữ liệu
Chất lượng tập dữ liệu quyết định phần lớn kết quả. Bài báo gốc nhận định rằng tập nhỏ nhưng chất lượng cao có thể thắng tập lớn nhưng nhiễu cho tác vụ làm theo chỉ dẫn. Với doanh nghiệp, điều này nghĩa là vài trăm đến vài nghìn cặp câu hỏi và câu trả lời đã được người có chuyên môn duyệt thường hữu ích hơn hàng chục nghìn bản ghi chưa lọc.
Phần mềm
Hệ sinh thái phổ biến gồm thư viện bitsandbytes (nén 4-bit), PEFT (quản lý adapter) và TRL hoặc Transformers của Hugging Face (vòng lặp huấn luyện). Các thư viện này thay đổi phiên bản thường xuyên, nên hãy đọc tài liệu chính thức của đúng phiên bản bạn dùng.
Cấu hình hay gặp
Ba tham số bạn sẽ chỉnh nhiều nhất là hạng r của adapter, hệ số alpha và học suất. Bài báo ghi cấu hình thí nghiệm dùng NF4 kèm double quantization, tính toán bằng bf16, trong đó có các thiết lập như r = 64 và alpha = 16. Hãy coi đó là điểm tham chiếu, không phải giá trị bắt buộc.
Các lỗi thường gặp và cách xử lý:
- Hết VRAM giữa chừng: giảm độ dài chuỗi tối đa, giảm batch size và tăng gradient accumulation, bật gradient checkpointing, dùng paged optimizer.
- Mô hình nói đúng giọng nhưng sai nội dung: thường là dấu hiệu dữ liệu huấn luyện không chứa thông tin cần thiết. Đây là lúc cần RAG chứ không phải thêm vòng huấn luyện.
- Mô hình lặp lại hoặc “thuộc lòng” dữ liệu: giảm số epoch, tách tập kiểm tra riêng và theo dõi loss trên tập này.
- Chất lượng tụt sau khi gộp adapter vào mô hình: mô hình gốc đã bị nén lúc huấn luyện nên cần chạy lại bộ kiểm tra sau khi gộp, hoặc giữ adapter tách rời khi phục vụ.
Việc tích hợp huấn luyện, lưu phiên bản adapter và triển khai vào hệ thống thuộc phạm vi MLOps. Mỗi adapter nên gắn với phiên bản mô hình gốc, tập dữ liệu và bộ kiểm tra đã dùng.
Ưu điểm và nhược điểm của QLoRA
| Ưu điểm | Nhược điểm |
|---|---|
| Hạ ngưỡng VRAM, cho phép tinh chỉnh mô hình lớn trên một GPU | Chậm hơn LoRA 16-bit trên cùng phần cứng do giải nén liên tục |
| Adapter nhỏ, dễ lưu nhiều phiên bản cho nhiều tác vụ | Mô hình gốc bị nén nên có thể mất một phần chất lượng, cần đo lại |
| Chất lượng trong bài báo gốc gần 16-bit trên các bộ đánh giá đã thử | Kết quả của bài báo chưa chắc áp dụng cho tiếng Việt và tác vụ riêng của bạn |
| Dữ liệu và mô hình có thể nằm trong hạ tầng của doanh nghiệp | Không giải quyết bài toán dữ liệu kém, cũng không chống được ảo giác |
Về điểm cuối cùng, tinh chỉnh có thể giảm một số lỗi về định dạng nhưng không loại bỏ việc bịa thông tin. Bài ảo giác AI phân tích các nguyên nhân và cách giảm.
Khi nào nên và không nên dùng QLoRA?
Nên cân nhắc QLoRA nếu
- Mô hình nền đã gần đạt yêu cầu, nhưng sai giọng điệu, sai định dạng hoặc sai cách phân loại.
- Bạn có GPU 24GB hoặc 48GB và muốn dùng mô hình cỡ 13B đến 70B thay vì chỉ cỡ nhỏ.
- Dữ liệu không được phép rời hạ tầng nội bộ.
- Cần nhiều biến thể cho nhiều đơn vị, mỗi biến thể là một adapter riêng nhỏ gọn.
Nên chọn hướng khác nếu
- Bạn cần tra cứu thông tin thay đổi liên tục: dùng RAG.
- GPU đủ chứa mô hình 16-bit và bạn ưu tiên tốc độ: dùng LoRA thường.
- Tác vụ chỉ cần viết lại câu lệnh cho tốt hơn: thử cải thiện prompt trước, tham khảo bài cách viết prompt.
- Bạn muốn thay đổi sâu năng lực nền, ví dụ dạy một ngôn ngữ mới hoàn toàn: adapter nhỏ thường không đủ, cần huấn luyện tiếp (continued pretraining) hoặc tinh chỉnh đầy đủ.
Câu hỏi thường gặp
QLoRA có phải là một mô hình AI không?
Không. QLoRA là phương pháp huấn luyện. Bạn áp dụng nó lên một mô hình nền có sẵn, như một mô hình mã nguồn mở, và thu được tệp adapter chứa phần thay đổi đã học.
QLoRA khác LoRA ở điểm nào quan trọng nhất?
LoRA giữ mô hình gốc ở 16-bit và chỉ huấn luyện adapter. QLoRA nén mô hình gốc xuống 4-bit bằng NF4 trước khi gắn adapter, nên cần ít VRAM hơn nhưng thường chạy chậm hơn mỗi bước và cần kiểm tra lại chất lượng sau khi nén.
Chữ “Q” trong QLoRA là gì?
Q là Quantized, nghĩa là lượng tử hoá: giảm số bit dùng để lưu mỗi trọng số. Trong QLoRA, trọng số gốc được lưu ở 4-bit.
Có cần GPU 48GB mới chạy được QLoRA không?
Không. Mốc 48GB trong bài báo dành cho mô hình 65B. Mô hình nhỏ hơn cần ít hơn nhiều; bài báo cũng nêu GPU 24GB đủ cho cỡ 33B. Mức cụ thể phụ thuộc độ dài chuỗi và batch size, nên hãy thử trên cấu hình thật.
QLoRA có thay thế được RAG không?
Thường là không. QLoRA thay đổi cách mô hình trả lời, còn RAG cung cấp tài liệu cập nhật cho từng câu hỏi và cho phép dẫn nguồn. Hai kỹ thuật bổ sung cho nhau chứ không thay nhau.
Dùng dữ liệu khách hàng để huấn luyện QLoRA có vi phạm pháp luật không?
Bài viết thuộc chuyên mục AI tạo sinh & LLM trên blog công nghệ VBPO, trang tin tức và kiến thức công nghệ cho doanh nghiệp Việt Nam về AI, dữ liệu, blockchain, chuyển đổi số và tự động hoá.